RetractorDB
RetractorDB to brzegowy silnik przetwarzania sygnałów (ang. Edge Signal Processing Engine, ESPE), przeznaczony do ciągłego przetwarzania regularnych serii czasowych blisko źródła danych. Za pomocą deklaratywnego języka RQL opisuje przekształcenia, agregacje i reguły, a ich wyniki udostępnia na żywo lub materializuje w postaci artefaktów, które można później przeglądać i korygować. System wspiera centralne bazy szeregów czasowych i systemy strumieniowe, ograniczając ilość przesyłanych do nich danych, lecz ich nie zastępuje.
Nazwa odzwierciedla połączenie dwóch idei. Retractor oznacza narzędzie, które wydobywa, rozdziela, łączy i przetwarza dane zawarte w seriach czasowych, natomiast człon DB wskazuje na rozwiązania znane z baz danych: deklaratywny język zapytań, opis schematu, mechanizmy dostępu oraz trwałe przechowywanie wyników. Więcej o pochodzeniu nazwy można przeczytać w rozdziale Dlaczego wybrano taką nazwę dla systemu?.
Dokumentacja prowadzi od podstaw matematycznych i konstrukcji języka RQL, przez architekturę systemu, kompilację i realizację zapytań, aż po przykłady zastosowań oraz załączniki z opisem narzędzi. Przy pierwszym kontakcie najlepiej czytać rozdziały w kolejności podanej w spisie treści, ponieważ kolejne części korzystają z pojęć wprowadzonych wcześniej. Czytelnik szukający konkretnego rozwiązania może przejść bezpośrednio do odpowiedniego rozdziału, a następnie skorzystać z przykładów i załączników jako materiału praktycznego i referencyjnego.
RetractorDB na tle sąsiednich dziedzin
Ten rozdział jest mapą, nie katalogiem. Zamiast wyliczać wszystko, co kiedykolwiek napisano o strumieniach i sygnałach, pokazuję osiem nurtów literatury badawczej, na styku których leży RetractorDB, i dla każdego z nich odpowiadam na trzy pytania: co ten nurt już rozwiązał, w czym RetractorDB się od niego różni i czego ten nurt nie dotyka. Dopiero ich zestawienie pokazuje lukę, którą ten projekt wypełnia.
📥 Pobierz dokumentację
Ta dokumentacja w całości jest kompilowana z plików w formacie markdown. Kopilowane są 3 cele. Pierwszy to strona html, którą teraz widzisz. Drugi to plik pdf, trzeci to dokument epub na czytnik. Za każdym razem po zmianie zawartości repozytorium na github gdzie przechowywane są pliki markdown uruchamiany jest proces tworzący te 3 cele.
✅ Uwaga
Ten system to: Edge Signal Processing Engine (Brzegowy System Przetwarzania Sygnałów). RetractorDB wspiera – a nie zastępuje – bazy szeregów czasowych (TSDB) i strumieniowe systemy zarządzania danymi (DSMS): pracuje blisko źródła sygnału, wstępnie przetwarza i filtruje wysokoczęstotliwościowe pomiary za pomocą deklaratywnego języka zapytań, utrzymuje częściowy, korygowalny zapis zdarzeń przeszłych i zaplanowanych przyszłych w inspekcjonowalnych artefaktach, a w górę architektury przekazuje dokładne, deterministyczne wyniki – tak, aby do centralnej architektury docierały wyłącznie zredukowane, już przetworzone strumienie.
ℹ️ Info
Dlaczego umieściłem ten rozdział tak wcześnie? Bo uczciwa odpowiedź na pytanie „czy to jest potrzebne?“ wymaga najpierw pokazania, co już istnieje. Większość pomysłów w informatyce została już raz pomyślana – wymyślanie koła na nowo to marnowanie cudzego wysiłku. Ten rozdział jest moją próbą udowodnienia, że akurat tego koła jeszcze nie wynaleziono.
Osiem sąsiednich dziedzin
Problem, który rozwiązuje RetractorDB, nie należy w całości do żadnej pojedynczej dyscypliny. Leży na styku ośmiu nurtów:
-
1. Teoria liczb
Sekwencje Beatty’ego, twierdzenie Fraenkela, układy pokrywające. To dostarcza fundamentu formalnego.
-
2. Szeregowanie zadań przez sekwencje Beatty’ego
Ta sama matematyka, inne zastosowanie. Najbliższy sąsiad aplikacyjny.
-
3. Synchroniczny i cykliczno-statyczny przepływ danych (SDF/CSDF)
Wielotempowe grafy aktorów, statyczne harmonogramy i rozmiary buforów.
-
4. Języki synchroniczne i rachunki zegarów
Deklaratywne zależności między okresowymi strumieniami oraz kompilacyjne wyznaczanie opóźnień.
-
5. Cyfrowe przetwarzanie sygnałów (DSP)
Próbkowanie niejednorodne i banki filtrów o wymiernych współczynnikach. To DSP-owy odpowiednik operacji przeplotu.
-
6. Strumieniowe systemy zarządzania danymi (DSMS)
Algebry strumieni i semantyka zapytań ciągłych. To bazodanowy punkt odniesienia.
-
7. Współdzielenie wielu zapytań i stanu
Ponowne wykorzystanie obliczeń, indeksów i materializacji przez kilka planów.
-
8. Systemy szeregów czasowych (TSMS) i DSP wewnątrz bazy
Najwęższa nisza, najbliższa właściwemu celowi systemu.
Omawiam je kolejno, od fundamentu ku zastosowaniu.
Teoria liczb: sekwencje Beatty’ego i układy pokrywające (1)
Cała algebra RetractorDB stoi na sekwencji Beatty’ego i jej uogólnieniu przez Fraenkela na liczby wymierne. Te wyniki przytaczam w Formalnych podstawach i dowodach. Tutaj interesuje mnie szersze tło: jak ta matematyka funkcjonuje we współczesnej literaturze i czy ktoś zastosował ją już tam, gdzie ja.
Sekwencje Beatty’ego mają bogatą literaturę kombinatoryczną oraz udokumentowane zastosowania w nieperiodycznych parkietażach (kwazikryształy), szeregowaniu okresowym, widzeniu komputerowym (linie cyfrowe) i teorii języków formalnych [11]. Nurt jest żywy: Schaeffer, Shallit i Zorcic (2024) wykazali, że niejednorodna sekwencja Beatty’ego jest synchronizowalna automatem skończonym, co prowadzi do rozstrzygalności teorii pierwszego rzędu tych sekwencji [12]. Dla mnie najistotniejsza jest jednak praca Bergera, Felzenbauma i Fraenkela (1986) o rozłącznych układach pokrywających opartych na wymiernych sekwencjach Beatty’ego [13] – to dokładnie ten wariant, na którym opieram rozplątanie, a którego w pierwotnej pracy nie przywołałem.
Czego ten nurt nie dotyka: teoria liczb bada te sekwencje jako obiekty matematyczne. Nie łączy ich z bazą danych, z modelem przetwarzania strumieni ani z przetwarzaniem sygnałów. Dostarcza cegieł, nie budowli.
Szeregowanie zadań przez sekwencje Beatty’ego (2)
To jest nurt, który muszę omówić najuczciwiej, bo używa tej samej maszynerii dowodowej co moje twierdzenia – tyle że w innym celu. W problemie szeregowania okresowego (ang. pinwheel scheduling) zadania o różnych okresach powtarzania rozdziela się tak, że zadania o jednym czasie powtórzeń trafiają w sloty czasowe należące do pierwszej komplementarnej sekwencji Beatty’ego, a o drugim – do drugiej [14]. Świeże prace (2025) prowadzą dowody na podziale Rayleigha/Beatty’ego z tożsamościami na funkcjach podłogi i sufitu typu ⌈(m+l)a⌉ − ⌈ma⌉ [15] – niemal kropka w kropkę aparat z mojego dowodu, że rozplątanie spełnia postulaty Fraenkela.
Wniosek jest dla mnie podwójny. Z jednej strony – to niezależne potwierdzenie, że podejście jest poprawne i naturalne; skoro ktoś dochodzi tą samą drogą do działającego szeregowania, fundament jest solidny. Z drugiej – to zawęża to, co mogę nazwać nowością. „Sekwencje Beatty’ego do szeregowania“ już istnieją i są aktywnie publikowane. Co ciekawe, mój system używa tej matematyki wewnętrznie właśnie do szeregowania zadań (patrz Realizacja zapytań) – ale to nie tu leży wkład oryginalny.
Czego ten nurt nie dotyka: szeregowanie traktuje sekwencje jako narzędzie przydziału slotów czasowych procesorom. Nie buduje na nich algebry danych, nie wyraża nimi operacji na sygnałach, nie tworzy języka zapytań.
Synchroniczny i cykliczno-statyczny przepływ danych (SDF/CSDF) (3)
W SDF aktorzy zużywają i wytwarzają z góry znane liczby znaczników, dzięki czemu można przed uruchomieniem wyznaczyć harmonogram grafu [26]. CSDF rozszerza ten model o cyklicznie zmieniające się proporcje produkcji i konsumpcji oraz pozwala wyznaczać statyczne harmonogramy i ograniczenia buforów [27]. Jest to dojrzały model deklaratywnego, wielotempowego przepływu danych, więc sama analiza częstotliwości ani statyczne szeregowanie nie są cechami swoistymi RetractorDB.
SDF/CSDF potrafi opisać pokrewne zachowanie wielotempowe, co uzasadnia ocenę „częściowo” przy bezstratnym podziale próbek. Podział Beatty’ego nie jest tam jednak osobnym operatorem semantycznym. RetractorDB osadza taki operator w języku zapytań i łączy go z trwałymi wynikami.
Czego ten nurt nie dotyka: SDF/CSDF nie definiuje tej konkretnej, bezstratnej partycji pozycji próbek jako semantyki systemu zapytań ani modelu inspekcji i odtwarzania artefaktów.
Języki synchroniczne i rachunki zegarów (4)
Języki synchroniczne opisują okresowe strumienie za pomocą zegarów i potrafią podczas kompilacji sprawdzać ich zgodność oraz wyznaczać potrzebne bufory i opóźnienia. W modelach n-synchronicznych relacje między zegarami mogą mieć wymierne proporcje, a część obowiązków związanych z synchronizacją przejmuje kompilator [28]. To jeden z najbliższych punktów odniesienia dla deklaratywnej granicy RetractorDB.
Różni się jednak przedmiot opisu: zegar zwykle określa obecność wartości w logicznych taktach programu, natomiast RetractorDB przypisuje regularnemu strumieniowi wymierny interwał i na tej podstawie tworzy jeden uporządkowany strumień z dwóch wejść.
Czego ten nurt nie dotyka: rachunki zegarów służą przede wszystkim do kompilacji programów reaktywnych. Nie przenoszą tej semantyki do silnika zapytań z publicznymi deskryptorami oraz trwałymi, odtwarzalnymi artefaktami.
Cyfrowe przetwarzanie sygnałów: próbkowanie niejednorodne i banki filtrów (5)
Przeplot i rozplątanie spotykają się z DSP w zagadnieniu pracy na strumieniach o różnych częstotliwościach próbkowania, ale nie są po prostu kolejną metodą rekonstrukcji sygnału. Najbliższym pomostem jest praca Samadiego, Ahmada i Swamy’ego (2004), która formułuje warunek perfekcyjnej rekonstrukcji niejednorodnych banków filtrów na podstawie odpowiedzi układu na opóźnione sygnały skoku jednostkowego [16]. Szerszy nurt obejmuje próbkowanie okresowo-niejednorodne sygnałów pasmowo ograniczonych [17] oraz banki filtrów o wymiernych współczynnikach decymacji (Kovačević i Vetterli) [18].
Pojawiają się tam nawet konstrukcje teorioliczbowe: banki filtrów Ramanujana wydobywają składowe okresowe sygnału [19]. Ale akurat sekwencji Beatty’ego ani twierdzenia Fraenkela w tej literaturze nie znalazłem – i to jest część luki.
Czego ten nurt nie dotyka: przywołane metody DSP rekonstruują albo przekształcają wartości sygnału. Nie definiują konkretnego przeplotu pozycji próbek opartego na sekwencjach Beatty’ego ani nie osadzają go w silniku zapytań wytwarzającym artefakty.
Strumieniowe systemy zarządzania danymi (DSMS) (6)
Po stronie bazodanowej kanonem jest CQL ze stanfordzkiego projektu STREAM (Arasu, Babu, Widom). W tym modelu strumień to potencjalnie nieskończony wielozbiór elementów ⟨s, τ⟩, gdzie s jest krotką, a τ stemplem czasowym [20]; semantykę zapytań buduje się na oknach i odwzorowaniach strumień↔relacja. Drugim bliskim sąsiadem jest temporalna algebra Krämera i Seegera (system PIPES), zapewniająca deterministyczne wyniki zapytań ciągłych oraz bogaty zbiór reguł transformacji stanowiących podstawę optymalizacji [21].
To jest właściwy punkt odniesienia dla mojej algebry i moich reguł przepisywania wyrażeń. Różnica jest jednak fundamentalna i dotyczy samego modelu danych. CQL i PIPES budują semantykę na modelu (s, τ) – każda krotka nosi własny stempel czasowy, a operatory działają przez okna. Ja przyjmuję model różnicowy (sₙ, Δ) z wymierną, stałą wartością Δ na strumień, a operatory wyrównujące strumienie o różnych Δ wyprowadzam z teorii liczb. To nie jest kosmetyczna różnica w składni – to inny model danych, prowadzący do innej klasy operatorów (przeplot, rozplątanie) i innej metody optymalizacji.
W kategoriach wdrożeniowych relacja jest przy tym komplementarna, nie konkurencyjna: RetractorDB działa jako brzegowy stopień wstępnego przetwarzania i buforowania, którego dokładne, deterministyczne wyniki mogą zasilać okienkowy DSMS.
Czego ten nurt nie dotyka: DSMS obejmują zarówno semantyki deterministyczne, jak i mechanizmy skalowania, okien, tolerancji na nieuporządkowanie oraz obsługi stanu. Przywołane systemy nie definiują jednak konkretnego, bezstratnego podziału pozycji regularnych próbek opartego na sekwencjach Beatty’ego ani nie używają teorii liczb jako semantyki resamplingu.
Współdzielenie wielu zapytań i stanu (7)
Optymalizacja wielu zapytań od dawna wykorzystuje wspólne fragmenty planów. Nowsze systemy strumieniowe współdzielą także utrzymywane indeksy i stan między równoległymi przepływami [29], a normalizacja semantyczna pozwala łączyć zapytania różniące się składnią lub strukturą planu [30]. Automatyczne współdzielenie nie jest zatem samo w sobie nowym wkładem RetractorDB.
W RetractorDB to zagadnienie dotyczy materializowanych strumieni pośrednich. Kompilator może je współdzielić dopiero po normalizacji planu i sprawdzeniu zgodności semantyki regularnych serii. Jest to bliskie istniejącym mechanizmom współdzielonego stanu, choć kryterium zgodności wynika tu z modelu częstotliwości strumieni.
Czego ten nurt nie dotyka: przywołane metody nie wykorzystują wyrównania częstotliwości i podziału Beatty’ego do normalizacji planu przed decyzją o współdzieleniu. Szczegółowe granice tego porównania wykraczają poza zakres dokumentacji systemu.
Systemy szeregów czasowych (TSMS) i DSP wewnątrz bazy (8)
To najwęższa nisza – i najbliższa właściwemu celowi RetractorDB. Kanoniczny przegląd to praca Jensena, Pedersena i Thomsena „Time Series Management Systems: A Survey“ (IEEE TKDE, 2017) [22]. Opisany tam system Plato jest najbliższym prawdziwym „DSP wewnątrz bazy“: łączy RDBMS z metodami przetwarzania sygnałów, eliminując potrzebę eksportu danych do narzędzi zewnętrznych typu R czy SPSS [22]. Pozostałe podejścia do „sygnałów w bazie“ sprowadzają się do aproksymacji i kompresji – reprezentacje falkowe, słownikowe, kształtowe.
Podejścia te koncentrują się na aproksymacji, kompresji albo analizie po fakcie. Nie czynią z przeplotu pozycji próbek opartego na sekwencjach Beatty’ego operatora pierwszej klasy wewnątrz algebry zapytań. RetractorDB nie konkuruje z nimi skalą ingestii czy retencją: działa przed systemem centralnym i dostarcza mu deterministyczne wyniki oraz korygowalne artefakty.
Czego ten nurt nie dotyka: TSMS optymalizują skalę ingestii, kompresję i retencję. DSP jest w nich obywatelem drugiej kategorii – dodatkiem analitycznym, nie rdzeniem semantyki.
Biała plama: gdzie leży wkład
Poniższa tabela jest jakościową mapą możliwości, a nie dowodem pierwszeństwa ani kompletności przeglądu. Ostatnia kolumna dotyczy oceny opartej na inspekcjonowalnych artefaktach lub odtwarzaniu, nie samego zapisu danych. „Częściowo” oznacza zdolność pokrewną, nie równoważność semantyczną.
| Dziedzina | Beatty/Fraenkel | Bezstratny podział próbek | Deklaratywny przepływ danych | Ocena przez artefakty / odtwarzanie |
|---|---|---|---|---|
| Teoria liczb | ✔ | – | – | – |
| Szeregowanie (pinwheel) | ✔ | – | – | częściowo |
| SDF / CSDF | – | częściowo | ✔ | – |
| Języki synchroniczne / rachunki zegarów | – | – | ✔ | – |
| DSP wielotempowy | – | częściowo | częściowo | – |
| DSMS (CQL, PIPES) | – | – | ✔ | częściowo |
| Współdzielenie wielu zapytań / stanu | – | – | ✔ | częściowo |
| TSMS / DSP-w-bazie | – | częściowo | częściowo | częściowo |
| RetractorDB | ✔ | ✔ | ✔ | ✔ |
Najsilniejszymi sąsiadami w zakresie modelu wykonania są SDF/CSDF oraz języki synchroniczne i rachunki zegarów: zapewniają już wielotempowy deklaratywny przepływ danych, deterministyczną semantykę, statyczne harmonogramy albo wyznaczanie buforów. Nurt wielu zapytań jest równie bliski na niewidocznej w kolumnach osi: potrafi automatycznie współdzielić utrzymywany stan i formułować warunki zachowania dla poszczególnych zapytań. Wpis „częściowo” nie oddaje całej bliskości tego porównania, ponieważ tabela nie opisuje sposobu ustalania tożsamości współdzielonego obiektu.
Zakres integracji RetractorDB jest węższy: system łączy zdefiniowany przez sekwencje Beatty’ego, dokładnie odwracalny podział pozycji próbek z kompilatorem zapytań, sekwencyjnym środowiskiem slotowym oraz trwałymi artefaktami dostępnymi do inspekcji i odtwarzania. Jest to opis architektury i semantyki systemu, nie twierdzenie, że poszczególne składniki są nowe. RetractorDB nie deklaruje gwarancji twardego czasu rzeczywistego.
⚠️ Ostrzeżenie
Stąd realne ryzyko, które wprost wskazuję: społeczność szeregowania publikuje tę samą maszynerię Beatty’ego/Fraenkela w latach 2023–2025. Sam problem – wraz z potrzebą deklaratywnej algebry strumieni i ciągłego języka zapytań – został sformułowany już w latach 2003–2005 w kontekście komputerowo wspomaganego monitorowania płodu [25]; pomost „układy pokrywające ↔ wyrównanie strumieni i DSP“ postawiłem publikacją w 2006 roku [3], lecz w miejscu o niskiej odnajdywalności. Jeśli ten wynik nie trafi do dobrze cytowanego obiegu, ten sam pomost może zostać niezależnie postawiony i przypisany komu innemu.
Zastrzeżenie metodologiczne
To przegląd ukierunkowany, nie systematyczny – oparty na wyszukiwaniu w ośmiu nurtach, nie na pełnej analizie cytowań. Przegląd cytowań „w przód“ pracy Samadiego [16] potwierdza tezę: według Semantic Scholar (stan na lipiec 2026) jej jedyne odnotowane cytowania to praca o projektowaniu okien Gabora, dwie prace systemowo-teoretyczne o układach wielotempowych oraz sam pomost z 2006 roku [3] – żadna z nich nie używa sekwencji Beatty’ego ani twierdzenia Fraenkela. Najbliższym znanym mi użyciem tej maszynerii poza teorią liczb jest konstrukcja wykładniczych baz Riesza z sekwencji Beatty’ego–Fraenkela (Pfander, Revay i Walnut) [24] – należy ona jednak do czystej analizy harmonicznej i nie dotyka banków filtrów ani konwersji częstotliwości próbkowania. Do pełnego domknięcia pozostaje systematyczny przegląd nurtu szeregowania [14] oraz literatury banków filtrów w całości; wśród prac o współdzieleniu zapytań wskazano jedynie reprezentatywne mechanizmy. Jeśli istnieje użycie twierdzenia Fraenkela w wielotempowym DSP, zawęża to zakres roszczenia o nowość i należy je tu uwzględnić.
Instalacja systemu
Podstawową platformą wdrożeniową RetractorDB jest Linux na x86-64 i ARM64 (AArch64). Można zainstalować gotowe wydanie albo zbudować programy ze źródeł. Instalator pobierany przez curl instaluje gotowe binaria; kompilację wykonuje się osobno. Apple jest środowiskiem rozwojowym, opisanym w wydzielonej sekcji.
Wybór sposobu instalacji
| Sposób | Zastosowanie | Lokalizacja programów |
|---|---|---|
Instalator install.sh --user | Instalacja dla bieżącego użytkownika, bez uprawnień administratora | ~/.local/bin |
Instalator install.sh --system | Instalacja dla całego systemu, opcjonalnie z usługą systemd | /usr/local/bin |
| Pakiet DEB | Debian lub Ubuntu; utrzymanie przez apt | /usr/bin |
| Budowanie ze źródeł | Rozwój, testy albo własne wydanie | Domyślnie ~/.local/bin |
Instalator korzysta z GitHub Releases. Opis szybkiej instalacji znajduje się również na stronie projektu. Kontrakt produkcyjnego budowania i warianty diagnostyczne opisuje załącznik o budowaniu.
Engine wykonuje plan w procesie Pythona na osi czasu logicznej. Nie zapewnia pracy w czasie rzeczywistym ani nie publikuje strumieni na magistrali. Do przetwarzania w czasie rzeczywistym służy xretractor, a do obserwacji jego strumieni klient monitorowania.
Dalsza lektura
- Gotowe wydania: portable, DEB, systemd, aktualizacja i konfiguracja.
- Budowanie ze źródeł: Linux i rozwojowy port macOS.
- Uruchamianie: standalone oraz plan działającego serwisu.
- Python i Jupyter: wheel, Colab i środowiska lokalne.
- Budowanie biblioteki Python: RDB_PYTHON, testy i pakowanie.
Gotowe wydania na Linuksie
Instalacja gotowego wydania na Linuksie
Instalator wymaga Bash, curl, python3 i sha256sum. Rozpoznaje x86-64 i AArch64, wybiera archiwum retractordb-<wersja>-linux-<architektura>-portable.tar.gz i sprawdza SHA-256 z pola digest zasobu GitHub Releases. Przed instalacją kontroluje zawartość archiwum, architekturę ELF i możliwość uruchomienia wszystkich trzech programów. System z niezgodną wersją glibc lub libstdc++, dystrybucja oparta na musl albo ARM 32-bit może wymagać osobnego budowania ze źródeł.
Dostępne wydania dla architektury hosta można sprawdzić poleceniem:
curl -fsSL https://retractordb.com/install.sh | bash -s -- list
Domyślnie wybierana jest najnowsza stabilna wersja z odpowiednim archiwum. Wydania oznaczone jako draft lub prerelease są pomijane. Instalacja dla użytkownika:
curl -fsSL https://retractordb.com/install.sh | bash -s -- install --user
Programy xretractor, xqry i xtrdb są dostępne przez dowiązania w ~/.local/bin. Jeżeli katalogu nie ma w PATH, należy go dodać w konfiguracji swojej powłoki. Instalator wypisuje taką wskazówkę, ale sam nie zmienia konfiguracji powłoki.
Można też najpierw pobrać i przeczytać skrypt:
curl -fsSLO https://retractordb.com/install.sh
less install.sh
bash install.sh install --user
Instalacja systemowa i usługa systemd
Instalacja systemowa wymaga uprawnień roota i używa prefiksu /usr/local:
curl -fsSL https://retractordb.com/install.sh | sudo bash -s -- install --system
Na hoście z systemd opcja --service dodatkowo instaluje, włącza i uruchamia usługę:
curl -fsSL https://retractordb.com/install.sh | sudo bash -s -- install --system --service
systemctl status xretractor.service
Instalator tworzy konto retractor oraz pusty /etc/retractor/startup.rql, jeśli jeszcze nie istnieją. Pusty plik uruchamia instancję bezczynną, gotową do przyjęcia planu. Istniejące zapytania pozostają bez zmian. Prefiks usługi musi należeć do roota i nie może być zapisywalny przez innych użytkowników. Samo archiwum portable nie zawiera jednostki systemd; tworzy ją instalator.
Sposoby dostarczania planu działającej usłudze opisano w opcjach xretractor.
Aktualizacja, wersje, status i usuwanie
curl -fsSL https://retractordb.com/install.sh | bash -s -- upgrade --user
curl -fsSL https://retractordb.com/install.sh | bash -s -- status --user
curl -fsSL https://retractordb.com/install.sh | bash -s -- uninstall --user
install i upgrade przyjmują --version <wersja> z numerem wydania dostępnym przez list. Własny katalog wybiera --prefix /sciezka/bezwzgledna; ten sam prefiks trzeba podać przy aktualizacji, sprawdzaniu i usuwaniu. W instalacji systemowej należy używać --system, a operacje zmieniające instalację wykonywać jako root.
Instalator zapisuje programy w <prefix>/lib/retractordb/versions/<wersja> i utrzymuje plik installer-state w <prefix>/lib/retractordb. Polecenie status pokazuje stan zarządzanej instalacji i dowiązania programów; nie sprawdza gotowości silnika do obsługi zapytań. Do kontaktu z działającą instancją służy np. xqry --server service --hello.
Aktualizacja zarządzanej usługi systemd restartuje ją z nowym binarium. uninstall usuwa programy i własną jednostkę, zachowując konfigurację, pliki zapytań i konto usługi. Instalator nie przejmuje binariów zainstalowanych inną metodą w tym samym prefiksie; w takim przypadku należy wybrać osobny prefiks albo utrzymać dotychczasową metodę instalacji.
Przed aktualizacją binariów należy zatrzymać działające instancje. Wersje korzystające z różnych układów magistrali mają osobne rejestry i nie zapewniają wspólnej kontroli kolizji nazw strumieni ani plików magazynu. Aktualny układ opisano w rozdziale Wiele instancji i magistrala.
Pakiet DEB
Dla Debiana lub Ubuntu można pobrać zgodny z architekturą pakiet DEB z GitHub Releases i zainstalować go przez apt. Poniżej pakiet.deb oznacza pobrany plik:
sudo apt install ./pakiet.deb
Pakiet instaluje programy w /usr/bin, przygotowuje konfigurację i włącza usługę na następny start systemu. Aby uruchomić ją od razu:
sudo systemctl start xretractor.service
systemctl status xretractor.service
Aktualizację wykonuje się przez apt install ./<nowy-plik>.deb, a usunięcie przez sudo apt remove retractordb. Instalator portable nie zarządza pakietami Debiana. Nie należy instalować wariantu DEB i wariantu portable z --service na jednym hoście: oba używają nazwy xretractor.service.
Weryfikacja instalacji i konfiguracja
xretractor --build-info
xqry -h
xtrdb -h
--build-info pokazuje flagi optymalizatora gotowej binarki, bez uruchamiania silnika. Nie zastępuje testu działania własnego planu. Po instalacji warto sprawdzić również command -v xretractor, aby upewnić się, że PATH wskazuje wybraną instalację.
Instalator portable kopiuje domyślny TOML wyłącznie wtedy, gdy pliku jeszcze nie ma: do /etc/retractor/retractor.toml dla instalacji systemowej albo $XDG_CONFIG_HOME/retractor/retractor.toml (domyślnie ~/.config/retractor/retractor.toml) dla użytkownika. W dostarczonym pliku storage.dir jest zakomentowane. Przed ustawieniem tej opcji należy utworzyć katalog i nadać prawo zapisu użytkownikowi uruchamiającemu silnik. Pełną kolejność konfiguracji i pierwszeństwo dyrektyw RQL opisano w opcjach xretractor.
Instalacja przez cmake --install umieszcza domyślny TOML w <prefix>/share/retractordb/retractor.toml; nie aktywuje go jako konfiguracji użytkownika. Można skopiować go do swojej lokalizacji konfiguracji albo wskazać przez --config.
W konfiguracji operator może ograniczyć historię w RAM i wzrost plików strumieni DEFAULT/DIRECT bez własnej retencji:
[limits]
history_memory_mib = 1024

[storage]
default_retention = [1000, 4]
history_memory_mib jest dodatnim budżetem MiB dla źródeł i pierścieni MEMORY; zbyt duży plan zostaje odrzucony podczas kompilacji. default_retention wymaga dwóch dodatnich liczb [pojemność, segmenty], dotyczy też substratów plikowych i nie zastępuje jawnego RETENTION. Bez tego klucza strumienie plikowe bez retencji nadal rosną; xretractor wymienia je przy starcie i w -c. Plik TOML może też zawierać server.autoname (domyślnie false) oraz service.unrestricted (domyślnie false, dopuszcza DO SYSTEM przez xqry --reset); ich skutki i zasady pierwszeństwa opisują opcje xretractor.
Budowanie ze źródeł
Budowanie i instalacja ze źródeł
Budowanie na Linuksie korzysta z Conan 2, CMake i Ninja. Wymagany jest kompilator C++23 z <print> i std::println (GCC 14 lub nowszy). Toolchain projektu wymaga CMake co najmniej 4.4.2. Skrypt scripts/buildrdb.sh przygotowuje narzędzia i profil Conan; ścieżka instalowania zależności na Linuksie korzysta z apt.
W katalogu pobranego repozytorium retractordb:
scripts/buildrdb.sh toolchain
scripts/buildrdb.sh conan ninja
scripts/buildrdb.sh bashrc
Po dodaniu ~/.local/bin do PATH trzeba odświeżyć powłokę, np. otwierając nowy terminal. Budowanie i instalacja wariantu Debug:
scripts/buildrdb.sh debug
cmake --install build/Debug
ctest --test-dir build/Debug --output-on-failure
Instalacja jest osobnym krokiem po budowaniu i domyślnie nie wymaga sudo. Testy integracyjne korzystają również z zainstalowanych programów, dlatego instalacja poprzedza testy. Opcjonalne biblioteki API mają osobne cele instalacji i testowania.
Produkcyjne wydanie ze źródeł wymaga czystego drzewa Git:
scripts/buildrdb.sh release
cmake --install build/Release
ctest --test-dir build/Release --output-on-failure
Tryb release-dirty służy do diagnostyki lokalnych zmian i nie tworzy wydania produkcyjnego. Szczegóły w kontrakcie budowania. Paczki dla odbiorców są przygotowywane osobno; skrypty i kontrole linuxowych wydań opisano w repozytorium kodu w scripts/release_package/README.md.
Kontrola obsługi błędów rdzenia
Domyślne RDB_NOEXCEPT_CHECK=ON dodaje do pełnego buildu cele kontrolne rdb_noexcept_check, retractorcore_noexcept_check i rdbembed_noexcept_check. Sprawdzają te same źródła rdzenia ponownie z -fno-exceptions i -fsyntax-only, bez wyznaczonych jednostek obsługujących ANTLR, Boost.Stacktrace i konfigurację. Użycie throw, try lub catch w kontrolowanej części rdzenia jest wtedy błędem kompilacji. Kontrola obejmuje analizę składniową i semantyczną kompilatora, bez generowania kodu maszynowego.
Skrypt cmake/syntaxOnly.sh dodaje -fsyntax-only do polecenia kompilatora, zachowując skonfigurowany launcher ccache. Dopiero po powodzeniu tworzy pusty plik wyjściowy wskazany przez -o, aby Ninja mógł rozpoznać zakończoną kontrolę. Cele pozostają bibliotekami OBJECT w CMake, ale ich puste pliki nie są linkowane do wydawanych programów; IPO w konfiguracji Release jest dla tych celów wyłączone.
Wydawane programy i moduł Python są kompilowane jednolicie z obsługą wyjątków. Biblioteki zewnętrzne nadal korzystają z wyjątków; mieszanie jednostek z -fno-exceptions i bez tej flagi w jednym programie naruszało zgodność funkcji inline Boosta i spdloga oraz pomijało destruktory przy przejściu wyjątku przez rdzeń. Dlatego RDB_NOEXCEPT_CHECK zastępuje pierwotne RDB_NO_EXCEPTIONS z portu #511.
Operacje rdzenia C++ zgłaszają obsługiwalne błędy przez rdb::Result<T> = std::expected<T, Error>, z kategorią, komunikatem i errno. Wywołujący sprawdza wynik, a tworzenie obiektów może wymagać fabryki create lub make. RDB_NOEXCEPT_CHECK=OFF wyłącza tylko dodatkową kontrolę kompilacji; nie przywraca wcześniejszego API C++ opartego na wyjątkach. Nie jest to przełącznik bezpieczeństwa kernela: rdb::fatal() kończy hosta niezależnie od tej flagi. Granicę opisuje API Python.
Pełny build uruchamia kontrolę automatycznie. Budowanie wyłącznie wybranego celu, np. _core, nie uruchamia niezależnych celów kontrolnych; można zbudować je jawnie zgodnie z procedurą dla Pythona. Test exception_mode_guard sprawdza rzeczywiste flagi wydawanych celów oraz kompletność kontroli na podstawie compile_commands.json. Nie potwierdza, że build kontrolny został wykonany.
Środowisko rozwojowe Apple
Port macOS służy do rozwoju i testowania. Ogólny kontrakt systemu, opis usług i procedury produkcyjne w tej instrukcji dotyczą Linuksa. Instalator curl opisany w gotowych wydaniach obsługuje Linux; na Apple buduje się ze źródeł.
Sprawdzona konfiguracja portu to Apple silicon z macOS 27 i Apple clang 21. Intel Mac i starsze wydania systemu pozostają niezweryfikowane. Xcode 16.3+ Command Line Tools i deployment target macOS 14.4+ są dolnymi wymaganiami wynikającymi z użycia std::print, a nie deklaracją przetestowania wszystkich takich konfiguracji.
Przed budowaniem należy przygotować Command Line Tools (xcode-select --install), Homebrew oraz dostępne w PATH CMake, Python 3 i Git. scripts/buildrdb.sh toolchain korzysta na macOS z Homebrew. Skrypt poniżej może doinstalować brakujące Conan i Ninja przez Homebrew; korzysta też ze środowiska Conan zapewniającego wymaganą wersję CMake:
scripts/macos-build.sh
scripts/macos-build.sh --sanitize
Domyślny przebieg to Debug: konfiguracja, budowanie, instalacja, odświeżenie kopii testów, ponowne budowanie, CTest i osobny cel test-api. Dziennik trafia do build/macos-build.log. --sanitize włącza AddressSanitizer i UndefinedBehaviorSanitizer. --no-install wyłącza doinstalowywanie narzędzi, ale nie instalację zbudowanych programów. --skip-tests pomija testy, pozostawiając instalację. scripts/macos-build.sh release wybiera konfigurację Release, lecz nie wykonuje kontroli produkcyjnego scripts/buildrdb.sh release.
Różnice istotne podczas rozwoju
| Obszar | Zachowanie portu macOS |
|---|---|
| Konfiguracja | Bez --config warstwy są odczytywane kolejno z /etc/retractor/retractor.toml, /usr/local/etc/retractor/retractor.toml, /opt/homebrew/etc/retractor/retractor.toml, a następnie z lokalizacji użytkownika. Późniejsza warstwa nadpisuje klucze wcześniejszej. Obecność ścieżki Homebrew nie oznacza dostępności formuły instalacyjnej. |
| IPC | Boost.Interprocess używa plikowego zaplecza pod /tmp/boost_interprocess/...; raport --shmbudget dotyczy tego woluminu, a nie linuxowego tmpfs /dev/shm. Zbyt długie nazwy obiektów otrzymują deterministyczny skrót; publiczna nazwa serwera zachowuje limit 32 znaków. |
| Żywotność procesu | PID i czas startu odczytuje sysctl; brak /proc nie oznacza braku kontroli żywego właściciela. Zamek magistrali ma ścieżkę zastępczą odporną na śmierć właściciela. |
| Czas rzeczywisty | SCHED_FIFO jest ustawiane na wątku przetwarzającym przez pthread_setschedparam. Priorytet z TOML (1..99) jest ograniczany do zakresu jądra. Brakuje affinity CPU i odpowiednika PREEMPT_RT; mlockall może zwrócić ENOSYS, po czym wykonanie trwa bez blokowania stron pamięci. Sen absolutny korzysta z interfejsu Mach. Nie jest to platforma pomiarowa dla linuxowych gwarancji czasu rzeczywistego. |
| Usługa | Kod rozpoznaje zadanie launchd przez XPC_SERVICE_NAME i rodzica PID 1 oraz buduje restart przez launchctl kickstart -k. Wybór domeny z efektywnego UID jest heurystyką: systemowy daemon uruchomiony jako użytkownik inny niż root może otrzymać błędną domenę. Pakiet nie dostarcza .plist ani instalatora usługi launchd. |
| Testy pamięci | Na Apple silicon testy działają bez Valgrinda. Kontrolę pamięci należy uruchamiać w osobnej konfiguracji z sanitizerami; samo przejście zwykłego CTest, również wpisów z -vg w nazwie, jej nie potwierdza. |
| API | Skrypt uruchamia jawny test-api, obejmujący klientów Python i C++ oraz tworzenie procesów. API nadal jest komponentem opcjonalnym; ta ścieżka rozwojowa nie rozszerza produkcyjnego kontraktu API na macOS. |
| Pakowanie | CPack tworzy TGZ bez komponentu usługowego systemd. Możliwość lokalnego utworzenia archiwum Darwin nie oznacza jego dostępności w instalatorze webowym. |
Kontrolę możliwości platformy i dopuszczanie ścieżek zastępczych opisano w załączniku o budowaniu.
Uruchamianie
Zainstalowane narzędzia można uruchamiać jako standalone albo przez usługę. Gotowe wydania opisują instalację i systemd, a opcje xretractor konfigurację czasu rzeczywistego, przełączniki i wymianę planu. Engine w Pythonie wykonuje plan na osi logicznej, bez usługi i magistrali.
Standalone: plik do EOF
W powłoce Linux przygotuj osobne wejście i katalog wyników:
rdb_demo_dir=$(mktemp -d)
mkdir "$rdb_demo_dir/results"
printf '10\n20\n30\n40\n50\n60\n70\n80\n' > "$rdb_demo_dir/input.txt"
cat > "$rdb_demo_dir/plan.rql" <<EOF
STORAGE '$rdb_demo_dir/results'
DECLARE a INTEGER STREAM src, 1/2 TEXTFILE '$rdb_demo_dir/input.txt'
SELECT a*2 STREAM dst FROM src
EOF
xretractor "$rdb_demo_dir/plan.rql" --name installation-demo -u -k
-u zatrzymuje przetwarzanie po EOF; -k pomija oczekiwanie na klawisz przy zakończeniu. Bez -u źródło może zawijać się, a proces wymaga zatrzymania. Nazwa identyfikuje instancję na magistrali; równoczesne instancje muszą mieć różne nazwy i rozłączne zasoby planów. Do rozmowy z działającą instancją używaj xqry --server installation-demo; zakończonego przebiegu nie można już obserwować przez IPC. Gotowe artefakty czyta xtrdb albo offline Storage. Katalog przykładu pozostaje do inspekcji.
Działająca usługa
Po instalacji z obsługą systemd sprawdź systemctl status xretractor.service. Pusta konfiguracja startowa oznacza instancję bezczynną. Plan dostarcza się przez xretractor nowy-plan.rql albo reset xqry --server service --reset nowy-plan.rql, zgodnie z kontraktem usługi i wymiany planu. Kontrole środowiska, magazynów i odmowy różnią się od wykonania osadzonego; OK resetu nie gwarantuje trwałego zapisu planu startowego.
Strumienie serwisu czyta się przez xqry lub klient monitorowania. Nie otwieraj magazynu działającej usługi przez Storage w celu monitorowania. WSL2 wymaga działającego systemd dla wariantu usługowego; standalone i Engine nie wymagają systemd.
Python i Jupyter
Biblioteka osadzona wykonuje RQL wewnątrz Pythona, bez demona. Jej kontrakt API obejmuje czas logiczny, a nie pracę w czasie rzeczywistym. Do czytania strumieni serwisu służy osobny klient monitorowania.
Instalacja z PyPI
Pakiet retractordb jest opublikowany na PyPI. Wydanie v0.1.12 udostępnia gotowe koła Pythona zarówno na PyPI, jak i w GitHub Releases. Instalacja pip install retractordb pobiera pakiet z biblioteką osadzoną retractordb._core; nie wymaga lokalnej kompilacji silnika ani uruchamiania serwisu. Strona projektu zawiera wprowadzenie do RetractorDB, a instalator systemowy służy do instalacji osobnych programów CLI i serwisu.
Poniższy przykład przypina wersję 0.1.12 i tworzy środowisko w katalogu własnego projektu. --only-binary=retractordb wymaga gotowego koła zamiast próby budowania silnika ze źródeł:
python3.12 -m venv .venv-rdb
.venv-rdb/bin/python -m pip install --upgrade pip
.venv-rdb/bin/python -m pip install --only-binary=retractordb 'retractordb==0.1.12' jupyterlab ipykernel
.venv-rdb/bin/python -c 'import retractordb._core; print(retractordb._core.__file__)'
.venv-rdb/bin/python -m pip check
pip wybiera koło pasujące do interpretera i platformy oraz instaluje NumPy (numpy>=1.23). PyTorch jest opcjonalny i nie jest instalowany domyślnie. Polecenie importu potwierdza obecność rozszerzenia, a nie tylko czystego klienta monitorowania.
W wydaniu 0.1.12 opublikowano sześć kół:
| Platforma | Minimalna glibc | Warianty CPython |
|---|---|---|
| Linux x86_64, także WSL2 | 2.27 | 3.10 (cp310-cp310), 3.11 (cp311-cp311), 3.12+ (cp312-abi3) |
| Linux aarch64 / ARM64 | 2.26 | 3.10 (cp310-cp310), 3.11 (cp311-cp311), 3.12+ (cp312-abi3) |
Koła abi3 są przeznaczone dla CPython 3.12 i nowszych ze standardowym GIL. Dla CPython 3.10 lub 3.11 zastąp python3.12 odpowiednim interpreterem; lokalne profile opisane niżej nadal wymagają 3.12. To wydanie nie zawiera kół macOS, natywnego Windows ani musllinux. Na macOS przygotuj lokalny build, a na Windows użyj Linuksa w WSL2. Dostępność koła ARM64 nie jest potwierdzeniem wykonania na danym urządzeniu.
PyTorch instaluj zgodnie z własnym CPU/CUDA. Nie jest wymagany do wykonania planu, NumPy ani DLPack. W interpreterze lub kernelu używającym tego środowiska uruchom kompletny przykład API.
Gotowy wheel z GitHub Releases
Alternatywnie pobierz plik .whl z wydania v0.1.12 albo z sekcji plików na PyPI. Zachowaj pełną nazwę, SHA-256 i informację o rewizji źródeł z procesu budowy. Koła tego wydania na GitHub i PyPI mają te same nazwy i sumy SHA-256.
Przykład dla Linux x86_64 i CPython 3.12+ pobiera konkretne koło i sprawdza jego opublikowaną sumę. Wykonaj go w katalogu własnego projektu; jeśli nie masz jeszcze środowiska, utwórz je poniższymi poleceniami:
python3.12 -m venv .venv-rdb
.venv-rdb/bin/python -m pip install 'numpy>=1.23' jupyterlab ipykernel
RDB_WHEEL="retractordb-0.1.12-cp312-abi3-manylinux_2_27_x86_64.manylinux_2_28_x86_64.whl"
curl -fLO "https://github.com/michalwidera/retractordb/releases/download/v0.1.12/$RDB_WHEEL"
printf '%s  %s\n' \
  '511ca1401d9d0e268dd99f8ecfadbeb1e6f8c96ffce141c1a69891e87cffd287' "$RDB_WHEEL" \
  | sha256sum --check
.venv-rdb/bin/python -m pip install --no-deps "$RDB_WHEEL"
.venv-rdb/bin/python -c 'import retractordb._core; print(retractordb._core.__file__)'
.venv-rdb/bin/python -m pip check
Inny plik .whl wymaga własnej sumy z GitHub Releases lub PyPI. --no-deps wymaga wcześniej przygotowanego NumPy; nie instaluje ani nie podmienia PyTorch. Można też instalować bezpośrednio z URL HTTPS zawierającego oryginalną nazwę koła, ale wtedy sumę należy sprawdzić osobno po pobraniu.
pip install ./api/python w repozytorium kodu instaluje tylko klienta monitorowania i może zastąpić pakiet zawierający _core. Używaj do tego osobnego środowiska.
Kernel Jupyter
Kernel i rozszerzenie muszą używać zgodnej wersji Pythona. Można jawnie zarejestrować kernel własnego środowiska:
.venv-rdb/bin/python -m ipykernel install --user --name retractordb-wheel --display-name 'RetractorDB wheel'
.venv-rdb/bin/jupyter lab
W Jupyter wybierz „RetractorDB wheel”. Rejestracja powyżej jest świadomą zmianą konfiguracji użytkownika; skrypt lokalnych profili poniżej umieszcza kernel we własnym venv zamiast rejestrować go globalnie. Notebooki w repozytorium kodu to j0_storage.ipynb, j1_engine.ipynb i colab_quickstart.ipynb.
Google Colab
Do zwykłej instalacji pakietu w nowym runtime wystarczy komórka:
%pip install --only-binary=retractordb retractordb==0.1.12
import retractordb._core
print(retractordb._core.__file__)
Pełny colab_quickstart.ipynb otwórz w Colabie. Jego komórka instalacyjna nadal wymaga pliku .whl albo bezpośredniego URL, nie nazwy pakietu PyPI. Pobierz zgodne koło z wydania v0.1.12, prześlij je przez panel Files do /content/ i ustaw WHEEL w pierwszej komórce kodu na ścieżkę; możesz też podać URL koła z GitHub Releases. Ustaw także SOURCE_COMMIT na pełne SHA podane w logu budowy. Notebook instaluje samo koło z --no-deps, porównuje wersje NumPy/torch przed i po, mierzy osobno pobranie, instalację i import oraz zapisuje rdb-acceptance.json.
Asercje NumPy sprawdzają sygnał przed i po treningu. Bez torch komórki ML jawnie pomijają trening; z torch używają CUDA, gdy jest dostępna, albo CPU. T4 używa fp16 z GradScaler; natywne bf16 jest wybierane, gdy runtime zgłasza jego obsługę. Nie zakładaj, że dowolny GPU został odebrany. Wersje i konieczność restartu obserwuje się w danym runtime; lokalny kontener nie potwierdza zachowania Colaba. Pełny protokół odbioru oddziela oba rodzaje dowodów.
Lokalne profile Jupyter i PyTorch
W repozytorium kodu scripts/jupyter-env.sh tworzy trwałe, izolowane środowiska dla zainstalowanego Python 3.12. Potrzebuje już zbudowanego zgodnego _core albo wheel; nie kompiluje silnika, nie instaluje do systemowego Pythona i nie zmienia ~/.local/bin ani PATH wywołującej powłoki. Dla modułu lokalnego przygotuj osobny build Python.
scripts/jupyter-env.sh system
.venv-jupyter-system-cpu/bin/rdb-python -m pytest api/python/tests -ra
PYTHON="$PWD/.venv-jupyter-system-cpu/bin/rdb-python" \
  docker/wheel/notebook-smoke.sh --module-dir build/Debug-Python/python

scripts/jupyter-env.sh user
.venv-jupyter-user-cpu/bin/rdb-jupyter api/python/notebooks

scripts/jupyter-env.sh user --wheel \
  build/wheelhouse/retractordb-0.1.12-cp312-abi3-manylinux_2_27_x86_64.manylinux_2_28_x86_64.whl \
  --venv .venv-jupyter-wheel
.venv-jupyter-wheel/bin/rdb-jupyter api/python/notebooks
W profilu użytkownika wybierz „RetractorDB (user, cpu)”. rdb-python i kernel używają jawnego katalogu modułu i sprawdzają rzeczywistą ścieżkę _core. Profil modułu importuje go z builda bez kopiowania do site-packages; profil wheel instaluje do swojego venv i przekazuje jego ścieżkę do komórki notebooka.
Opcje --module-dir, --python, --venv wskazują moduł, interpreter i środowisko. Istniejący venv także musi mieć Python 3.12. Ponowne uruchomienie odświeża zależności i kernel; osobne moduły i backendy torch powinny mieć osobne venv. Aktywacja powłoki nie jest potrzebna.
Wersje powtarzalnego lokalnego profilu określa scripts/notebook-versions.sh: Python 3.12, NumPy 2.0.2, nanobind, pytest, nbclient, nbformat i ipykernel. Linux używa torch 2.11.0+cpu z indeksu CPU, profil użytkownika także JupyterLab. Nie są to deklaracje bieżących wersji Colaba. Instalator sprawdza pip check, pochodzenie _core i współdzielenie DLPack, mierzy czas i rozmiar venv oraz zapisuje requirements-resolved.txt.
| Platforma | Profil i zakres |
|---|---|
| Linux x86_64 / WSL2 | Domyślny CPU; główna platforma weryfikacji |
| Linux aarch64 | Instalator obsługuje CPU; wykonanie wymaga dowodu na tym hoście |
| macOS arm64, macOS 14+ | Domyślny profil MPS, torch 2.14.1 z PyPI; wymagany lokalny build, dopóki nie ma wheel macOS |
| Linux CUDA | Jawne --torch cuda, torch 2.11.0+cu128; kontrola pakietu bez GPU nie potwierdza obliczeń na GPU |
Na macOS launchery trafiają do .venv-jupyter-user-mps i .venv-jupyter-system-mps. Setup sprawdza obecność obsługi MPS w torch, ale nie wymaga dostępnego urządzenia MPS. Sam guard float64 nie jest odbiorem sprzętowym.
Opcjonalny profil pakietu CUDA pobiera kilka GB i pozostaje poza domyślnym profilem CPU. Nie potrzebuje GPU ani sterownika i nie weryfikuje obliczeń CUDA:
CUDA_VISIBLE_DEVICES='' scripts/jupyter-env.sh system --torch cuda
CUDA_VISIBLE_DEVICES='' .venv-jupyter-system-cuda/bin/rdb-python -m pytest api/python/tests -ra
CUDA_VISIBLE_DEVICES='' PYTHON="$PWD/.venv-jupyter-system-cuda/bin/rdb-python" \
  docker/wheel/notebook-smoke.sh --module-dir build/Debug-Python/python
Budowanie biblioteki Python
Polecenia wykonuje się w repozytorium retractordb. Zwykły build silnika nie buduje rozszerzenia: jawne RDB_PYTHON=ON dodaje _core i dopiero wtedy wyszukuje Python i nanobind. Linux i macOS są obsługiwanymi hostami; żądanie flagi na innym hoście kończy konfigurację błędem. RDB_IOS i RDB_ANDROID są jedynie zarezerwowanymi nazwami, bez implementacji. Reguła dla konsumentów osadzonych to: domyślnie OFF, zależności tylko po włączeniu, flaga określa konsumenta, a niewspierany host jest błędem konfiguracji.
Moduł z drzewa budowy
Potrzebne są zależności budowy silnika, CPython 3.10+ z nagłówkami oraz nanobind importowalny przez wybrany interpreter. Do powtarzalnych profili Jupyter używaj Python 3.12. Venv zapobiega instalowaniu narzędzi do systemowego Pythona objętego PEP 668:
scripts/python-venv.sh --python python3.12 --venv .venv-python312
cmake -S . -B build/Debug-Python -G Ninja \
  -DCMAKE_TOOLCHAIN_FILE="$PWD/build/Debug/generators/conan_toolchain.cmake" \
  -DCMAKE_BUILD_TYPE=Debug -DRDB_PYTHON=ON \
  -DPython_EXECUTABLE="$PWD/.venv-python312/bin/python3"
cmake --build build/Debug-Python --target _core --parallel 4
Przykład zakłada istniejący, zgodny build Conan build/Debug z toolchainem i zależnościami; nie tworzy samodzielnie profilu Conan. Bez niego najpierw wykonaj procedurę budowania ze źródeł. Dla istniejącego osobnego build/Debug-Python można wyczyścić wykrywanie poprzedniego interpretera:
cmake -S . -B build/Debug-Python -U '_Python_*' -U nanobind_DIR \
  -DRDB_PYTHON=ON -DPython_EXECUTABLE="$PWD/.venv-python312/bin/python3"
cmake --build build/Debug-Python --target _core --parallel 4
Nie uruchamiaj cmake . w katalogu głównym repozytorium. Interpreter jest zapisany w cache. Moduł i kopie plików .py trafiają do <build>/python/retractordb; cache zapisuje ten katalog jako RDB_PYTHON_MODULE_DIR. Nie potrzeba ninja install do importu z builda. Nanobind używa celów Python::, a zwykły moduł Development.Module, bez linkowania libpython. W budowaniu abi3 dobierane jest Development.SABIModule.
scripts/python-venv.sh instaluje nanobind, NumPy, pytest oraz clang-format 21.1.7 i cmakelang. Torch pomija świadomie; pełne profile Jupyter przygotowują go oddzielnie. Skrypt jest idempotentny, a --python, --venv, --recreate, --print-python wybierają interpreter, katalog, odtworzenie i samą ścieżkę. Próbka python -m nanobind --cmake_dir jest wykonywana także przez CMake.
Formatery są wywoływane przez nazwę i wymagają venv na PATH:
PATH="$PWD/.venv-python312/bin:$PATH" ninja -C build/Debug cformat
Przy budowaniu samego _core dodatkowa kontrola rdzenia nie jest jego zależnością. Przy domyślnym RDB_NOEXCEPT_CHECK=ON uruchom ją pełnym buildem albo jawnie:
cmake --build build/Debug-Python \
  --target rdb_noexcept_check retractorcore_noexcept_check rdbembed_noexcept_check \
  --parallel 4
Ta kontrola nie zmienia flag modułu ani granicy błędów Pythona. Samo zbudowanie lub zaimportowanie _core nie potwierdza wykonania dodatkowej kompilacji.
Testy i pochodzenie modułu
RDB_PYTHON_MODULE_DIR="$PWD/build/Debug-Python/python" \
  .venv-python312/bin/python3 -m pytest api/python/tests
Bez jawnej zmiennej testy szukają pierwszego posortowanego build/*/python zawierającego _core; brak modułu oznacza pominięcia. Takie pominięcia nie potwierdzają odbioru. Pełny odbiór #451 potrzebuje również torch i świeżo zbudowanych xretractor oraz xqry; RDB_XRETRACTOR musi wskazać właściwy program. Jawne ustawienie obu zmiennych zamienia brak zależności albo binarki referencyjnej w błąd. Przed wynikiem sprawdź ścieżkę importowanego _core, równość kopii pakietu ze źródłem oraz program wybrany w środowisku testu.
RDB_PYTHON=ON włącza PIC dla bibliotek statycznych linkowanych do _core: rdb, descparser, common, retractorcore, rqlparser i rdbembed. Poza rdbembed te same biblioteki wchodzą w skład xretractor, xqry i xtrdb, więc na Linux x86_64 zmienia to również binaria silnika w tym buildzie. Pomiary porównawcze, bramkę badawczą i ablation uruchamiaj w osobnym buildzie z RDB_PYTHON=OFF. Na arm64 Darwin PIC nie zmienia tego aspektu kodu.
Sanitizery
Wybierz osobny build bez RDB_SANITIZE do zwykłego Jupyter. Moduł ASan ładowany przez dlopen może zakończyć import, jeśli runtime nie został załadowany wcześniej. Do testowania modułu z sanitizerami trzeba go jawnie wstępnie załadować; asan-build oznacza istniejący build z sanitizerami:
# Linux / GCC; Python jest programem C, dlatego potrzebuje także libstdc++.
LD_PRELOAD="$(g++ -print-file-name=libasan.so) $(g++ -print-file-name=libstdc++.so)" \
ASAN_OPTIONS=detect_leaks=0 RDB_PYTHON_MODULE_DIR=asan-build/python \
  .venv-python312/bin/python3 -m pytest api/python/tests

# macOS / Apple clang
DYLD_INSERT_LIBRARIES="$(clang -print-resource-dir)/lib/darwin/libclang_rt.asan_osx_dynamic.dylib" \
ASAN_OPTIONS=detect_container_overflow=0 RDB_PYTHON_MODULE_DIR=asan-build/python \
  .venv-python312/bin/python3 -m pytest api/python/tests
Te warianty wyłączają odpowiednio LSan albo kontrolę container-overflow; raport ma wskazywać ten zakres. W testach C++ domyślne wyłączenie container-overflow zapobiega fałszywemu alarmowi przy mieszaniu instrumentowanych wektorów libc++ z niesanitizowanym GoogleTest. Inne kontrole ASan pozostają aktywne; ASAN_OPTIONS=detect_container_overflow=1 przywraca tę jedną. Zwykły pytest nie zastępuje kontroli pamięci.
Obraz manylinux i budowanie wheel
docker/wheel/Dockerfile rozszerza przypięty obraz PyPA manylinux_2_28: valgrind, venv narzędzi z Conan, CMake >= 4.4.2 i Ninja oraz cache Release w /opt/conan. RDB_USE_MOLD=OFF wybiera dostępny linker. x86_64 i aarch64 używają tego samego Dockerfile; jego nagłówek podaje digesty baz. Zależności Conan, włącznie z narzędziami, budują się w obrazie, by nie wnosić wymagań nowszego glibc.
docker build --platform linux/amd64 --build-arg RDB_VERSION="$(cat VERSION)" \
  -f docker/wheel/Dockerfile \
  -t micwide/buildenv-retractordb-wheel:manylinux_2_28_x86_64 .
docker run --rm --platform linux/amd64 -v "$PWD:/src:ro" \
  micwide/buildenv-retractordb-wheel:manylinux_2_28_x86_64 \
  bash /src/docker/wheel/smoke.sh
toolchain-probe.cpp sprawdza wymagania biblioteki C++23. audit-so.py korzysta z auditwheel show --json, odrzuca glibc ponad politykę obrazu i biblioteki spoza niej. Kontroluje także brak kodu bus, ipcServer, serverName, lockManager i shmBudget; mapa linkera uzupełnia kontrolę odartego z symboli modułu Release.
smoke.sh kopiuje źródła do kontenera z hostem zamontowanym read-only, sprawdza cache przez --build never, buduje _core, audytuje go i uruchamia testy Pythona z jawnym pochodzeniem modułu. jobs.sh ogranicza równoległość do jednego zadania na 2 GiB, respektując cgroup.
Główny pyproject.toml używa scikit-build-core i wersji z VERSION, buduje tylko _core, instaluje komponent python oraz pliki api/python/retractordb. NumPy jest zależnością runtime, torch opcjonalną. api/python/pyproject.toml pozostaje instalacją klienta bez kompilacji; oba pakiety mają nazwę retractordb i zastępują się w jednym venv.
pipx install cibuildwheel
docker/wheel/build-wheels.sh x86_64
Argument może być aarch64 albo all. Skrypt kopiuje checkout bez ignorowanych artefaktów i zapisuje wheel w build/wheelhouse/. Używa lokalnie otagowanych obrazów; ich publikacja jest osobną decyzją. Buduje CPython 3.10, 3.11 oraz jedno cp312-abi3 dla 3.12+. cibuildwheel naprawia tag manylinux, wykonuje abi3audit --strict oraz testuje zainstalowane wheel z jawnym _core i RDB_PYTHON_MODULE_DIR. W tej konfiguracji torch i binarka referencyjna mogą być nieobecne; pominięcia nie są pełnym odbiorem #451.
EXCLUDE_FROM_ALL pozostawia _core poza zwykłym ninja install, a lista komponentów CPack nie zawiera python. Budowa wheel nie publikuje na PyPI ani nie wykonuje automatycznie odbioru Colab. Wheel macOS, CI publikacji i ingest pozostają odrębnymi etapami.
Podstawy matematyczne
Podstawy matematyczne
ℹ️ Info
Czy wiesz co to jest medal Fieldsa? Jest to nagroda przyznawana wyłącznie wybitnym matematykom w wieku poniżej 40 lat. Nazywana jest matematycznym Noblem. Co ciekawe żaden matematyk nie otrzyma nagrody Nobla – zgodnie z życzeniem fundatora. Sam John Charles Fields (1863-1932) był Kanadyjskim matematykiem. John Charles Fields miał jednego doktoranta – Samuela Beatty (1881-1970).
Samuel Beatty w 1926 roku opublikował następujące twierdzenie [1]:
Jeśli p, q są dodatnimi liczbami niewymiernymi i zachodzi pomiędzy nimi zależność
\[ \frac{1}{p}+\frac{1}{q}=1 \]
to sekwencje
\[ \left\{ \left\lfloor np\right\rfloor \right\} _{n=1}^{\infty }=\left\lfloor p\right\rfloor ,\left\lfloor 2p\right\rfloor ,\left\lfloor 3p\right\rfloor ,\ldots \]
oraz
\[ \left\{ \left\lfloor nq\right\rfloor \right\} _{n=1}^{\infty }=\left\lfloor q\right\rfloor ,\left\lfloor 2q\right\rfloor ,\left\lfloor 3q\right\rfloor ,\ldots \]
oraz dokonują podziału zbioru dodatnich liczb całkowitych.
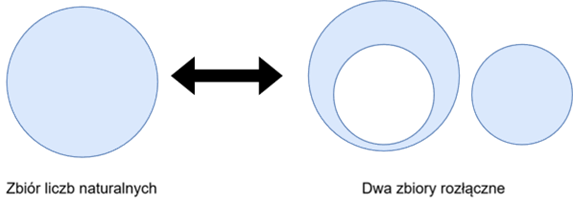
Rys. 1. Repreznatacja graficzna pojęcia zbiorów rozłącznych
Te dwie sekwencje dokonują podziału zbioru liczb naturalnych. Oznacza to że dysponując dwoma liczbami niewymiernymi, pomiędzy którymi wskazana w twierdzeniu zależność – będziemy mogli podzielić zbiór wszystkich liczb naturalnych na dwa rozłączne zbiory (Rys. 1).
Twierdzenie Beaty samo w sobie jest bardzo ciekawą obserwacją – jednak w przypadku systemów komputerowych mamy pewien problem z liczbami niewymiernymi. Liczby rzeczywiste – pomimo faktu że w niektórych językach programowania pojawia się czasem słowo Real lub Float jako reprezentanta typu liczby rzeczywistej, z liczbami rzeczywistymi nie mają wiele wspólnego. Fundamentalny problem polega na tym że ich nie mamy i zapewne nigdy mieć nie będziemy.
I tu nasza podróż gwałtownie by się skończyła gdyby nie powstało kolejne twierdzenie. Sytuacja diametralnie uległa zmianie za sprawą matematyka – Aviezri Siegmund Fraenkel (1926) specjalizującego się w kombinatorycznych aspektach teorii gier.
Przedstawił on w 1969 roku następujące twierdzenie [2]. Punktem wyjścia jest sparametryzowana sekwencja Beatty:
\[ \mathcal{B}(\alpha ,\alpha ^{\prime }):= \left( \left\lfloor \frac{n-\alpha^{\prime }}{\alpha }\right\rfloor \right) _{n=1}^{\infty } \]
Ta jedna definicja generuje całą rodzinę sekwencji. Twierdzenie dotyczy zawsze pary jej egzemplarzy o różnych parametrach: sekwencji
\[ \mathcal{B}(\alpha ,\alpha ^{\prime }) \quad\text{oraz}\quad \mathcal{B}(\beta ,\beta ^{\prime }):= \left( \left\lfloor \frac{n-\beta^{\prime }}{\beta }\right\rfloor \right) _{n=1}^{\infty } \]
Sekwencje te dokonują podziału zbioru ℕ wtedy i tylko wtedy gdy następujące pięć warunków zostanie spełnionych:
1.
\[ 0<\alpha<1 \]
2.
\[ \alpha+\beta=1 \]
3.
\[ 0\leq \alpha +\alpha ^{\prime }\leq 1 \]
- Jeśli α jest liczbą niewymierną, wtedy:
\[ \alpha ^{\prime }+\beta ^{\prime }=0 \]
i
\[ k\alpha +\alpha ^{\prime }\not\in \mathbb{Z} \]
dla
\[ 2\leq k\in \mathbb{N} \]
- Jeśli α jest liczbą wymierną, (niech q∈N będzie najmniejszą liczbą taką że qα∈N), wtedy
\[ \frac{1}{q}\leq \alpha +\alpha ^{\prime } \]
i
\[ \left\lceil q\alpha ^{\prime }\right\rceil +\left\lceil q\beta ^{\prime}\right\rceil =1 \]
No i to jest to czego potrzebujemy! Liczb niewymiernych co prawda nie mamy, ale liczby wymierne rozumiane jako stosunek dwóch liczb naturalnych to jest temat do ogarnięcia za pomocą komputera.
W naszym przypadku najpierw stworzyłem prototypy równań w języku Python a następnie zacząłem poszukiwać podstaw matematycznych, które wyglądały podobnie i można było się oprzeć na nich jako dobrze udokumentowanych równaniach popartych formalnymi dowodami. Dowodami oczywiście przeprowadzonymi przez bardziej doświadczonych matematyków. Skromne umiejętności pozwoliły jednak na identyfikację tych dwóch publikacji w aspekcie moich pomysłów.
W tym dokumencie nie umieściłem formalnych dowodów. Dlatego przestawiłem tutaj jedynie stosowane w systemie równania i twierdzenia. Po formalne dowody odsyłam do moich publikacji naukowych [3].
Algebra regularnych serii czasowych
Algebra – rozumiana jako konstrukcja w postaci zdefiniowanego zbioru i zdefiniowanych operacji na nim, stanowi podstawę dla opracowanego deklaratywnego język zapytań. W dalszej części pracy odnosząc się do Algebry (bez dodatkowego przymiotnika) będę ją rozumiał jako Algebrę regularnych serii czasowych. Jeśli będę chciał odwołać się do Algebry Relacji – jasno wyspecyfikuję przymiotnik.
Zaproponowałem [3] następującą definicje regularnej serii czasowej (tzw. Modelu danych) oraz następujące operacje i definicje.
✅ Uwaga
Przez strumień danych rozumiemy uporządkowaną parę S := (sn,∆) – gdzie pierwszy element to uporządkowania seria danych a drugi, oznaczony symbolem delty to regularny odstęp czasu pomiędzy kolejnymi elementami serii danych.
Przyjmujemy przy tym stałą konwencję indeksowania: indeksy strumienia biegną od zera, a element sn niesie domyślny (niejawny) znacznik czasu (n+1)·∆. Innymi słowy – pierwszy element strumienia pojawia się po upływie pełnego odstępu ∆ od chwili powstania strumienia. Znacznik czasu nie jest przenoszony w krotce; wynika z pozycji n i tempa ∆. To właśnie ten różnicowy model danych odróżnia system od klasycznych DSMS, w których strumień jest wielozbiorem par ⟨s,τ⟩ ze stemplem czasowym w każdej krotce.
Tak zdefiniowaną serię danych w systemie określam jako strumień danych. Taki regularnie przepływający przez system zestaw danych, zazwyczaj opisany schematem danych zawiera pola różnych typów. Każdy odczyt występuje w równym odstępie czasu pomiędzy kolejnymi pomiarami. Taka konstrukcja bardziej przypomina sygnał cyfrowy niż nieregularny strumień danych – jednak oznaczenie jej jako strumień w dalszej części prac badawczych okaże się uzasadnione.
ℹ️ Info
Uwaga:
Pojęcie strumień i Seria czasowa w tej pracy używane są zamiennie i oznaczają to samo.
Formalnie w literaturze naukowej strumień oznaczany jest jako zbiór par (a,t) – gdzie a oznacza krotkę, a czast oznacza jej moment zarejestrowania lub wystąpienia.
W strumieniu dopuszczalne są krotki, których czas t pokrywa się dla różnych krotek. W przypadku serii czasowej rozróżniamy dwa typy serii – regularne i nieregularne.
- W przypadku serii nieregularnych – seria to sekwencja uporządkowanych krotek w czasie – {at,tn}, gdzie czas tn jest unikalny w zbiorze dla każdej krotki.
- Natomiast seria regularnej serii czasowej może zostać opisana sekwencją krotek i regularnym odstępem czasu pomiędzy ich występowaniem – ({at},D) – i to ta ostatnia definicja jest bazą dalszych operacji w opracowanym systemie.
Operacje jakie możemy na takim zbiorze danych wykonać zdefiniowałem następująco:
- przeplot i rozplątanie
- suma i różnica
- przesunięcie sekwencji
- agregacja i serializacja
W operacji przeplotu biorą udział dwa różne strumienie danych.
Definiujemy ją następująco:
\[ c_{n}=\left\{ \begin{array}{cc} b_{n-\left\lfloor n z \right\rfloor } & \left\lfloor n z \right\rfloor =\left\lfloor \left( n+1\right) z \right\rfloor \\ a_{\left\lfloor n z \right\rfloor } & \left\lfloor n z \right\rfloor \neq \left\lfloor \left( n+1\right) z \right\rfloor% \end{array}% \right. , z =\frac{\Delta _{b}}{\Delta _{a}+\Delta _{b}},\Delta _{c}=% \frac{\Delta _{a}\Delta _{b}}{\Delta _{a}+\Delta _{b}} \]
Argumentem operacji splątania (przeplotu) są dwa strumienie danych A i B, każdy z własną szybkością napływu danych. Wynikiem jest strumień wynikowy C – z nową różną od dwóch poprzednich szybkością napływu wyznaczoną wzorem powyżej.
Operację będziemy oznaczać symbolem #.
Operację rozplątania definiujemy poprzez dwie operacje.
1. Rozplątanie lewostronne jako strumień A w postaci:
\[ a_{n} = c_{n+ \left\lceil \frac{(n+1)\Delta _{a}}{\Delta _{b}} \right\rceil },\ \Delta _{a}=\frac{\Delta _{c}\Delta _{b}}{\left\vert \Delta _{c}-\Delta _{b}\right\vert } \]
- Rozplątanie prawostronne jako strumień B w postaci:
\[ b_{n} = c_{n+\left\lfloor \frac{n\Delta_{b}}{\Delta_{a}}\right\rfloor},\ \Delta_{b}=\frac{\Delta_{c}\Delta_{a}}{\left\vert \Delta_{c}-\Delta_{a}\right\vert } \]
Operacje rozplątania 1 i 2 będziemy oznaczać symbolami & i %.
Argumentem operacji rozplątania jest splątany strumień danych oraz wymierna liczba określająca szybkość napływu odplątywanego strumienia danych. W wyniku operacji otrzymujemy strumień danych z wyznaczoną szybkością wzorem powyżej.
Operacje splątania i rozplątania są komplementarne. Oznacza to że przypominają operacje mnożenia i dzielenia w zbiorze liczb naturalnych. W wyniku mnożenia otrzymujemy pewien wynik natomiast w wyniku dzielenia – czasem dochodzi reszta, istotne jest również to co przez co dzielimy i w jakiej kolejności.
Operacje sumy zdefiniowałem następująco:
\[ c_{n}=\left\{ \begin{array}{cc} a_{n}|b_{ \left\lfloor \frac{n\Delta_{a}}{\Delta_{b}} \right\rfloor } & \Delta_{a}\leq \Delta_{b} \\ a_{ \left\lfloor \frac {n\Delta_{b}}{\Delta_{a}} \right\rfloor }|b_{n} & \Delta_{a}>\Delta_{b} \end{array} \right. ,\Delta_{c}=\min \left( \Delta_{a},\Delta_{b}\right) \]
Szybszy strumień narzuca tempo wyniku: każdy jego element zostaje sklejony (symbol | oznacza konkatenację krotek) z elementem zajmującym współindeksowany slot strumienia wolniejszego.
Natomiast różnicę opisuje wzór:
\[ a_{n}=\left\{ \begin{array}{cc} c_{n} & \Delta_{b}\geqslant \Delta_{a} \\ c_{\left\lceil \frac{n\Delta_{a}}{\Delta_{b}}\right\rceil } & \Delta_{b}<\Delta_{a} \end{array} \right. \]
Te operacje oznaczać będziemy znakami + oraz -.
Wykonanie przyczynowe rozszerza matematyczny strumień S = (sn, ∆) o początek logiczny OS ∈ ℕ oraz ogon startowy WS ∈ ℕ. Początek logiczny wskazuje indeks pierwszego rekordu, który w ogóle istnieje, a ogon określa, przez ile kolejnych slotów istniejący rekord nie jest jeszcze gotowy. Żaden z tych slotów nie jest rekordem: silnik nie wstawia zer ani zastępczych rekordów all-null.
\[ \widehat{S} := \left((s_n,\Delta),O_S,W_S\right) \]
Operację przesunięcia definiujemy jako odczyt starszego indeksu: rekord wynikowy \(n\) niesie treść rekordu \(n-m\) producenta. W realizacji przyczynowej:
\[ O_{\tau_m(S)}=O_S+m, \qquad W_{\tau_m(S)}=\max(0,W_S-m), \qquad m\in\mathbb{N} \]
Przesunięcie nie odrzuca elementów źródła i nie wytwarza prefiksu. Przenosi opóźnienie do początku logicznego, a odczyt starszego rekordu może pochłonąć część ogona producenta. Kompilator raportuje obie wielkości jako origin= i tail=. Runtime nie emituje rekordów w żadnym ze slotów milczenia, których jest origin + tail. Szczegóły: Ogony, początki logiczne i obserwowalność operatorów.
Operację przesunięcia oznaczać będę za pomocą >.
Ostatnią operacją w ramach zdefiniowanej algebry jest operacja agregacji i serializacji – w skrócie Agse. O ile wydaje się że to dwie oddzielne operacje, zdefiniowałem dwuargumentowy operator implementujący logikę ruchomego okna danych. Pierwszym argumentem jest skok okna, drugim jest jego szerokość. Skok jest liczbą naturalną o ile ruchome okno danych należy przesunąć nad strumieniem. Zakładamy że źródłowy strumień danych rozbity zostaje względem schematu danych, modyfikując jego szybkość napływu. Szerokość okna jest liczbą całkowitą, różną od zera. Wartości ujemne szerokości przenoszą kolejność tworzonych elementów w odbiciu lustrzanym. Wartości dodatnie – zachowują sekwencyjny charakter tworzonych ruchomych okien danych.
Operację Agse oznaczać będę znakiem @.
Podsumowując, algebra będąca podstawą dla deklaratywnego języka zapytań prezentuje się następująco:
\[ A_{rql}::=((s_n,\Delta_s), (\#,\&,\%,+,-,>,@)) \]
Gdzie pierwszy element pary definiującej algebrę to model danych (s_n - seria danych, ∆_s - jej regularny odstęp czasu) a drugi to zdefiniowane formalnie na tym modelu danych operacje.
Formalne podstawy i dowody
W rozdziale o algebrze regularnych serii czasowych przedstawiłem zbiór operatorów i opisujące je równania. Świadomie pominąłem tam formalne dowody – chciałem najpierw pokazać co system robi, zanim wyjaśnię dlaczego wolno mu to robić. Ta strona uzupełnia tę lukę. Zebrałem tu formalny szkielet algebry: powiązanie operatorów strumieniowych z teorią układów pokrywających oraz dowody twierdzeń, na których opiera się poprawność i optymalizacja planów zapytań.
ℹ️ Info
Cała poniższa konstrukcja trzyma się w jednej dziedzinie – liczb wymiernych. To nie jest ozdobnik. To jest cały sens. Twierdzenie Beatty potrzebuje liczb niewymiernych, których w komputerze nie ma. Twierdzenie Fraenkela pozwala zejść do liczb wymiernych. Dowody na tej stronie pokazują, że operacje przeplotu i rozplątania są szczególnym przypadkiem sekwencji Beatty spełniającym postulaty Fraenkela – a więc są realizowalne wyłącznie na liczbach wymiernych.
Układy pokrywające jako fundament
Literatura dotycząca układów pokrywających (ang. Covering Systems) [4] związana jest z kombinatoryką i kryptoanalizą w obszarze teorii liczb. Rozważanym problemem jest sposób wyznaczania podziału zbioru dodatnich liczb naturalnych. Mówimy, że dwie sekwencje dokonują podziału zbioru dodatnich liczb naturalnych, jeśli zbiory powstałe z elementów tych sekwencji po operacji przecięcia tworzą zbiór pusty, a ich suma tworzy zbiór dodatnich liczb naturalnych.
Podstawą rozważań jest sparametryzowana sekwencja Beatty. W postaci ogólnej zapisujemy ją z funkcją podłogi:
\[ \mathcal{B}(\alpha ,\alpha ^{\prime }) := \left( \left\lfloor \frac{n-\alpha ^{\prime }}{\alpha }\right\rfloor \right) _{n=1}^{\infty } \]
Ta jedna definicja generuje całą rodzinę sekwencji. Wyniki o podziale zbioru dotyczą zawsze pary jej egzemplarzy o różnych parametrach: parę zapisujemy jako B(α, α′) i B(β, β′), przy czym drugi zapis oznacza człon dopełniający.
Parametry tej sekwencji mają czytelną interpretację geometryczną:
- α oznacza gęstość sekwencji,
- 1/α oznacza nachylenie,
- α′ oznacza przesunięcie,
- −α′/α oznacza y-przechwycenie (punkt przecięcia z osią rzędnych).
Twierdzenie Beatty gwarantuje podział zbioru dla liczb niewymiernych. Twierdzenie Fraenkela jest uogólnieniem, które – co dla nas kluczowe – dopuszcza również liczby wymierne, pod warunkiem spełnienia pięciu postulatów (przytoczonych w rozdziale wstępnym). Przystępny dowód twierdzenia Fraenkela można odnaleźć w pracy K. O’Bryanta „Fraenkel’s partition and Brown’s decomposition“ [23].
Cała dalsza część tej strony sprowadza się do jednej myśli: pokazania, że operatory strumieniowe są w istocie maszynami generującymi sekwencje Beatty, które dokonują podziału (pokrycia) zbioru liczb naturalnych.
Narzędzia: własności podłogi i sufitu
Dowody operują niemal wyłącznie na funkcjach podłogi (⌊x⌋ – część całkowita) i sufitu (⌈x⌉ – najmniejsza liczba całkowita nie mniejsza od x). Przytaczam więc najpierw zestaw tożsamości, które będą wielokrotnie wykorzystywane. Niech x ∈ ℝ, a C oznacza liczbę całkowitą:
\[ \left\lfloor x\right\rfloor = \left\lceil x\right\rceil \iff x \in \mathbb{Z} \]
\[ \left\lfloor x\right\rfloor + 1 = \left\lceil x\right\rceil \iff x \in \mathbb{R} \setminus \mathbb{Z} \]
Druga z tych tożsamości ma bezpośrednie przełożenie na same sekwencje Beatty. Wariant sufitowy sekwencji, B′α(n) = ⌈nα⌉, jest bowiem – dla niewymiernego α – wyłącznie przesuniętą o jeden wersją wariantu podłogowego:
\[ B_{\alpha}^{\prime}(n) = \left\lceil n\alpha \right\rceil = \left\lfloor n\alpha \right\rfloor + 1 \]
W prawdziwej sekwencji Beatty α musi być niewymierne, więc nα nie jest liczbą całkowitą dla żadnego n > 0 – przesłanka drugiej tożsamości jest spełniona dla każdego wyrazu, a wariant sufitowy podnosi po prostu każdy wyraz wariantu podłogowego dokładnie o 1. Dla nas jest to jednak przypadek, którego w komputerze nie ma. W dziedzinie wymiernej, dopuszczonej dopiero przez twierdzenie Fraenkela, nα bywa liczbą całkowitą i wtedy ⌈nα⌉ = ⌊nα⌋, czyli przesunięcie o 1 znika. Stałe przesunięcie między wariantem sufitowym a podłogowym przestaje więc obowiązywać globalnie i musi być rozstrzygane wyraz po wyrazie – dokładnie to robi analiza przypadków w części trzeciej dowodu twierdzenia 2 (rozplątanie spełnia postulaty Fraenkela), gdzie o tym, który z dwóch przypadków zachodzi, decyduje nwd(a, b).
\[ \left\lfloor x + C\right\rfloor = \left\lfloor x\right\rfloor + C \]
(ostatnia tożsamość zachodzi dla każdego C ∈ ℤ). Dodatkowo, w analizie residuum sekwencji rozplątania wykorzystamy zależności wiążące największy wspólny dzielnik (nwd) z dziedziną ilorazu a/b. Dla a, b ∈ ℕ>0:
\[ \operatorname{nwd}(a,b) = b \iff \frac{a}{b} \in \mathbb{N} \]
a w przeciwnym przypadku:
\[ 1 \leq \operatorname{nwd}(a,b) \leq \min(a,b) \]
Te dwa przypadki rozłącznie pokrywają całą interesującą nas dziedzinę – co pozwoli przeprowadzić dowód „przez przypadki“.
Operatory w zapisie formalnym
Operatory wprowadzone w języku zapytań mają swoje formalne odpowiedniki. Poniższa tabela wiąże zapis formalny (stosowany w dowodach) z symbolami spotykanymi w języku zapytań:
| Operacja | Symbol formalny | Symbol w języku zapytań |
|---|---|---|
| Rzutowanie | π | lista pól po SELECT |
| Selekcja | σ | warunek logiczny |
| Suma | Σ | + |
| Różnica | δ | - |
| Przeplot (splątanie) | φ | # |
| Rozplątanie i jego dopełnienie | Θ, ∼Θ | & , % |
| Agregacja i serializacja (AGSE) | Ψ | @ |
| Przesunięcie | τ | > |
Dla samodzielności dowodów przytaczam dwie definicje, do których będę się bezpośrednio odwoływał.
Przeplot φ(A, B) tworzy strumień wynikowy, którego kolejne krotki wyznacza reguła:
\[ c_{n}= \left\{ \begin{array}{cc} b_{n-\left\lfloor n z \right\rfloor } & \left\lfloor n z \right\rfloor = \left\lfloor \left( n+1\right) z \right\rfloor \\ a_{\left\lfloor n z \right\rfloor } & \left\lfloor n z \right\rfloor \neq \left\lfloor \left( n+1\right) z \right\rfloor \end{array} \right. , \ z = \frac{\Delta _{b}}{\Delta _{a}+\Delta _{b}}, \ \Delta _{c}=\frac{\Delta _{a}\Delta _{b}}{\Delta _{a}+\Delta _{b}} \]
Rozplątanie definiują dwa komplementarne wzory – operator Θ odtwarzający pierwotny strumień oraz operator ∼Θ wyznaczający „resztę“ rozplątania:
\[ a_{n} = c_{n+ \left\lceil \frac{(n+1)\Delta _{a}}{\Delta _{b}} \right\rceil },\ \Delta _{a}=\frac{\Delta _{c}\Delta _{b}}{\left\vert \Delta _{c}-\Delta _{b}\right\vert } \]
\[ b_{n} = c_{n+\left\lfloor \frac{n\Delta_{b}}{\Delta_{a}}\right\rfloor},\ \Delta_{b}=\frac{\Delta_{c}\Delta_{a}}{\left\vert \Delta_{c}-\Delta_{a}\right\vert } \]
Twierdzenie 1: przeplot zapewnia pokrycie zbiorów
✅ Uwaga
Twierdzenie. Operacja splątania (przeplotu) zapewnia sekwencyjne pokrycie obu zbiorów indeksów strumieni danych będących jej argumentami: każdy element strumienia A i każdy element strumienia B zostaje wybrany dokładnie raz, po kolei, bez przerw i bez powtórzeń.
Dowód. Ponieważ 0 < z < 1, przyrost
\[ d_{n} := \left\lfloor \left( n+1\right) z \right\rfloor - \left\lfloor n z \right\rfloor \]
dla każdego n ≥ 0 równy jest 0 albo 1. Równanie przeplotu wybiera element strumienia B dokładnie w tych krokach, w których dn = 0 (gałąź równości), a element strumienia A dokładnie w krokach z dn = 1.
Rozważmy indeks wyboru z ciągu B: xn = n − ⌊nz⌋. W jednym kroku xn+1 − xn = 1 − dn: indeks rośnie o dokładnie 1 w każdym kroku wybierającym z B, a poza tym pozostaje bez zmian. Jeśli więc n < n′ są dwoma kolejnymi krokami wybierającymi z B, to xn′ = xn + 1. Pierwszym krokiem wybierającym z B jest n = 0, gdyż z 0 < z < 1 wynika ⌊0⌋ = ⌊z⌋ = 0, czyli d0 = 0, a przy tym x0 = 0. Wybory z ciągu B używają zatem indeksów 0, 1, 2, … po kolei, bez przerw i powtórzeń.
Symetrycznie: indeks wyboru z ciągu A, czyli ⌊nz⌋, rośnie o dokładnie 1 w każdym kroku wybierającym z A (dn = 1), a poza tym pozostaje bez zmian; w pierwszym takim kroku jego wartość wynosi 0 (wszystkie wcześniejsze kroki mają d = 0). Elementy ciągu A również są więc wybierane dokładnie raz każdy, po kolei. ∎
Twierdzenie 2: rozplątanie spełnia postulaty Fraenkela
To jest centralne twierdzenie tej strony. Dowodzi, że obie sekwencje opisujące operację rozplątania są szczególnym przypadkiem sekwencji Beatty spełniającym postulaty twierdzenia Fraenkela dla liczb wymiernych. Bez tego twierdzenia cały system pozostaje jedynie obietnicą.
✅ Uwaga
Twierdzenie. Niech a, b ∈ ℕ>0 reprezentują wymierny stosunek temp strumieni składowych, ∆a/∆b = a/b. Obie sekwencje wyboru krotek opisujące operację rozplątania są – z dokładnością do wyrównania indeksów wskazanego w dowodzie – szczególnym przypadkiem sekwencji Beatty spełniającym postulaty twierdzenia Fraenkela dla parametrów wymiernych. W konsekwencji dokonują one podziału zbioru ℕ₀ := ℕ ∪ {0}, czyli zbioru indeksów strumienia splątanego, a rozplątanie dokładnie odwraca splątanie przy użyciu wyłącznie arytmetyki liczb wymiernych.
Dowód – część pierwsza (sprowadzenie do postaci Beatty). Sekwencja wyboru krotek residuum rozplątania (operator ∼Θ) ma postać:
\[ \left( n + \left\lfloor \frac{nb}{a} \right\rfloor \right) _{n=0}^{\infty } \]
Jej wyraz początkowy (n = 0) wynosi 0; wyrazy dla n ≥ 1 tworzą część Beatty. Dla n ∈ ℕ, na mocy własności ⌊x + C⌋ = ⌊x⌋ + C, zachodzi n + ⌊nb/a⌋ = ⌊n + nb/a⌋, poszukujemy więc α, α′ takich, że:
\[ \left( \left\lfloor \frac{n-\alpha ^{\prime }}{\alpha }\right\rfloor \right) _{n=1}^{\infty } = \left( \left\lfloor n\frac{a + b}{a} \right\rfloor \right) _{n=1}^{\infty } \]
Odczytując nachylenie i wyraz wolny: przy przesunięciu α′ = 0 otrzymujemy α = a/(a+b), a sekwencja wyboru ograniczona do n ≥ 1 to dokładnie:
\[ \mathcal{B}\!\left( \frac{a}{a + b}, 0 \right) = \left( \left\lfloor n\frac{a + b}{a} \right\rfloor \right) _{n=1}^{\infty } \]
Dowód – część druga (weryfikacja pięciu postulatów i wyznaczenie residuum). Sprawdzamy kolejno postulaty twierdzenia Fraenkela dla α = a/(a+b), α′ = 0:
- Wartość α = a/(a+b) dla a, b > 0 jest większa od zera i mniejsza od jedności.
- Warunek α + β = 1 jest spełniony dla β = b/(a+b).
- Dla α′ = 0 postulat jest równoważny postulatowi 1.
- Postulat jest pusty, gdyż α jest liczbą wymierną.
- Najmniejszą liczbą q, dla której qα ∈ ℕ, jest q = (a+b)/nwd(a,b); wówczas warunek 1/q ≤ α + α′ = α jest spełniony, a warunek ⌈qα′⌉ + ⌈qβ′⌉ = 1 przy α′ = 0 wymusza ⌈qβ′⌉ = 1, czyli 0 < β′ ≤ nwd(a,b)/(a+b). Każda dopuszczalna wartość generuje tę samą sekwencję (dopełnienie sekwencji B(a/(a+b), 0) w ℕ jest jednoznaczne); przyjmujemy β′ = nwd(a,b)/(a+b).
Sekwencją dopełniającą sekwencję B(a/(a+b), 0) w sensie postulatów Fraenkela jest zatem:
\[ \mathcal{B}\!\left( \frac{b}{a + b}, \frac{\operatorname{nwd}(a, b)}{a + b} \right) \]
Po przeindeksowaniu n ↦ n + 1, tak aby biegła od n = 0 – zgodnie z sekwencjami wyboru w definicji rozplątania – przyjmuje ona postać:
\[ \left( \left\lfloor \frac{(n + 1) - \frac{\operatorname{nwd}(a,b)}{a+b}}{\frac{b}{a+b}} \right\rfloor \right) _{n=0}^{\infty } \]
Rozwijając powyższe wyrażenie:
\[ \left\lfloor \frac{(n + 1) - \frac{\operatorname{nwd}(a,b)}{a+b}}{\frac{b}{a+b}} \right\rfloor = \left\lfloor n\frac{a}{b} + n + \frac{a}{b} + 1 - \frac{\operatorname{nwd}(a, b)}{b} \right\rfloor \]
Porównując to – wyraz po wyrazie dla n ≥ 0 – z sekwencją wyboru krotek strumienia odtwarzanego (operator Θ):
\[ \left( n + \left\lceil \frac{(n + 1)a}{b} \right\rceil \right) _{n=0}^{\infty } \]
i wydzielając część całkowitą n + 1 na mocy własności ⌊x + C⌋ = ⌊x⌋ + C, teza sprowadza się (po podstawieniu n w miejsce n + 1, tak że n przebiega zbiór ℕ>0) do tożsamości:
\[ \left\lfloor n\frac{a}{b} - \frac{\operatorname{nwd}(a, b)}{b} \right\rfloor + 1 = \left\lceil n\frac{a}{b} \right\rceil ,\quad n \in \mathbb{N}_{>0} \]
Dowód – część trzecia (analiza przypadków). Korzystając z własności współczynnika nwd(a, b), rozważamy dwa rozłączne przypadki pokrywające całą dziedzinę.
Przypadek 1: nwd(a, b) = b, czyli a/b ∈ ℕ. Wtedy n·a/b ∈ ℕ, więc na mocy tożsamości ⌊x⌋ = ⌈x⌉ ⟺ x ∈ ℤ mamy ⌈n·a/b⌉ = ⌊n·a/b⌋, a na mocy ⌊x + C⌋ = ⌊x⌋ + C:
\[ \left\lfloor n\frac{a}{b} - 1 \right\rfloor + 1 = \left\lfloor n\frac{a}{b} \right\rfloor \]
Obie strony dowodzonej tożsamości pokrywają się.
Przypadek 2: b ∤ a, czyli 1 ≤ nwd(a, b) < b oraz 0 < nwd(a,b)/b < 1.
Jeśli n·a/b ∉ ℤ, to na mocy ⌊x⌋ + 1 = ⌈x⌉ ⟺ x ∈ ℝ ∖ ℤ zachodzi ⌈n·a/b⌉ = ⌊n·a/b⌋ + 1. Część ułamkowa liczby n·a/b jest niezerową wielokrotnością nwd(a,b)/b, a więc wynosi co najmniej nwd(a,b)/b; odjęcie nwd(a,b)/b od n·a/b nie może zatem przekroczyć w dół liczby całkowitej poniżej ⌊n·a/b⌋, skąd:
\[ \left\lfloor n\frac{a}{b} - \frac{\operatorname{nwd}(a, b)}{b} \right\rfloor = \left\lfloor n\frac{a}{b} \right\rfloor \]
i dowodzona tożsamość zachodzi.
Jeśli n·a/b ∈ ℤ, to ⌈n·a/b⌉ = n·a/b, a ponieważ 0 < nwd(a,b)/b < 1:
\[ \left\lfloor n\frac{a}{b} - \frac{\operatorname{nwd}(a, b)}{b} \right\rfloor = n\frac{a}{b} - 1 \]
co ponownie daje dowodzoną tożsamość.
Obie sekwencje wyboru opisujące operację rozplątania są więc – z dokładnością do jednostkowego przeindeksowania z części drugiej – sekwencjami Beatty spełniającymi postulaty Fraenkela dla parametrów wymiernych: para B(a/(a+b), 0) i B(b/(a+b), nwd(a,b)/(a+b)) dokonuje podziału zbioru ℕ, a wraz z początkowym wyrazem residuum 0 z części pierwszej – podziału zbioru ℕ₀, pełnego zbioru indeksów strumienia splątanego. Strumień odtworzony i residuum są zatem dokładne. ∎
✅ Uwaga
Wniosek (dokładna odwracalność na liczbach wymiernych). Dla strumieni o tempach wymiernych operatory Θ i ∼Θ odtwarzają strumienie składowe φ(A, B) dokładnie (bit w bit): żadna krotka nie ginie, nie dubluje się ani nie zmienia kolejności względem swojego strumienia składowego. Para (φ; Θ, ∼Θ) zachowuje się więc jak mnożenie i dzielenie, a para (Σ; δ) jak dodawanie i odejmowanie w zbiorze regularnych serii czasowych.
⚠️ Ostrzeżenie
Praktyczny morał z tego dowodu: w implementacji nie wolno opuszczać dziedziny liczb wymiernych nawet na chwilę. Niejawne rzutowanie wyniku pośredniego na liczbę zmiennoprzecinkową łamie założenia powyższego twierdzenia. Materializację do postaci zmiennoprzecinkowej należy odłożyć do momentu jawnego zastosowania operacji podłogi lub sufitu.
Własności operatorów wykorzystywane w optymalizacji
W oparciu o przedstawioną algebrę można wykazać szereg własności strumieni danych. Mają one bezpośrednie zastosowanie w systemie zarządzania danymi – w trakcie optymalizacji planów zapytań oraz interpretacji wyników.
Zaburzenie kolejności zdarzeń
✅ Uwaga
Twierdzenie. Kolejność elementów w strumieniu nie odzwierciedla faktycznej kolejności występowania elementów w świecie rzeczywistym.
Dowód (przez kontrprzykład). Rozważmy dwa strumienie:
Alfa(znak),2:    {1,2,3,4,5,6,...}
Epsilon(znak),3: {a,b,c,d,e,f,...}
Wyrażenie φ(Epsilon, Alfa) tworzy strumień wynikowy:
Tau(znak),6/5: {1,2,a,3,b,4,5,c,6,d,...}
W strumieniu Tau krotka oznaczona literą c występuje po krotce oznaczonej cyfrą 5. Tymczasem krotka c pojawia się w strumieniu Epsilon w 9. sekundzie, a krotka 5 w strumieniu Alfa – w 10. sekundzie. Naturalny porządek zdarzeń został w strumieniu wynikowym naruszony. Wniosek: prowadząc analizę względem czasu zawartego w strumieniach, konieczne jest zastosowanie operacji rozplątania w celu uzyskania pierwotnej postaci strumieni danych. ∎
Przemienność sumowania
✅ Uwaga
Twierdzenie. Operacja sumowania strumieni danych, z pominięciem kolejności atrybutów, jest przemienna.
Dowód. Załóżmy ∆a ≤ ∆b; przypadek przeciwny jest symetryczny. Pierwszy przypadek definicji sumy daje jako n-ty element strumienia Σ(A, B) krotkę:
\[ c_{n} = \left( a_{n},\ b_{\left\lfloor n\Delta_{a}/\Delta_{b} \right\rfloor} \right) \]
natomiast dla Σ(B, A) role argumentów są zamienione i zastosowanie ma jej drugi (a przy ∆a = ∆b – pierwszy) przypadek, co daje n-ty element:
\[ c_{n} = \left( b_{\left\lfloor n\Delta_{a}/\Delta_{b} \right\rfloor},\ a_{n} \right) \]
Oba strumienie niosą ∆c = ∆a. Pokrywają się więc z dokładnością do kolejności sklejonych atrybutów. ∎
Metoda dopasowania przeplotu
Operacja przeplotu nie jest w ogólności przemienna: ponieważ 0 < z < 1, w punkcie n = 0 zawsze zachodzi gałąź równości w definicji przeplotu, więc strumień φ(A, B) zaczyna się od elementu b₀, a strumień φ(B, A) – od elementu a₀. Przeplot jest jednak ekwiwariantny względem przesunięć czasowych dopasowanych do temp strumieni – co jest cenne w optymalizacji planów zapytań.
W realizacji przyczynowej strumień ma postać \(\widehat{S}=((s_n,\Delta),W_S)\), gdzie \(W_S\) jest ogonem startowym. Przeliczenie ogona producenta na sloty wyjścia definiujemy jako:
\[ \operatorname{conv}(w,\Delta_s,\Delta_o):= \left\lceil\frac{w\Delta_s}{\Delta_o}\right\rceil \]
Ogon przeplotu o interwale \(\Delta_c=\Delta_a\Delta_b/(\Delta_a+\Delta_b)\) wyprowadza się wprost z definicji operatora, bez pośrednictwa jednego członu fazowego.
Rekord \(i\) strumienia \(\varphi(A,B)\) niesie treść rekordu \(j(i)\) jednej ze składowych - tej, którą w slocie \(i\) wybiera definicja przeplotu. Oznaczmy przez \(\Delta_{s(i)}\) i \(W_{s(i)}\) interwał oraz ogon wybranej składowej. Rekord \(j(i)\) jest określony w chwili \(\bigl(j(i)+1+W_{s(i)}\bigr)\Delta_{s(i)}\), a slot \(i\) konsumenta kończy się w chwili \((i+1+W)\Delta_c\). Warunek przyczynowości dla każdego \(i\):
\[ W\ge \left\lceil\frac{\bigl(j(i)+1+W_{s(i)}\bigr)\Delta_{s(i)}}{\Delta_c}\right\rceil -1-i \]
Niech \(\Delta_a/\Delta_b=p/q\), gdzie \(p,q\in\mathbb{N}_{>0}\) i \(\gcd(p,q)=1\). Zarówno wybór składowej, jak i reszta wyznaczająca \(j(i)\) powtarzają się z okresem \(p+q\), więc maksimum prawej strony po jednym okresie jest maksimum po wszystkich rekordach:
\[ W_{\varphi(A,B)} =\max_{0\le i<p+q}\left( \left\lceil\frac{\bigl(j(i)+1+W_{s(i)}\bigr)\Delta_{s(i)}}{\Delta_c}\right\rceil -1-i \right) \]
Wzór jest dokładny: nie zawyża ani nie zaniża granicy zdarzeniowej dla żadnego węzła. Przegląd okresu zaczyna się od zera - początek logiczny przesuwa indeks konsumenta i indeks składowej o tę samą liczbę slotów, więc okno \([0,,p+q)\) daje tę samą wartość co okno przesunięte.
Wcześniejsza postać zamknięta
\[ W_{\varphi(A,B)} =\max\left( \operatorname{conv}(W_A,\Delta_a,\Delta_c), \operatorname{conv}(W_B,\Delta_b,\Delta_c) +H_{a,b} \right), \qquad H_{a,b}=\left\lceil\frac{p+q-1}{p}\right\rceil \]
zabezpieczała najgorszą fazę odczytu drugiego argumentu, ale nie sprawdzała, czy ta faza w ogóle wypada na rekord czekający najdłużej - dlatego zawyżała ogon o slot dla części węzłów. Pozostała w implementacji jako wariant awaryjny dla \(p+q\) powyżej progu przeglądu (kHashPhaseScanLimit w SOperations.hpp): zawyżenie kosztuje jeden slot opóźnienia, podczas gdy zaniżenie oznaczałoby rekord wyemitowany przed określeniem jego zależności. Sloty ogona nie są rekordami.
Przesunięcie \(\tau_m\) nie zmienia emitowanego ciągu rekordów, ale zmienia indeks, pod którym ten ciąg się pojawia: rekord \(n\) niesie treść rekordu \(n-m\). Rekordy o indeksie mniejszym od \(O_S+m\) nie mają definicji, więc
\[ O_{\tau_m(S)}=O_S+m, \qquad W_{\tau_m(S)}=\max\left(0,;W_S-m\right) \]
Ogon maleje: rekord \(n-m\) jest starszy od bieżącego, więc dostępny tym bardziej - deficyt slotu wynosi \(W_S-m\) i jest stały. Szczegóły i pomiar: Ogony, początki logiczne i obserwowalność operatorów.
✅ Uwaga
Twierdzenie (R1, przemienność przesunięcia z przeplotem). Jeśli liczby i, k ∈ ℕ wybrano tak, że i·∆a = k·∆b (oba argumenty przesunięte o ten sam czas), to przeplot strumieni przesuniętych i przeplot strumieni pierwotnych przesunięty o sumę tych liczb mają ten sam ciąg rekordów, ten sam interwał i ten sam początek logiczny. Ich ogony spełniają nierówność - strona sfaktoryzowana nigdy nie jest późniejsza.
Formalnie, dla \(L:=i+k\):
\[ \operatorname{Obs}\Bigl(\varphi\bigl(\tau_{i}(A),\tau_{k}(B)\bigr)\Bigr) =\operatorname{Obs}\Bigl(\tau_{i+k}\bigl(\varphi(A,B)\bigr)\Bigr), \qquad i\Delta_{a}=k\Delta_{b},\quad i,k\in\mathbb{N} \]
\[ W_{\mathrm{RHS}}=\max\left(0,;W_{\varphi(A,B)}-L\right)\le W_{\mathrm{LHS}} \]
gdzie \(\operatorname{Obs}\) jest częścią wartościową obserwacji (interwał, początek logiczny, ciąg rekordów z mapą NULL, deskryptor, ślad luk, polityka materializacji) - patrz Ogony, początki logiczne i obserwowalność operatorów.
Dowód.
Interwał. Obie strony powstają z tego samego przeplotu, więc mają \(\Delta_c=\Delta_a\Delta_b/(\Delta_a+\Delta_b)\).
Krok pomocniczy. Z założenia \(i\Delta_a=k\Delta_b\) wynika
\[ \frac{i\Delta_a}{\Delta_c} =\frac{i\Delta_a(\Delta_a+\Delta_b)}{\Delta_a\Delta_b} =\frac{i\Delta_a}{\Delta_b}+i =k+i =L\in\mathbb{N}, \]
i symetrycznie \(k\Delta_b/\Delta_c=L\). Przesunięcie każdego argumentu o jego własną liczbę slotów odpowiada więc tej samej liczbie \(L\) slotów wyniku.
Ciąg rekordów i początek logiczny. W jednym okresie przeplot pobiera \(i\) rekordów z A i \(k\) rekordów z B, wypełniając dokładnie \(L=i+k\) slotów C. Przesunięcie A o \(i\) i B o \(k\) przesuwa zatem próg odwzorowania obu składowych o dokładnie \(L\) slotów wyniku, nie zmieniając ich wzajemnej fazy: \(O_{\mathrm{LHS}}=O_{\varphi(A,B)}+L=O_{\mathrm{RHS}}\). Treść rekordu o danym indeksie logicznym jest po obu stronach ta sama, bo wybór składowej zależy wyłącznie od fazy, a ta jest niezmieniona.
Ogony. Niech \(s(n)\in\{A,B\}\) oznacza składową wybraną w fazie \(n\), a \(j(n)\) jej indeks. Oznaczmy przesunięcia przez \(t_A=i\) i \(t_B=k\). Po przesunięciu ogon składowej wynosi \(W_s^{\prime}=\max(0,W_s-t_s)\ge W_s-t_s\). Nie zmieniają się interwały ani wybór składowej i jej indeks w danej fazie przeplotu. Niech \(R_n\) będzie wymaganiem dostępności z powyższego wzoru fazowego dla ogonów \(W_A,W_B\), a \(R_n^{\prime}\) wymaganiem dla \(W_A^{\prime},W_B^{\prime}\). Z kroku pomocniczego mamy \(t_s\Delta_s/\Delta_c=L\in\mathbb{N}\) dla obu składowych. Monotoniczność sufitu i jego zgodność z przesunięciem o całkowite \(L\) dają w każdej fazie:
\[ \begin{aligned} R_n^{\prime} &=\left\lceil \frac{(j(n)+1+W_{s(n)}^{\prime})\Delta_{s(n)}}{\Delta_c} \right\rceil-1-n\\ &\ge\left\lceil \frac{(j(n)+1+W_{s(n)}-t_{s(n)})\Delta_{s(n)}}{\Delta_c} \right\rceil-1-n =R_n-L. \end{aligned} \]
Maksimum bierzemy po tym samym pełnym okresie \(p+q\), ponieważ przesunięcia nie zmieniają stosunku interwałów. Korzystając dodatkowo z nieujemności ogonów, otrzymujemy:
\[ W_{\mathrm{LHS}} \ge\max\left(0,\max_{0\le n<p+q}R_n-L\right) =\max\left(0,W_{\varphi(A,B)}-L\right) =W_{\mathrm{RHS}}. \]
Powyżej progu przeglądu silnik stosuje opisane wcześniej oszacowanie awaryjne \(O(1)\). Dla niego tę samą nierówność uzyskujemy przez monotoniczność obu członów \(\operatorname{conv}\): dopasowane przesunięcie zmniejsza każdy z nich najwyżej o \(L\), a składnik \(H_{a,b}\) pozostaje bez zmian. Obie strony korzystają z tego samego wariantu obliczeń, bo interwały się nie zmieniają. Oszacowanie awaryjne nie musi być równe dokładnemu maksimum fazowemu. ∎
⚠️ Zakres twierdzenia
Równość ogonów nie zachodzi. Kontrprzykład: \(\Delta_a=1/10\), \(\Delta_b=1/5\), \(W_A=W_B=0\), \(H_{a,b}=2\), \(i=2\), \(k=1\), \(L=3\). Wtedy \(W_{\mathrm{LHS}}=2\), a \(W_{\mathrm{RHS}}=\max(0,2-3)=0\). Strona niesfaktoryzowana czyta składowe po ich własnym przesunięciu, więc na tę samą treść czeka dłużej; strona sfaktoryzowana czyta ją wprost z przeplotu.
Konsekwencja praktyczna: reguła przepisywania \(\varphi(\tau_i(A),\tau_k(B))\to\tau_{i+k}(\varphi(A,B))\) jest optymalizacją opóźnienia, a nie przepisaniem neutralnym. Zachowuje całą część wartościową obserwacji i nigdy nie emituje rekordu przed określeniem jego zależności, ale wynik jest gotowy wcześniej.
Wcześniej obie strony miały ten sam ogon wyłącznie dlatego, że realizacja \(\tau_m\) zawyżała swój ogon o \(\min(W_S,m)\). Zawyżenie zdjęto, adresując producenta indeksem logicznym zamiast offsetem względnym. Regresje strzegące tego zakresu:
it_r1_identity_nulls,it_optimizer_ablation-factor-name-collision-semantic.
W kompilatorze dodatkowe niezmienniki zachowują nazwy pól publicznych strumieni, mapy wartości pustych i politykę materializacji.
Dlaczego to ma znaczenie
Przedstawione twierdzenia nie są formalnością dla samej formalności. Każde z nich pełni konkretną rolę w działającym systemie:
- Twierdzenie 1 i 2 gwarantują, że pary operacji przeplot/rozplątanie oraz suma/różnica są komplementarne – dane nie giną i nie powielają się w sposób niekontrolowany. To one pozwalają traktować te operacje jak mnożenie/dzielenie oraz dodawanie/odejmowanie w zbiorze regularnych serii czasowych.
- Twierdzenie 2 w szczególności udowadnia, że całą konstrukcję da się zrealizować wyłącznie na liczbach wymiernych – a więc deterministycznie i dokładnie na komputerze. To jest warunek, bez którego system RetractorDB nie mógłby istnieć.
- Twierdzenia o własnościach operatorów (przemienność sumowania, dopasowanie przeplotu, zaburzenie kolejności) dostarczają reguł przepisywania wyrażeń strumieniowych. Optymalizator planów zapytań korzysta z nich, aby przekształcać plany do postaci tańszej w realizacji, nie zmieniając wyniku.
Dział matematyki, w którym osadzone są te równania, to teoria układów pokrywających [4] w obszarze teorii liczb. Pełny formalizm wraz z kompletem dowodów przedstawiłem w pracy Deterministyczna metoda przetwarzania ciągów danych [3].
ℹ️ Info
Numeryczna weryfikacja powyższych równań – prototypy w języku Python operujące na liczbach wymiernych (biblioteka
Fraction) – znajduje się na stronie Implementacja modelu oraz w repozytorium github.com/michalwidera/equations.
Ogony, początki logiczne i obserwowalność operatorów
Wykonanie przyczynowe rozszerza strumień \(S=(s_n,\Delta_S)\) o dwie wielkości całkowite, a nie o jedną. Rozróżnienie jest istotne, bo odpowiadają na różne pytania i różnie zachowują się przy przepisaniach planu.
| Wielkość | Pytanie | Znaczenie |
|---|---|---|
| początek logiczny \(O_S\) | którego rekordu nie ma? | indeks pierwszego rekordu, który w ogóle istnieje; rekordy o mniejszym indeksie nie mają definicji, bo sięgałyby przed początek strumienia źródłowego |
| ogon startowy \(W_S\) | kiedy rekord jest gotowy? | rekord \(n\) jest emitowany w chwili \((n+1+W_S)\Delta_S\) |
Żadna z nich nie jest prefiksem zer ani rekordów all-null. Zasada brzegu obowiązuje bez zmian: NULL jest wartością danych, nigdy rezerwacją miejsca. Liczba początkowych slotów, w których strumień milczy, wynosi \(O_S+W_S\) - i tylko ta suma była widoczna przed rozdzieleniem obu wielkości.
Indeks logiczny jest walutą wszystkich odwzorowań między strumieniami. Strumień o niezerowym \(O_S\) nie ma rekordów wcześniejszych, więc jego rekord fizyczny 0 nosi indeks logiczny \(O_S\); przeliczenie na offset w buforze wykonuje wyłącznie dataModel::fetchForward().
Audyt operatorów
W tabeli „własny ogon” oznacza opóźnienie wymagane przez operator ponad dostępność producentów. Ogony producentów są wcześniej przeliczane na sloty wyniku.
| Operator | Indeks źródłowy lub granica | Początek logiczny | Własny ogon | Test |
|---|---|---|---|---|
projekcja / PUSH_STREAM | bieżąca krotka | \(O_S\) | 0 | ut_compiler |
przesunięcie >N | rekord \(n-N\) | \(O_S+N\) | \(-N\), patrz niżej | ut_compiler, ut_h10aGate |
suma + | bieżące współindeksowane krotki | próg odwzorowania | 0 | ut_compiler |
przeplot # | rekord \(j(i)\) składowej wybranej w slocie \(i\) | próg odwzorowania | wzór niżej | deinterleave_roundtrip, ut_h10aGate |
lewy rozplot & (DIV) | \(n+\lceil(n+1)\Delta_a/\Delta_b\rceil\) | próg odwzorowania | wzór fazowy poniżej | deinterleave_roundtrip, ut_h10aGate |
prawy rozplot % (MOD) | \(n+\lfloor n\Delta_b/\Delta_a\rfloor\) | próg odwzorowania | wzór fazowy poniżej | deinterleave_roundtrip, ut_h10aGate |
różnica C-Delta | \(\lceil n\Delta/\Delta_C\rceil\) | próg odwzorowania | wzór fazowy poniżej | it_k19_boundaries, ut_h10aGate |
AGSE @(k,L) | pola od \(nk-(\lvert L\rvert-1)\) do \(nk\) | wzór niżej | wzór niżej | agse1, agse2, agse3, it_k19_boundaries, ut_h10aGate |
sumc, avgc, minc, maxc | bieżąca pełna krotka | \(O_S\) | 0 | ut_dataModel, it_k19_boundaries |
„Próg odwzorowania” oznacza najmniejszy indeks \(n\), od którego wszystkie dalsze rekordy trafiają odwzorowaniem w istniejące rekordy składowych. Nie jest to „pierwszy indeks o kompletnych zależnościach”: przy przeplocie składowych o różnych początkach rekord 0 może mieć komplet, a rekord 1 już nie. Strumień jest ciągiem rekordów, nie zbiorem z dziurami - zasada brzegu zabrania wypełnić lukę NULL-em - więc początkiem logicznym jest pierwszy indeks bez żadnej dalszej luki. Wszystkie odwzorowania rekord–rekord są niemalejące, więc taki indeks istnieje i jest jednoznaczny.
Różnica przyjmuje docelowy interwał \(\Delta\), który nie może być mniejszy od interwału źródła \(\Delta_C\). Dla stosunku \(r=\Delta/\Delta_C=p/q\) maksymalne wyprzedzenie fazowe indeksu \(\lceil nr\rceil\) wynosi \((q-1)/q\).
Ogony operatorów fazowych
Różnica oraz oba rozploty używają wspólnej reguły dostępności. Niech \(r=\Delta_{out}/\Delta_{src}\), \(W_S\) będzie ogonem źródła, a \(e_{max}\) - największą osiąganą fazą odwzorowania indeksu. Wtedy:
\[ W_{out}=\max\left(0, \left\lceil\frac{e_{max}+W_S+1}{r}\right\rceil-1 \right) \]
Dla różnicy \(e_{max}=(q-1)/q\), gdzie \(q\) jest mianownikiem skróconego stosunku \(r\). Dla lewego rozplotu, przy \(\Delta_{out}/\Delta_{other}=a/b\), wartość wynosi \(e_{max}=(a+b-1)/b\). Dla prawego rozplotu \(e_{max}=0\). Oznacza to między innymi, że lewy rozplot nie dodaje bezwarunkowo jednego slotu: dla stosunku całkowitego jego własny ogon może wynosić zero.
Ogon przeplotu
Przeplot jest jedynym operatorem, którego ogon nie rozkłada się na „przeliczone ogony producentów plus stała własna“. Rekord \(i\) niesie treść rekordu \(j(i)\) tylko jednej ze składowych - tej, którą w slocie \(i\) wybiera definicja operatora - więc wymagane opóźnienie zależy od tego, na którą składową i na którą jej fazę wypada dany slot:
\[ W_{\#} =\max_{0\le i<p+q}\left( \left\lceil\frac{\bigl(j(i)+1+W_{s(i)}\bigr)\Delta_{s(i)}}{\Delta_c}\right\rceil -1-i \right), \qquad \frac{\Delta_a}{\Delta_b}=\frac{p}{q},\quad \gcd(p,q)=1 \]
Wybór składowej i faza powtarzają się z okresem \(p+q\), więc maksimum po jednym okresie jest maksimum po wszystkich rekordach; początek logiczny przesuwa oba indeksy o tyle samo i nie zmienia wyniku. Wzór jest dokładny. Dla okresów przekraczających kHashPhaseScanLimit implementacja używa bezpiecznej postaci zamkniętej. Może ona opóźnić emisję, ale nie może dopuścić do emisji rekordu przed udostępnieniem jego zależności.
Przesunięcie \(\tau_N\)
Rekord \(n\) niesie treść rekordu \(n-N\) producenta. Stąd obie wielkości:
\[ O_{\tau_N(S)}=O_S+N, \qquad W_{\tau_N(S)}=\max\left(0,;W_S-N\right) \]
Ogon maleje, a nie rośnie. Rekord \(n-N\) jest starszy od bieżącego, więc jest dostępny tym bardziej: deficyt slotu \(n\) wynosi \((n-N+1+W_S)-(n+1)=W_S-N\) i jest stały, niezależny od \(n\). Przesunięcie przenosi więc milczenie z ogona do początku logicznego i dodatkowo pochłania ogon producenta, gdy \(N\ge W_S\).
Suma \(O+W\) nie jest przy tym niezmiennikiem: dla \(N<W_S\) wynosi \(N+W_S-N=W_S\) po lewej, a była \(W_S+N\) w realizacji sprzed rozdzielenia wielkości. Wcześniejsza realizacja zawyżała ogon o \(\min(W_S,N)\); zawyżenie zdjęto, adresując producenta indeksem logicznym zamiast offsetem względnym.
Pełne okno AGSE
Okno jest stemplowane końcem przedziału: rekord \(n\) obejmuje spłaszczone pozycje źródła od \(nk-(\lvert L\rvert-1)\) do \(nk\). Dzięki temu jego najnowsze pole leży dokładnie w pozycji \(nk\), a indeks logiczny okna oznacza tę samą chwilę co indeks logiczny źródła - złączenie okna z jego własnym źródłem (potok FIR) nie wyprzedza sygnału.
Ceną konwencji jest to, że dla małych \(n\) okno sięgałoby przed początek źródła. Te rekordy nie powstają. Niech źródło ma \(F\) pól i początek logiczny \(O_S\); warunek zmieszczenia się całego okna daje
\[ O_{\operatorname{AGSE}} =\left\lceil\frac{O_S F+\lvert L\rvert-1}{k}\right\rceil \]
O dostępności decyduje pole najnowsze, leżące w rekordzie \(\lfloor nk/F\rfloor\). Podstawiając \(r_n=(nk)\bmod F\) warunek dostępności dla każdego \(n\) przyjmuje postać \(W\ge\bigl(F(1+W_S)-r_n\bigr)/k-1\). Reszty \(r_n\) przebiegają wielokrotności \(\gcd(F,k)\) okresowo, więc minimum \(r_n=0\) jest osiągane niezależnie od tego, od którego \(n\) zaczyna się strumień. Stąd
\[ W_{\operatorname{AGSE}} =\left\lceil\frac{(1+W_S)F}{k}\right\rceil-1 \]
Człon fazowy \(P_{F,k,L}=\lfloor(\lvert L\rvert-1)/g\rfloor,g\), obecny w postaci sprzed przestemplowania, zniknął z ogona: rozpiętość okna nie jest czekaniem, tylko niedefiniowalnością, i przeszła w całości do początku logicznego. Suma \(O+W\) opisuje to samo milczenie co poprzednio.
Dodatnia szerokość zachowuje historyczną konwencję RetractorDB - najnowsze pole jest pierwsze; ujemna szerokość daje odbicie lustrzane, czyli kolejność napływu.
Pojemność historii źródła nie ma tu postaci zamkniętej. Odległość wsteczna w chwili emisji rekordu \(n\),
\[ \left\lfloor\frac{(n+1+W)k}{F}\right\rfloor-W_S-1 ;-; \left\lfloor\frac{nk-\lvert L\rvert+1}{F}\right\rfloor, \]
jest okresowa o okresie \(F/\gcd(F,k)\) slotów wyjścia, więc maksimum liczy się dokładnie, przeglądając jeden pełny okres od \(O_{\operatorname{AGSE}}\). Postać zamknięta byłaby w tym miejscu domysłem, a zaniżenie oznacza odczyt poza historią, nie tylko slot opóźnienia. Źródło deklarowane ma rekord uzbrojony przy otwarciu storage i zerowy prefetch, dlatego jego granica pojemności zawiera dwa dodatkowe rekordy. Pojemność jest własnością wykonania, nie częścią wyniku.
Relacja obserwowalności
Obserwacja strumienia rozpada się na dwie części, bo przepisania planu zachowują je w różnym stopniu.
Część wartościowa - zachowywana przez przepisania dokładnie:
\[ \operatorname{Obs}(S) =\left(\Delta_S,O_S,D_S,(s_n,N_n)_{n\ge O_S},G_S,M_S\right) \]
gdzie:
- \(O_S\) jest początkiem logicznym, czyli indeksem pierwszego rekordu;
- \(D_S\) jest publicznym deskryptorem i kolejnością nazw pól;
- \(N_n\) jest mapą
NULLrekordu - prawdziwyNULLpozostaje wartością danych i jest przenoszony przez AGSE; - \(G_S\) jest śladem luk; obecnie detekcja działa dla deklaracji, a dla strumieni obliczanych obowiązuje \(G_S=\varnothing\);
- \(M_S\) opisuje politykę materializacji (
DEFAULT,MEMORY,VOLATILEi pozostałe storage).
Część opóźnieniowa - ogon \(W_S\) - podlega słabszej gwarancji:
przepisanie planu nigdy nie zwiększa \(W_S\) i nigdy nie emituje rekordu przed określeniem jego zależności; wolno mu natomiast \(W_S\) zmniejszyć.
Rozdzielenie nie jest formalnością. Faktoryzacja \(R_1\) (\(\varphi(\tau_i(A),\tau_k(B))\to\tau_{i+k}(\varphi(A,B))\)) zachowuje całą część wartościową, ale skraca ogon: postać sfaktoryzowana czyta treść bezpośrednio z przeplotu, podczas gdy postać niefaktoryzowana czyta składowe dopiero po ich własnym przesunięciu. Uzasadnienie: Formalne podstawy i dowody, twierdzenie o przemienności przesunięcia z przeplotem. Regresje: it_r1_identity_nulls, it_optimizer_ablation-factor-name-collision-semantic.
Zmiana którejkolwiek składowej części wartościowej zmienia obserwowalny artefakt. W szczególności przyszłe włączenie propagacji luk w strumieniach obliczanych wymaga wersjonowanej zmiany semantyki.
Odczyt poza dostępną historią zwraca wewnętrznie rekord all-null jako bezpiecznik. Poprawnie skompilowany plan nigdy go nie materializuje: logicalOrigin pomija sloty bez definicji, startupLatency - sloty jeszcze nieokreślone, a pojemność historii zachowuje każdy wymagany indeks. Test it_k19_boundaries rozróżnia ten przypadek od prawdziwego NULL znajdującego się wewnątrz pełnego okna. Od 23 września 2026 konwencja obowiązuje na całej drodze odczytu: storage::read() i storage::revRead() zgłaszają brak rekordu osobnym statusem i również ustawiają wzorzec all-null, więc reduktor taki rekord pochłania, a nie składa z niego zera (→ Pliki).
Wzory operatorowe z tego rozdziału są egzekwowane przy każdym commicie: granice i obserwowalność przez it_k19_boundaries, głębokości historii przez it_k24_capacity, a zgodność początku logicznego i ogona wszystkich kanonicznych klas operatorów oraz ich złożeń przez test jednostkowy ut_h10aGate.
Wyrażenia algebraiczne
Zdefiniowana algebra pociąga za sobą możliwość definicji wyrażeń algebraicznych. Typowe wyrażenia algebraiczne w zbiorze liczb wymiernych to materiał przerabiany w szkole podstawowej. Wyrażenia algebraiczne w systemie RetractorDB występują w dwóch formach. Na liście pól polecenia SELECT – mamy wyrażenia typowe, znane ze szkoły podstawowej. Na liście argumentów polecenia SELECT w klauzuli FROM mamy wyrażenie algebraiczne zbudowane w oparciu o nową, zdefiniowaną algebrę.
Oznacza to że na liście pól po klauzuli SELECT operator plus oznacza jedno a w klauzuli FROM – oznacza zupełnie coś innego. Niewinnie wyglądające zapytanie z definicji łączy dwa zupełnie inne światy i pojęcia. Jeden algebry opartej na liczbach drugiej opartej na regularnych seriach czasowych.
Przykład. Jako przykład przedstawione zostanie wyrażenie algebraiczne zbudowane w zbiorze regularnych serii czasowych (zwanych dalej strumieniami). Zakładając istnienie dwóch strumieni: A(a1 int, a2 int),1 oraz B(b1 int),½ – gdzie,
- A oznacza strumień zawierający w każdym rekordzie dwa pola o wartościach typu int – a1 oraz a2, napływające raz na sekundę, oraz
- B zawierający w każdym rekordzie pole typu int o nazwie b1 napływające dwa razy na sekundę.
To wyrażenie algebraiczne postaci C=A+B stworzy strumień danych o polach C(a1 int, a2 int, b1 int),½.
Aby dokonać przeplotu strumienia danych zbiory A i B powinny posiadać te same schematy danych. Załóżmy więc że istnieje strumień D(d1 int),1 – napływający podobnie jak strumień A – raz na sekundę.
To wyrażenie algebraiczne postaci E=B#D stworzy strumień: E(e1 int),⅓. Szybkość ⅓ bierze się ze wzoru (1*½)/(1+½). Wzór znajdziesz przy definicji operacji przeplotu.
W tak zdefiniowanych strumieniach nadal poprawne jest wyrażenie:
F=((B#D)+A)>2
I takie wyrażenia mogą się pojawić jako poprawne względem opracowanej algebry szeregów czasowych w treści zapytania.
Dalsze przykłady
Pozostając przy zdefiniowanych powyżej strumieniach A(a1 int, a2 int),1, B(b1 int),½ i D(d1 int),1 oraz strumieniach wynikowych C=A+B i E=B#D – poniżej zestawiono kolejne poprawne wyrażenia algebraiczne. Odpowiedniki wszystkich tych wyrażeń występują w klauzulach FROM zapytań w testach integracyjnych systemu i są weryfikowane przy każdej kompilacji projektu.
Przeplot wyniku przeplotu:
G=E#D
Strumień E ma szybkość ⅓, strumień D szybkość 1, oba mają zgodny schemat z jednym polem int. Wzór z definicji przeplotu daje szybkość (⅓·1)/(⅓+1)=¼, więc G(g1 int),¼. Wynik jednej operacji jest pełnoprawnym strumieniem i może być argumentem kolejnej.
Suma trzech strumieni:
H=A+B+D
Suma skleja krotki, więc schemat wyniku to konkatenacja schematów, a tempo narzuca najszybszy składnik: H(a1 int, a2 int, b1 int, d1 int),½.
Suma z przesuniętym składnikiem oraz przesunięcie argumentu przeplotu:
I=D+((A+B)>1)
J=(B>1)#D
Przesunięcie sekwencji nie zmienia szybkości strumienia – zmienia tylko dostęp do danych o zadaną liczbę próbek. Dlatego I ma szybkość min(1,½)=½, a J – tak jak E – szybkość ⅓.
Rozplątanie:
K=E&1
L=E%½
Prawym argumentem operatorów rozplątania jest liczba wymierna, nie strumień. Podstawiając do wzorów z definicji rozplątania: K ma szybkość (⅓·1)/|⅓−1|=½ – rozplątanie lewostronne odzyskuje ze splotu E strumień B. Analogicznie L ma szybkość (⅓·½)/|⅓−½|=1 – rozplątanie prawostronne odzyskuje strumień D. Rozplątanie jest odwrotnością przeplotu, tak jak dzielenie jest odwrotnością mnożenia.
Różnica:
M=C-1
Różnica jest operacją odwrotną do sumy – wydobywa ze sklejonego strumienia C składnik wskazany liczbą wymierną po prawej stronie operatora.
Agregacja i serializacja:
N=A@(1,4)
P=A@(1,-4)
R=A@(2,2)
S=(A@(2,2))@(1,1)
N tworzy ruchome okno szerokości 4 przesuwane o jeden element, P – dzięki ujemnej szerokości – buduje te same okna w odbiciu lustrzanym, R tworzy okna rozłączne (skok równy szerokości). Wyrażenie S pokazuje, że wynik operacji Agse może być argumentem kolejnej operacji Agse.
Wszystkie powyższe formy można łączyć w dowolnie złożone wyrażenia – jak F=((B#D)+A)>2 z przykładu powyżej – o ile schematy danych argumentów spełniają wymagania poszczególnych operacji.
Pokrycie przykładów w testach integracyjnych
Każda z przytoczonych form wyrażeń ma swój odpowiednik we wspólnym katalogu test/IntegrationTest repozytorium RetractorDB, wykonywany przy każdej kompilacji projektu:
| Wyrażenie z rozdziału | Forma w teście | Test integracyjny |
|---|---|---|
| C=A+B (suma) | s1+s2, core0+core1 | IntegrationTest/issue167_dedup_positive, IntegrationTest/Data (all-operators) |
| E=B#D (przeplot) | core0#core1 | IntegrationTest/operations, IntegrationTest/Data (all-operators) |
| G=E#D (przeplot kaskadowy) | (s1#s2)#s3, s1#s2#s3 | IntegrationTest/issue167_triarg |
| H=A+B+D (suma wieloargumentowa) | s1+s2+s3, s1+s2+s3+s4 | IntegrationTest/issue167_triarg |
| I=D+((A+B)>1) | s3+((s1+s2)>1) | IntegrationTest/issue167_dedup_cascaded |
| J=(B>1)#D oraz (B#D)>1 | (core1>1)#core2, (core1#core2)>1 | IntegrationTest/subquery |
| K=E&1, L=E%½ (rozplątanie) | core0&1.5, core0%4 | IntegrationTest/Data (all-operators) |
| M=C−1 (różnica) | core0-1/2 | IntegrationTest/Data (all-operators) |
| przesunięcie sumy, jak w F | (s1+s2)>1, (core0+core1)>5 | IntegrationTest/issue167_dedup_field_names, IntegrationTest/issue56_timeshift |
| N=A@(1,4), P=A@(1,−4), R=A@(2,2) | core1@(1,4), core1@(1,-4), core1@(2,2) | IntegrationTest/agse1 (dalsze warianty skoku i szerokości: agse2, agse3) |
| S=(A@(2,2))@(1,1) (Agse kaskadowe) | signalText3@(1,1) | IntegrationTest/agse1 |
Testy porównują wyniki wykonania zapytań z plikami wzorcowymi (pattern), więc powyższe wyrażenia są weryfikowane nie tylko składniowo, ale i co do wartości oraz szybkości strumieni wynikowych.
Implementacja modelu
Opracowane równania algebry zaimplementowano pierwotnie w języku Python. Jest to znany mi najbardziej efektywny sposób modelowania i numerycznego weryfikowania hipotez. Każdy z operatorów został zaimplementowany wewnątrz osobnej funkcji. Operacje realizowane na zmiennych wymiernych (biblioteka Fraction). Wyniki prezentowane są w postaci ograniczonych tablic. Operatory te jednak w końcowej implementacji realizują operacje na nieskończonych strukturach danych.
Operacja przeplotu
Na początku zbudujmy operację przeplotu:
Kod źródłowy
# Operacja splątania (hash) dwóch list z określonymi krokami (delta).
from fractions import Fraction
from math import floor, ceil

A = range(1, 24)
deltaA = Fraction(1, 2)
B = list(map(chr, range(ord('a'), ord('z')+1)))
deltaB = Fraction(1, 2)

def hash(A: list, deltaA: Fraction, B: list, deltaB: Fraction):
  result = []
  delta = deltaB / (deltaA + deltaB)
  for i in range(0, 20):
      if floor(i*delta) == floor((i+1)*delta):
          result.append(B[i-int(floor((i+1)*delta))])
      else:
          result.append(A[int(floor(i*delta))])
  deltaC = (deltaA*deltaB)/(deltaA+deltaB)
  return result, deltaC

def main():
    print("A:", A[0:10], " deltaA:", deltaA)
    print("B:", B[0:10], " deltaB:", deltaB)
    hash_result1, delta_hash1 = hash(A, deltaA, B, deltaB)
    hash_result2, delta_hash2 = hash(B, deltaB, A, deltaA)
    print("Hash(A,B):", hash_result1[0:10], " deltaHash:", delta_hash1)
    print("Hash(B,A):", hash_result2[0:10], " deltaHash:", delta_hash2)

if __name__ == '__main__':
    main()
Efekt uruchomienia
$ python hash.py
A: range(1, 11) deltaA: 1/2
B: ['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h', 'i', 'j'] deltaB: 1/2
Hash(A,B): ['a', 1, 'b', 2, 'c', 3, 'd', 4, 'e', 5] deltaHash: 1/4
Hash(B,A): [1, 'a', 2, 'b', 3, 'c', 4, 'd', 5, 'e'] deltaHash: 1/4
Kod po uruchomieniu przedstawi dane wejściowe A oraz B - oraz wyniki operacji A#B oraz B#A. Jak widać operacja przeplotu nie jest przemienna.
Operacja rozplątania
Operacja rozplątania wymaga zaimplementowania dwóch komplementarnych operacji.
Kod źródłowy - even
# Operacja rozplątania (dehash) even.
from fractions import Fraction
from math import floor, ceil

A = range(1, 24)
deltaA = Fraction(1, 2)
B = list(map(chr, range(ord('a'), ord('z')+1)))
deltaB = Fraction(1, 2)

def hash(A: list, deltaA: Fraction, B: list, deltaB: Fraction):
  result = []
  delta = deltaB / (deltaA + deltaB)
  for i in range(0, 20):
      if floor(i*delta) == floor((i+1)*delta):
          result.append(B[i-int(floor((i+1)*delta))])
      else:
          result.append(A[int(floor(i*delta))])
  deltaC = (deltaA*deltaB)/(deltaA+deltaB)
  return result, deltaC

def dehasheven(C: list, deltaC: Fraction, deltaA: Fraction):

  result = []
  deltaB = deltaA*deltaC / (deltaA - deltaC)

  for i in range(0, 6):
      result.append(C[i+int(ceil((i+1)*deltaA/deltaB))])
  return result, deltaB

def main():
    hash_result, delta_hash = hash(B, deltaB, A, deltaA)
    print("Hash(A,B):", hash_result[0:10], " deltaHash:", delta_hash)
    mod_result, delta_mod = dehasheven(hash_result, delta_hash, deltaA)
    print("Mod(Hash):", mod_result[0:10], " deltaMod:", delta_mod)

if __name__ == '__main__':
    main()
wynik - even
$ python dehash_even.py
Hash(A,B): [1, 'a', 2, 'b', 3, 'c', 4, 'd', 5, 'e'] deltaHash: 1/4
Mod(Hash): ['a', 'b', 'c', 'd', 'e', 'f'] deltaMod: 1/2
Kod źródłowy - odd
# Operacja rozplątania (dehash) odd.
from fractions import Fraction
from math import floor, ceil

A = range(1, 24)
deltaA = Fraction(1, 2)
B = list(map(chr, range(ord('a'), ord('z')+1)))
deltaB = Fraction(1, 2)

def hash(A: list, deltaA: Fraction, B: list, deltaB: Fraction):
  result = []
  delta = deltaB / (deltaA + deltaB)
  for i in range(0, 20):
      if floor(i*delta) == floor((i+1)*delta):
          result.append(B[i-int(floor((i+1)*delta))])
      else:
          result.append(A[int(floor(i*delta))])
  deltaC = (deltaA*deltaB)/(deltaA+deltaB)
  return result, deltaC

def dehashodd(C: list, deltaC: Fraction, deltaB: Fraction):

  result = []
  deltaA = deltaB*deltaC / (deltaB - deltaC)

  for i in range(0, 6):
      result.append(C[i+int(i*deltaB/deltaA)])
  return result, deltaA

def main():
    hash_result, delta_hash = hash(B, deltaB, A, deltaA)
    print("Hash(A,B):", hash_result[0:10], " deltaHash:", delta_hash)
    div_result, delta_div = dehashodd(hash_result, delta_hash, deltaB)
    print("Div(Hash):", div_result[0:10], " deltaDiv:", delta_div)

if __name__ == '__main__':
    main()
wynik - odd
$ python dehash_odd.py
Hash(A,B): [1, 'a', 2, 'b', 3, 'c', 4, 'd', 5, 'e']  deltaHash: 1/4
Div(Hash): [1, 2, 3, 4, 5, 6]  deltaDiv: 1/2
Tak zbudowany kod najpierw łączy dwa strumienie a następnie wyciąga dane źródłowe.
Operacja sumy
Sumowanie łączy dwa strumienie danych napływające z różną czestotliwością.
Kod źródłowy
# operacja sumowania dwóch list z określonymi krokami (delta).
from fractions import Fraction
from math import floor, ceil

A = range(1, 24)
deltaA = Fraction(1, 2)
B = list(map(chr, range(ord('a'), ord('z')+1)))
deltaB = Fraction(1)

def sum(A: list, deltaA: Fraction, B: list, deltaB: Fraction):
  result = []
  deltaC = min(deltaA, deltaB)
  for i in range(0, 20):
      if deltaC == deltaA:
          result.append(str(A[i])+B[int(i*deltaA/deltaB)]),
      else:
          result.append(str(A[int(i*deltaB/deltaA)])+B[i]),
  return result, deltaC

def main():
    print("A:", A[0:10], " deltaA:", deltaA)
    print("B:", B[0:10], " deltaB:", deltaB)
    sum_result, delta_sum = sum(A, deltaA, B, deltaB)
    print("Sum:", sum_result[0:10], " deltaSum:", delta_sum)

if __name__ == '__main__':
    main()
wynik
$  python sum.py
A: range(1, 11)  deltaA: 1/2
B: ['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h', 'i', 'j']  deltaB: 1
Sum: ['1a', '2a', '3b', '4b', '5c', '6c', '7d', '8d', '9e', '10e']  deltaSum: 1/2
Operacja różnicy
Komplementarną operacją dla sumy jest operacja różnicy.
Kod źródłowy
# Operacja różnicy (diff) dwóch list z określonymi krokami (delta).
from fractions import Fraction
from math import floor, ceil

A = range(1, 24)
deltaA = Fraction(1, 2)
B = list(map(chr, range(ord('a'), ord('z')+1)))
deltaB = Fraction(1)

def sum(A: list, deltaA: Fraction, B: list, deltaB: Fraction):
  result = []
  deltaC = min(deltaA, deltaB)
  for i in range(0, 20):
      if deltaC == deltaA:
          result.append(str(A[i])+B[int(i*deltaA/deltaB)]),
      else:
          result.append(str(A[int(i*deltaB/deltaA)])+B[i]),
  return result, deltaC

def diff(C: list, deltaA: Fraction, deltaB: Fraction):
  result = []
  for i in range(0, 10):
      if deltaA > deltaB:
          result.append(C[int(ceil(i*deltaA/deltaB))])
      else:
          result.append(C[i])
  return result, deltaA

def main():
    sum_result, delta_sum = sum(A, deltaA, B, deltaB)
    diff_result, delta_diff = diff(sum_result, deltaA, deltaB)
    slow_result, delta_slow = diff(sum_result, deltaB, deltaA)
    print("Sum:", sum_result[0:10], " deltaSum:", delta_sum)
    print("Diff(Sum):", diff_result[0:10], " deltaDiff:", delta_diff)
    print("Diff(Sum, slower):", slow_result[0:10], " deltaDiff:", delta_slow)

if __name__ == '__main__':
    main()
wynik
$ python diff.py
Sum: ['1a', '2a', '3b', '4b', '5c', '6c', '7d', '8d', '9e', '10e']  deltaSum: 1/2
Diff(Sum): ['1a', '2a', '3b', '4b', '5c', '6c', '7d', '8d', '9e', '10e']  deltaDiff: 1/2
Diff(Sum, slower): ['1a', '3b', '5c', '7d', '9e', '11f', '13g', '15h', '17i', '19j']  deltaDiff: 1
Funkcja diff przyjmuje interwał docelowy jako deltaA, a deltaB jest interwałem drugiej składowej złączenia. Interwał wejścia C wynosi min(deltaA, deltaB). Wynik musi zwracać interwał docelowy, także gdy jest on większy od wejściowego: drugi przykład wybiera co drugi rekord i ma interwał 1, a nie 1/2. Różnica wybiera całe rekordy złączenia; nie usuwa z nich pól drugiej składowej.
Kody źródłowe
Historyczne skrypty modelu znajdują się w repozytorium projektu w katalogu /examples/python-model/. Poprawioną funkcję różnicy i jej konwencję interwałów przedstawiają listingi powyżej.
Implementacja w języku javascript możliwa do przetestowania bezpośrednio na stonie:
https://retractordb.com/assets/interlace.html
https://retractordb.com/assets/sum.html
Reprezentacja graficzna
Na Rys. 2 przedstawiono schematycznie zależności pomiędzy opracowanymi operatorami algebry serii czasowych. Na rysunku połączyłem zależności opracowanych operatorów, ich symboliczne oznaczenia stosowane w języku zapytań oraz kierunki przetwarzania danych.
Przedstawiony rysunek stanowi też graficzne podsumowanie treści zaprezentowanych w tym rozdziale. Przedstawiony graficzny sposób reprezentacji mam nadzieję ułatwi przyswojenie zasad panujących pomiędzy wprowadzonymi operatorami. Dla czytelności pominięte zostały operatory agregacji i serializacji oraz przesunięcia czasowego. Należy mieć świadomość że do pełnego obrazu brakuje ich na tym schemacie.
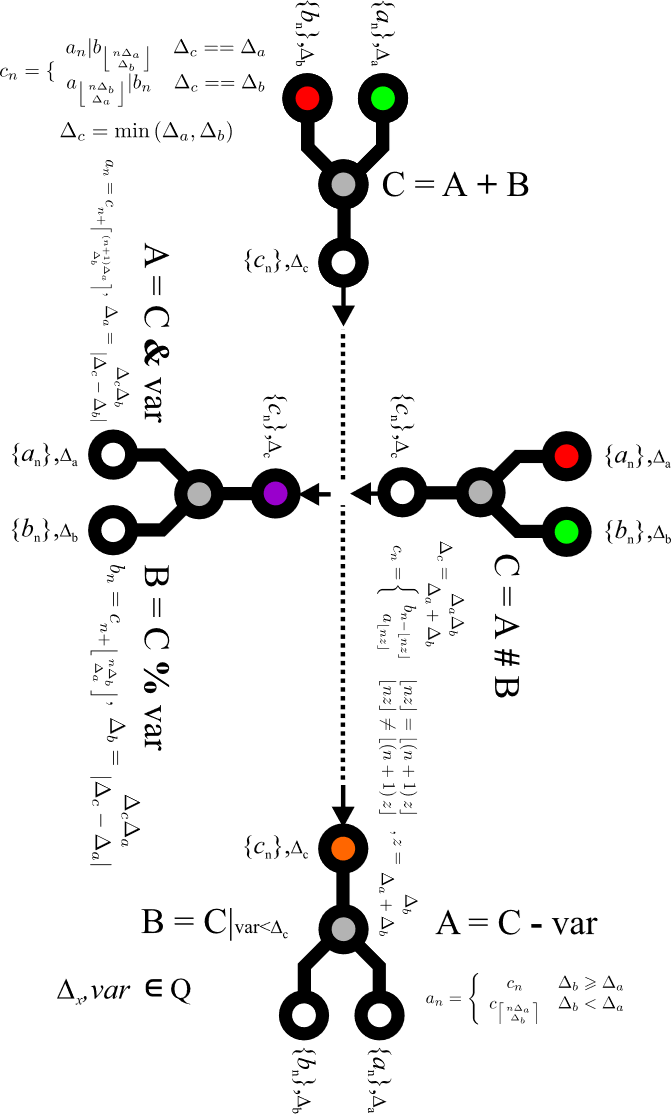
Rys. 2. Zależności pomiędzy operatorami algebry
Podsumowanie
Równania te z początku modelowałem w postaci programów w języku Python. Przedstawioną formalną formę przyjęły na sam koniec procesu poszukiwań. Dowodząc numerycznie poprawności opracowanych równań konstruowałem sekwencje operacji na strumieniach. Jeśli jakieś elementy gubiły się w trakcie realizacji przedstawionych operacji – oznaczało to że popełniłem błąd. Okazuje się np. ze istotne jest w implementacji aby nie opuszczać nawet na chwilę dziedziny liczb wymiernych. Błąd można popełnić przypadkiem, niejawnie rzutując wynik na liczbę zmiennoprzecinkową. Materializację wyniku w formie zmiennoprzecinkowej należy w obliczeniach odłożyć do momentu jawnego przeniesienia wyniku operacją podłogi lub sufitu. Jeśli program w Pytonie złożymy w sekwencję operacji na nieskończonych strumieniach i żadne dane w wyniku tej operacji nie znikną – mamy obiekt do dalszych badań i analizy formalnej, gotowy do formalnego dowodu matematycznego poprawności. Formalny dowód (formalizm matematyczny) znajdziemy w pracy pt. Deterministyczna metoda przetwarzania ciagow danych [3].
Dział matematyki który zawiera prace badawcze związane z tymi równaniami nosi nazwę systemów pokrywających [4] w obszarze teorii liczb.
ℹ️ Info
Przedstawienie podstaw matematycznych systemu jest konieczne w celu zrozumienia dalszych technicznych aspektów rozwiązania. Przedstawione metody wybiegają poza standardowy materiał prezentowany obecnie na studiach z zakresu nauk technicznych. Wynika to z faktu, że podstawy matematyczne wydobyłem z obszaru dotychczas niemającego zastosowań w znanej mi technice. Są to metody umożliwiające zbudowanie nowego sposobu przetwarzania danych. Na tym polega jeden z aspektów różniących RetractorDB od reszty podobnych rozwiązań.
Konstrukcja języka zapytań
Komunikacja pomiędzy opracowanym systemem a użytkownikiem odbywa się za pomocą opracowanego, deklaratywnego języka zapytań. Konstrukcja języka oparta jest na przedstawionej w poprzednim rozdziale algebrze. Podobnie jak w przypadku systemów relacyjnych, gdzie algebra relacji tworzy podstawę dla języka SQL – w moim przypadku opracowana algebra tworzy podstawę dla języka zapytań RQL.
RQL to skrót od RetractorDB Query Language. Jego składnia jest bardzo podobna do składni języka SQL. Należy mieć jednak na uwadze, że właściwym określeniem w tym przypadku jest ang. False Friend. Czyli wygląda to jak SQL, ale nie ma z nim zbyt wiele wspólnego.
Poprawne zdania w języku RQL na chwilę obecną zaczynają się od kilku słów kluczowych. Najbardziej rozpoznawalne to polecenie zaczynające się od słowa kluczowego SELECT za którym występuje lista atrybutów w postaci wyrażeń algebraicznych. Algebry opartej na liczbach rzeczywistych.
Polecenia zapisuje się w pliku tekstowym. Jego rozszerzenie to zwyczajowo .rql ale dowolne inne też zostanie przyjęte i przetworzone. Plik tekstowy języka RQL zawiera ciąg poleceń zaczynających się od zdefiniowanych słów kluczowych. Polecenie LET nadaje nazwy stałym liczbowym. VAR i DO SET wprowadzają zmienne planu zmieniane przez reguły; obie deklaracje używają odwołań ?NAZWA.
Znak # rozpoczyna komentarz tylko wtedy, gdy jest pierwszym niebiałym znakiem wiersza. Cały taki wiersz, także wcięty, jest pomijany przed parsowaniem. W wyrażeniu FROM znak # zawsze oznacza przeplot, niezależnie od spacji. Komentarz na końcu wiersza rozpoczyna się od //; dostępne są również komentarze blokowe /* ... */.
Język zapytań został zaimplementowany przy pomocy generatora parserów Antlr4 [5]. Gramatyka języka RQL została zapisana, zdefiniowana i po każdej modyfikacji jest kompilowana do języka w którym stworzono system RetractorDB. Każde zdanie pliku zbioru zapytań nie będące komentarzem jest kompilowane, przetwarzane i modyfikuje wewnętrzny stan systemu. Zdanie może zajmować wiele wierszy - kontynuację wiersza sygnalizuje znak \ na jego końcu.
Polecenie DECLARE
Polecenie DECLARE służy do zadeklarowania źródła danych.
Jego składnia opisana jest następująco:
DECLARE pole typ[N] [, pole typ[N]]
STREAM nazwa, szybkość
BINFILE | TEXTFILE | DEVICE źródło
[TIMEOUT czas]
[DISPOSABLE]
[ONESHOT]
[HOLD]
Rys. 3. Diagram składni polecenia DECLARE
Diagram składni (railroad) przedstawiony na Rys. 3 został wygenerowany na podstawie reguły declare_statement z gramatyki ANTLR4 systemu (RQL.g4). Diagram czyta się, podążając liniami od lewej do prawej: zaokrąglone zielone pola to słowa kluczowe i symbole wpisywane dosłownie, prostokąty to wartości podawane przez użytkownika. Pętla powracająca przez przecinek oznacza, że deklaracji pól może być wiele; rozgałęzienie przy szybkości pokazuje, że można ją zapisać ułamkiem (licznik/mianownik) lub pojedynczą liczbą; rozgałęzienie przed źródłem to wybór rodzaju źródła (BINFILE, TEXTFILE, DEVICE albo przestarzałe FILE); tor omijający TIMEOUT oznacza, że termin odczytu jest opcjonalny, a jego wartość - jak szybkość - zapisuje się ułamkiem albo liczbą; tory omijające DISPOSABLE, ONESHOT i HOLD oznaczają, że każda z tych dyrektyw jest opcjonalna.
Rodzaje źródeł
Format danych wynika ze słowa kluczowego, nigdy z nazwy ani rozszerzenia ścieżki:
| Słowo | Co czyta | Rodzaj pliku pod ścieżką | Po końcu danych |
|---|---|---|---|
BINFILE | surowe rekordy binarne o rozmiarze wynikającym z pól | wyłącznie plik zwykły | powrót na początek (pętla), z ONESHOT koniec źródła |
TEXTFILE | tekst: wartości rozdzielone białymi znakami, token NULL oznacza brak wartości | wyłącznie plik zwykły | jak BINFILE |
DEVICE | surowe rekordy binarne ze źródła żywego; nie interpretuje tekstu ani tokenu NULL, bajt zero jest zerem | urządzenie znakowe albo FIFO | brak pisarza: rekordy NULL do powrotu danych; z ONESHOT koniec źródła |
DECLARE MLII INTEGER, V1 INTEGER STREAM ecg, 1/360 BINFILE 'rec205'
DECLARE bp_coef INTEGER[25] STREAM bpf, 1 TEXTFILE 'bp_coef.txt'
DECLARE sample BYTE STREAM sensor, 0.02 DEVICE '/dev/urandom'
Rozszerzenie niczego nie wybiera: BINFILE 'bajty.txt' czyta surowe bajty, a TEXTFILE 'wartosci.dat' parsuje tekst.
DEVICE jest źródłem żywym, dlatego nie przyjmuje DISPOSABLE ani HOLD - te dyrektywy dotyczą plików odtwarzanych (BINFILE, TEXTFILE), patrz Opcje odczytu. Przyjmuje natomiast ONESHOT oraz własną klauzulę TIMEOUT, opisane w punkcie Odczyt źródła DEVICE i TIMEOUT. Otwarcie FIFO zadeklarowanego jako DEVICE nie czeka na pisarza - plan startuje, a pisarz może podłączyć się później.
Słowa BINFILE, TEXTFILE, DEVICE i TIMEOUT są zastrzeżone - żaden strumień ani pole nie może się tak nazywać (również pisane małymi literami).
Kontrola rodzaju pliku
Przed startem planu - także przy przeładowaniu planu (xqry --reset) i imporcie ad hoc (xqry -a) - system sprawdza rodzaj pliku i prawo odczytu pod ścieżką deklaracji, bez otwierania źródła. Import ad hoc sprawdza tylko nowo dodawane strumienie. Ścieżka niewłaściwego rodzaju (katalog, urządzenie blokowe, gniazdo, FIFO dla BINFILE/TEXTFILE, zwykły plik dla DEVICE) daje odmowę planu z nazwą strumienia i ścieżką, np.:
xretractor: stream 'src': BINFILE 'feed.fifo' is a FIFO, not a regular file
Brak źródła (ENOENT, a przy składniku ścieżki niebędącym katalogiem ENOTDIR) lub brak prawa odczytu (EACCES) zatrzymuje start błędem środowiska K4. Dotyczy to BINFILE, TEXTFILE i DEVICE, z opcją --until-eof (-u) i bez niej. Kod procesu to EIO (5 na Linuksie), a komunikat podaje strumień, ścieżkę i przyczynę systemową, także w kompilacji Release. Odmowa tej kontroli pozostawia dotychczasowe artefakty bez zmian. Szczegóły kodów i polityki pliku usługi opisuje xretractor.
Nieudane otwarcie źródła po pomyślnej kontroli również kończy wykonanie błędem K4, np. gdy plik zniknie przed budową modelu. Kompilacja w trybie -c nie sprawdza istnienia ani uprawnień źródeł - nie musi biec na maszynie z danymi. Regresja it_untileof_stop-missing-sources obejmuje odmowę przed startem i późne nieudane otwarcie dla wszystkich trzech rodzajów źródeł.
Odczyt źródła DEVICE i TIMEOUT
Odczyt źródła DEVICE nigdy nie czeka bez końca i nie wstrzymuje reszty systemu. Urządzenie albo FIFO jest otwierane i czytane bez blokowania, a jedyne czekanie odbywa się przed obliczeniem slotu, poza blokadami modelu danych. Klient xqry dostaje więc odpowiedź także wtedy, gdy silnik czeka na dane urządzenia, a czas czekania nie wchodzi do mierzonego czasu obliczeń slotu (E1).
Opcjonalna klauzula TIMEOUT podaje termin odczytu w sekundach. Wartość zapisuje się tak samo jak szybkość strumienia - ułamkiem, liczbą z kropką albo liczbą całkowitą:
DECLARE a BYTE STREAM s0, 1/50 DEVICE '/dev/sensor0'
DECLARE b BYTE STREAM s1, 1/50 DEVICE '/dev/sensor1' TIMEOUT 1/100
DECLARE c BYTE STREAM s2, 1/50 DEVICE '/dev/sensor2' TIMEOUT 0
| Wartość | Znaczenie |
|---|---|
TIMEOUT 0 | próba natychmiastowa: brak pełnego rekordu w należnym takcie daje rekord NULL bez czekania |
TIMEOUT t, t > 0 | jeden termin na cały rekord, liczony od początku należnego slotu; po nim rekord NULL |
| brak klauzuli | termin z klucza timeout_s w sekcji [sources] pliku retractor.toml, a bez tego klucza 0 |
Jawna klauzula wygrywa z konfiguracją - także jawne TIMEOUT 0, które wyłącza dodatnią wartość z retractor.toml dla jednego źródła. Wartość ujemna jest błędem: nie istnieje termin „czekaj bez końca“. Błędem planu jest też termin dłuższy od doby oraz TIMEOUT przy BINFILE, TEXTFILE i przestarzałym FILE (przy FILE z podpowiedzią, żeby zadeklarować źródło jawnym DEVICE). Klucz konfiguracji opisuje rozdział Opcje wywołania - xretractor.
Właściwości odczytu:
- Termin się nie odnawia. Przerwanie wywołania systemowego sygnałem ani fałszywe przebudzenie nie przedłużają czekania - termin jest stały od początku slotu.
- Wiele źródeł czeka równolegle. Wszystkie należne w danym slocie źródła
DEVICEczekają razem, więc slot wydłuża się najwyżej o największy termin, a nie o ich sumę. - Niepełny rekord przeżywa termin. Bajty, które przyszły przed terminem, czekają w buforze źródła; rekord dokończony później trafia do pierwszego kolejnego należnego taktu. Tylko rekord niepełny w chwili, gdy pisarz się odłącza, jest odrzucany - granica rekordu zginęła razem z pisarzem, więc następny pisarz zaczyna od nowego rekordu.
- Chwila odczytu. Rekord
DEVICEkonsumowany w slocie k jest czytany na początku slotu k, a nie na końcu slotu poprzedniego, jak w przypadkuBINFILEiTEXTFILE. Indeksy logiczne rekordów są te same: te same bajty podane jakoBINFILEi przez FIFO jakoDEVICEdają te same wyniki, także za operatorami łączącymi strumienie o różnych szybkościach. - Koniec danych. O końcu danych decyduje wyłącznie odczyt zwracający zero bajtów (FIFO bez pisarza, zawieszony terminal). Bez
ONESHOToznacza to „w tej chwili nie ma pisarza“: takt dostaje rekordNULL, źródło zostaje otwarte, a ponowne podłączenie pisarza wznawia dane. ZONESHOT(także w trybie--until-eof) wyczerpaniem jest pierwszy koniec danych po otrzymaniu co najmniej jednego bajtu - koniec przed pierwszymi danymi to pisarz, który jeszcze się nie podłączył. Pisarz, który podłączy się i odłączy bez zapisu, nie kończy więc przebiegu. - Błąd odczytu inny niż chwilowy brak danych (np. odłączone urządzenie USB) daje rekordy
NULL, bez wyczerpania źródła. Ponowne otwarcie odłączonego urządzenia nie jest obsługiwane. - Tryb bez zegara. W trybie
--no-clock(-f) termin każdego źródłaDEVICEwynosi 0: sekundy rzeczywiste nie mają przelicznika na czas wirtualny. Jedna próba natychmiastowa w każdym należnym takcie zostaje, więc FIFO z danymi zapisanymi z góry daje przebieg powtarzalny.
Odrzucenie niepełnego rekordu oraz zmiany stanu połączenia DEVICE (brak pisarza, wznowienie danych, błąd odczytu) mają diagnostykę na poziomie WARN. W kompilacji Debug te ostrzeżenia są dostępne w dzienniku; w Release są wyłączone już podczas kompilacji przez SPDLOG_ACTIVE_LEVEL=SPDLOG_LEVEL_ERROR. Brak ostrzeżenia w Release nie potwierdza więc poprawnego odczytu ani kompletności rekordów. Komunikaty na poziomie ERROR pozostają dostępne.
Efektywny termin każdego źródła DEVICE i jego pochodzenie (RQL, config, default albo no-clock) trafia do dziennika silnika przy starcie planu i przy imporcie ad hoc, np. DEVICE stream 's1': effective TIMEOUT 0.01 s (RQL). Wydruk xretractor -c pokazuje jawną klauzulę w tej samej postaci co szybkość, np. timeout=1/100.
⚠️ Ostrzeżenie Granice czasu rzeczywistego:
- Odczyt bez blokowania nie chroni przed sterownikiem, który blokuje wewnątrz wywołania odczytu mimo trybu nieblokującego. Takie urządzenie wymaga izolacji w osobnym procesie lub wątku.
- Termin dłuższy od szybkości strumienia przekracza slot. Kompilacja wypisuje wtedy ostrzeżenie, np.
DECLARE s1: TIMEOUT 0.05 s (RQL) is longer than the interval 0.02 s; waiting overruns the slot, uwzględniając także wartość zretractor.toml.- Każdy tryb taktowany, z opcją
--realtimei bez niej, planuje sloty względem stałej kotwicy osi czasu. Czekanie na źródłoDEVICE, które razem z obliczeniami mieści się w slocie, nie przesuwa następnych slotów. Dłuższe czekanie opóźnia kolejne sloty, które potem są nadrabiane bez snu; jeżeli czekanie i obliczenia stale przekraczają okres, zaległość narasta - patrz Harmonogram slotów.- Harmonogram nie synchronizuje zegara urządzenia. Producent stale szybszy od planu nadal tworzy zaległość w buforze źródła. Stale wolniejszemu brakuje próbek: daje to rekordy
NULLw taktach, w których rekord nie zdążył nadejść, aTIMEOUTmoże najwyżej zamienić je na opóźnienie narastające razem z niedoborem.
NOTE: Odczyt źródła
DEVICE,TIMEOUTi koniec danych mają pokrycie w teściedevice_timeouti w teście jednostkowymut_faccbindev.
Typy pól
Każde pole ma nazwę i typ. Dostępne typy:
| Typ | Rozmiar | Opis |
|---|---|---|
BYTE | 1 B | liczba całkowita bez znaku 8-bit |
INTEGER | 4 B | liczba całkowita ze znakiem 32-bit |
UINT | 4 B | liczba całkowita bez znaku 32-bit |
FLOAT | 4 B | liczba zmiennoprzecinkowa 32-bit |
DOUBLE | 8 B | liczba zmiennoprzecinkowa 64-bit |
STRING | N B | ciąg bajtów o stałej długości N |
Tablice pól (typ[N])
Do każdego pola można dodać mnożnik tablicowy [N] - pole zajmuje N × rozmiar_typu bajtów i tworzy N kolejnych pozycji w schemacie rekordu:
DECLARE coef INTEGER[25] STREAM filter, 1 TEXTFILE 'coefficients.txt'
Pole coef INTEGER[25] tworzy rekord o rozmiarze 25 × 4 = 100 bajtów i daje dostęp do indeksów filter[0] … filter[24]. Jest to standardowy sposób przekazywania tablic współczynników (np. filtry FIR) do systemu.
Wiele pól różnych typów można łączyć w jednym rekordzie:
DECLARE id UINT, wartosc FLOAT, nazwa STRING[16] \
STREAM pomiar, 0.1 \
BINFILE 'czujnik.dat'
Rozmiar rekordu: 4 + 4 + 16 = 24 bajty.
System RetractorDB działając pod kontrolą systemu Linux pobiera i zapisuje dane do plików. W systemie Linux dostęp do większości zasobów jest realizowany za pomocą dostępu do różnego rodzaju plików. Takie rozwiązanie ujednolica sposób dostępu do danych.
Przykładem polecenia tworzącego w systemie RetractorDB obiekt zwracający wartości przypadkowe ze strumienia /dev/random 10 razy na sekundę o wartościach typu int wygląda następująco
DECLARE pole_przypadkowe INTEGER STREAM random_stream, 0.1 DEVICE '/dev/random'
Plik zadeklarowany jako TEXTFILE jest czytany jako ciąg tokenów rozdzielonych białymi znakami. Granice wierszy nie wyznaczają granic rekordów: liczbę wartości rekordu określa deklaracja pól i ich tablic. Domyślnie po końcu pliku odczyt wraca na początek; ONESHOT lub --until-eof wyłącza tę pętlę.
Niepoprawne wartości liczbowe w TEXTFILE
Token liczbowy musi zostać odczytany w całości i mieścić się w zakresie typu pola. abc, 12x i 99999999999 w polu INTEGER, -5 w UINT, 300 w BYTE oraz 1e999, inf i nan w DOUBLE dają NULL. Poprawne +7 i -5 w INTEGER zachowują swoje wartości. Niedomiar zmiennoprzecinkowy, np. 1e-999, nadal daje zero. Tokeny NULL, Null i null również oznaczają brak wartości.
Wadliwy token nie kończy procesu ani nie przesuwa odczytu sąsiednich pól i kolejnych rekordów. Niepoprawny element tablicy unieważnia całe pole tablicowe, ponieważ bit NULL jest wspólny dla jego elementów; pozostałe pola rekordu zachowują wartości. Pole STRING nie podlega walidacji liczbowej.
Pierwszy niepoprawny token danego źródła pozostawia jeden wpis WARN w dzienniku z nazwą pliku, numerem rekordu, polem i tokenem. Kolejne błędy, również po powrocie na początek pliku, nie powtarzają ostrzeżenia. W Release wpis jest wyłączony podczas kompilacji przez SPDLOG_ACTIVE_LEVEL=SPDLOG_LEVEL_ERROR, lecz zamiana na NULL nadal działa. Regułę sprawdzają ut_facctxtsrc i it_issue471_txt_bad_token-value.
DECLARE pole_1 INTEGER STREAM cykliczny_stream, 0.1 TEXTFILE 'plik.txt'
NOTE: Opisana funkcjonalność ma pokrycie w teście:
Pattern7opisanym w załączniku pt. Testy Integracyjne.
Plik zadeklarowany jako BINFILE jest czytany jako ciąg surowych rekordów, również w pętli: po przeczytaniu ostatniego rekordu pozycja odczytu wraca na początek pliku.
Trzy opcjonalne dyrektywy (ONESHOT, DISPOSABLE, HOLD) sterują cyklem życia źródeł plikowych - szczegółowy opis i tabela porównawcza znajdują się w rozdziale Opcje odczytu.
Forma przestarzała FILE
DECLARE ... FILE 'ścieżka' jest nadal przyjmowane dla wstecznej zgodności. Rodzaj źródła wybiera wtedy stała reguła ze ścieżki - ta sama, którą system stosował, zanim pojawiły się jawne słowa. Wiersze tabeli sprawdzane są po kolei:
Ścieżka w FILE | Rodzaj po tłumaczeniu |
|---|---|
zawiera .txt w dowolnym miejscu, bez względu na wielkość liter (dane.txt, X.TXT, /x.txt.d/rec) | TEXTFILE |
zaczyna się od /dev/ | DEVICE |
| każda inna | BINFILE |
Po tłumaczeniu obowiązują reguły wybranego rodzaju, łącznie z kontrolą rodzaju pliku. FILE wskazujący FIFO spoza /dev daje odmowę z podpowiedzią właściwego słowa:
xretractor: stream 'src': BINFILE 'feed.fifo' is a FIFO, not a regular file (deprecated FILE resolved this path as BINFILE; declare it with DEVICE)
Deklaracja FILE rozstrzygnięta jako DEVICE dostaje cały opisany wyżej odczyt źródła DEVICE i przyjmuje ONESHOT, ale nie DISPOSABLE, HOLD ani TIMEOUT - jej termin pochodzi wyłącznie z [sources] timeout_s albo wynosi 0. Nowe plany powinny używać jawnych słów - forma FILE zostanie w przyszłości usunięta z języka. FILE w poleceniu SELECT nadal tylko nazywa plik wyniku i nie jest formą przestarzałą.
Ostrzeżenie o formie przestarzałej jest domyślnie wyciszone, więc istniejące plany nie zmieniają wyjścia programu. Z opcją --verbose (-v) xretractor wypisuje na stderr jedno ostrzeżenie na deklarację - przy starcie i w trybie -c:
xretractor: warning: line 3: DECLARE core: FILE 'dane.txt' is deprecated, resolved as TEXTFILE
Przy imporcie ad hoc (xqry -a) i przeładowaniu planu (xqry --reset) decyduje --verbose serwera, a ostrzeżenie trafia na jego stderr.
Deskryptor źródła
System zapisuje deskryptor każdej deklaracji w katalogu magazynu jako <nazwa_strumienia>.desc: pola, ścieżkę (REF) i typ (TYPE BINFILE, TYPE TEXTSOURCE albo TYPE DEVICE). Deskryptor zostaje między uruchomieniami i przy następnym starcie musi pasować do planu także w typie i ścieżce. Zmiana rodzaju źródła albo ścieżki przy zachowanym deskryptorze jest odmową planu z nazwą strumienia:
xretractor: stream 'src': temp/src.desc was written for source 'v.txt' and the plan reads 'w.txt'; remove temp/src.desc to start the stream afresh
Wyjątkiem jest deskryptor zapisany przez wcześniejsze wersje systemu dla zwykłego pliku binarnego: miał on TYPE DEVICE. Jeśli poza typem zgadza się z planem, start zastępuje go deskryptorem z TYPE BINFILE.
NOTE: Rodzaje źródeł, kontrola rodzaju pliku, forma przestarzała i deskryptor mają pokrycie w teście
source_kinds.
ℹ️ Info
Obsługa wartości NULL (per-pole) jest zaimplementowana w systemie RetractorDB. Metadane null przechowywane są w pliku
.metaobok danych binarnych, zarządzanym przez klasęmetaData.
Opcje odczytu w DECLARE
Polecenie DECLARE przyjmuje trzy opcjonalne dyrektywy wpływające na sposób odczytu i cykl życia zadeklarowanego źródła plikowego:
DECLARE pole typ STREAM nazwa, szybkość BINFILE | TEXTFILE źródło
    [DISPOSABLE]
    [ONESHOT]
    [HOLD]
Dyrektywy są niezależne i można je łączyć w dowolny sposób. Dotyczą plików odtwarzanych (BINFILE, TEXTFILE). Źródło żywe DEVICE przyjmuje z nich tylko ONESHOT, w znaczeniu opisanym niżej - patrz macierz na końcu rozdziału. Termin odczytu DEVICE ustala osobna klauzula TIMEOUT, opisana w rozdziale Polecenie DECLARE.
ONESHOT
Bez ONESHOT plik czytany jest w nieskończonej pętli - po osiągnięciu końca pliku pozycja odczytu wraca na początek. ONESHOT wyłącza pętlę: plik czytany jest dokładnie raz, a po jego wyczerpaniu strumień zwraca rekordy ze wszystkimi polami NULL. Bajty takiego rekordu są wyzerowane, ale znaczniki null odróżniają brak danych od wartości zero. Wyczerpanie pliku nie kończy procesu ani nie usuwa pliku.
Pusty TEXTFILE w trybie zapętlonym nie dostarcza rekordu także po przewinięciu. Akcesor już przy pierwszym odczycie zwraca EIO z wyzerowanymi bajtami i wszystkimi polami NULL; nie oznacza źródła jako wyczerpanego. Serwis traktuje ten brak danych jako rekord NULL, a nie koniec pliku ONESHOT. Przy odczycie bez zapętlania brakujące tokeny ostatniego rekordu stają się NULL, a odczytane pola zachowują wartości. Te przypadki sprawdza ut_facctxtsrc.
Przy błędzie odczytu obsługiwanym rekordem NULL bufor SourceBuffer zapisuje ostrzeżenie Read failure from declared source tylko przy pierwszym takim błędzie danego źródła. Kolejne takty nie powtarzają wpisu. Ostrzeżenie ma poziom WARN, wyłączony podczas kompilacji Release; regułę sprawdza ut_sourceBuffer.
DECLARE pomiar INTEGER STREAM burst, 0.1 BINFILE 'dane.dat' ONESHOT
Zastosowanie: jednorazowe załadowanie danych historycznych do systemu.
Przy źródle DEVICE nie ma pliku do przewinięcia, więc ONESHOT zmienia wyłącznie znaczenie końca danych. Bez ONESHOT koniec danych oznacza brak pisarza: takt dostaje rekord NULL, a ponowne podłączenie pisarza wznawia dane. Z ONESHOT wyczerpaniem jest pierwszy koniec danych po otrzymaniu co najmniej jednego bajtu; później źródło zwraca już tylko rekordy NULL, także gdy podłączy się kolejny pisarz.
DECLARE probka INTEGER STREAM nagranie, 1/100 DEVICE '/tmp/nagranie.fifo' ONESHOT
Opcja --until-eof (-u) programu xretractor czyta wszystkie źródła tak, jakby każda deklaracja niosła ONESHOT, i zatrzymuje przetwarzanie po wyczerpaniu pierwszego z nich. Przy źródle DEVICE wyczerpanie jest sprawdzane przed slotem, który dostałby rekord NULL zza końca danych, więc taki rekord nie trafia do żadnego strumienia.
Źródło musi przejść kontrolę dostępności przed wykonaniem. Brak pliku lub nieudane otwarcie kończy przebieg błędem środowiska K4 i kodem EIO, także z --until-eof. Poprawnie otwarte FIFO bez pisarza podlega opisanej wyżej regule oczekiwania na pierwsze dane.
DISPOSABLE
Przy zamknięciu magazynu źródła - przy końcu pracy procesu albo przy wymianie planu - system usuwa sam plik wejściowy wskazany w deklaracji, deskryptor strumienia (.desc) oraz pliki metadanych (.meta, .meta.shadow), jeśli istnieją. Usunięcie nie zależy od końca danych ani od ONESHOT: również plik czytany w pętli zostanie usunięty przy zamknięciu, nawet jeśli nie został przeczytany do końca.
DECLARE temp INTEGER STREAM jednorazowy, 0.1 BINFILE 'temp.dat' DISPOSABLE ONESHOT
Połączenie DISPOSABLE ONESHOT jest przydatne dla tymczasowego wejścia jednorazowego, ale nie jest wymagane.
HOLD
Plik jest otwierany przy starcie planu, ale fizyczny odczyt danych jest wstrzymany do pierwszego zapytania o dane tego strumienia - pobrania danych przez zapytanie albo przygotowania rekordu dla klienta (np. zapytanie Ad Hoc). Samo wyświetlenie planu nie zwalnia wstrzymania. Dopóki strumień nie zostanie odpytany, w systemie widoczne są wartości zerowe; pierwszy rekord pliku zostaje przeczytany w kolejnym kroku po zwolnieniu. Wstrzymanie jest jednorazowe - nie wraca, gdy odbiorcy znikną.
DECLARE rzadkie INTEGER STREAM opcjonalny, 1.0 BINFILE 'rzadkie.dat' HOLD
Zastosowanie: zachowanie początku nagrania do chwili pierwszego zapotrzebowania, np. na żądanie użytkownika przez xqry. Połączenie ONESHOT HOLD odtwarza plik raz, od chwili pierwszego zapytania.
Tabela porównawcza
| Dyrektywa | Pętla odczytu | Usuwa pliki przy zamknięciu | Opóźniony start odczytu |
|---|---|---|---|
| (domyślnie) | tak | nie | nie |
ONESHOT | nie | nie | nie |
DISPOSABLE | tak | tak | nie |
HOLD | tak | nie | tak |
Macierz opcji i rodzajów źródeł
| Opcja | BINFILE | TEXTFILE | DEVICE |
|---|---|---|---|
ONESHOT | tak | tak | tak |
DISPOSABLE | tak | tak | nie |
HOLD | tak | tak | nie |
DEVICE z DISPOSABLE albo HOLD jest błędem kompilacji z nazwą strumienia i opcji, np. DECLARE s: DEVICE does not take HOLD. Powody: wstrzymanie odczytu nie zatrzymuje producenta, tylko gromadzi zaległość, a DISPOSABLE usuwałby ścieżkę urządzenia albo FIFO, której cykl życia nie należy do czytnika. ONESHOT przy DEVICE nie przewija pliku, tylko wyznacza koniec danych - patrz ONESHOT.
Przestarzała forma FILE rozstrzygnięta jako DEVICE (ścieżka /dev/...) zachowuje się tak samo: odrzuca DISPOSABLE i HOLD, a ONESHOT przyjmuje - patrz Forma przestarzała FILE.
Polecenie SELECT
Każde polecenie SELECT w systemie RetractorDB tworzy ciągłe zapytania. Zapytania te realizowane są od momentu pojawienia się w systemie aż do zakończenia pracy systemu.
Składnia polecenia SELECT przedstawia się następująco:
SELECT wyrażenie_algebraiczne [, wyrażenie_algebraiczne]
STREAM nazwa_budowanego_strumienia [liczba_instancji]
FROM strumieniowe_wyrażnie_algebraiczne
[FILE 'nazwa_pliku_artefaktu']
[RETENTION pojemność [segmenty]]
[VOLATILE | PERSISTENT]
[STORAGE profile]
Rys. 4. Diagram składni polecenia SELECT
Diagram składni (railroad) przedstawiony na Rys. 4 został wygenerowany na podstawie reguły select_statement z gramatyki ANTLR4 systemu (RQL.g4). Diagram czyta się, podążając liniami od lewej do prawej: zaokrąglone zielone pola to słowa kluczowe i symbole wpisywane dosłownie, prostokąty to wartości podawane przez użytkownika. Rozgałęzienie za słowem SELECT pokazuje, że lista pól to albo gwiazdka (pełny rekord), albo jedno lub więcej wyrażeń rozdzielonych przecinkami (pętla powracająca przez przecinek). Opcjonalny rozmiar w nawiasach kwadratowych po nazwie strumienia tworzy rodzinę strumieni. Tory omijające klauzule FILE, RETENTION (z opcjonalnym drugim parametrem - liczbą segmentów), VOLATILE/PERSISTENT i STORAGE oznaczają, że każda z nich jest opcjonalna.
Osoby posługujące się językiem SQL zauważą od razu że przedstawione powyżej polecenie odbiega znacząco od tego co znają z zakresu relacyjnych baz danych.
Pierwsza różnica poza składnią to fakt że polecenia te wprowadzone do systemu realizują się aż do zakończenia pracy systemu. Każde polecenie SELECT jest zapytaniem ciągłym. Klauzula STREAM wymaga nadania przez twórcę każdemu zapytaniu unikalnej nazwy. O ile wyrażenia algebraiczne na liście klauzuli SELECT nie odbiegają od formy znanej z systemów relacyjnych o tyle strumieniowe wyrażenie algebraiczne musi spełniać warunki przedstawione w poprzednim rozdziale dotyczącym wyrażeń algebraicznych. Opcjonalne klauzule FILE oraz RETENTION zapewniają procesy kierowania wyników i zarządzania formą ich retencji. Stare, podzielone pliki wynikowe mogą być usuwane na bieżąco zapewniając systemowi miejsce na nowe dane w ruchu ciągłym.
Przykładem zapytania tworzącego nowy strumień danych może być następujące polecenie w języku RQL.
SELECT str1[0]*10 + str1[1]*10, str1[2] STREAM str1 FROM A+B
Tak zbudowane zapytanie zakłada że ktoś zadeklarował strumienie A i B. Operację tą mógł wykonać za pomocą słowa kluczowego DECLARE lub innego polecenia SELECT. W oparciu tylko o wiersz zawierający zapytanie nie jesteśmy w stanie stwierdzić jak szybko dane strumienia str1 napływają. Ta informacja jest wyliczana na etapie kompilacji w oparciu o strumienie A i B i wyrażenie algebraiczne w klauzuli FROM.
Generatory strumieni
Opcjonalny rozmiar po nazwie w klauzuli STREAM rozwija jeden szablon na podaną liczbę zapytań. Symbol $ oznacza numer instancji liczony od zera:
DECLARE cell INTEGER[4] STREAM cells, 1/10 TEXTFILE 'cells.txt'

SELECT cells[$] STREAM cell[4] FROM cells
SELECT *        STREAM grouped FROM cell[0]#cell[1]#cell[2]#cell[3]
Pierwsze polecenie SELECT tworzy fizyczne strumienie cell$0, cell$1, cell$2 i cell$3. Odwołanie cell[2] w klauzuli FROM oznacza instancję cell$2; w wyrażeniu listy SELECT zapis cells[2] nadal oznacza pole o indeksie 2.
W szablonie $ może wystąpić:
- jako indeks pola, np.
cells[$]albocells[3-$]; - jako wartość wyrażenia, np.
cells[0]+$; - w odwołaniu do innej rodziny w klauzuli
FROM, np.cell[$]@(2,4).
Wyrażenie indeksu generatora jest całkowite i może zawierać literały, $, nawiasy oraz operatory *, + i -. Rozmiar rodziny musi być dodatni, a szablon musi rzeczywiście używać $. Generator nie może mieć klauzuli FILE, ponieważ jedna nazwa pliku nie może opisywać wielu strumieni. Kompilator odrzuca także indeksy poza zakresem rodziny, ujemne indeksy pól, indeksy pól poza zakresem slotów źródła oraz kolizje nazw wygenerowanych z istniejącymi strumieniami. Zakres indeksu pola sprawdza ta sama kontrola co dla zapisu ręcznego - patrz Indeks poza zakresem.
Ekspansja jest pierwszym przebiegiem kompilatora. Po niej plan jest taki sam jak plan z ręcznie rozpisanymi strumieniami cell$0…cell$3; runtime nie ma osobnego mechanizmu generatorów.
Generator może obejmować kolejne stopnie tego samego potoku. Pozwala to opisać obliczenie raz i zastosować je niezależnie do każdego kanału wejściowego:
DECLARE sample INTEGER[8] STREAM samples, 1/1000 TEXTFILE 'samples.txt'

SELECT sample[$]^2 STREAM square[8] FROM samples
SELECT *           STREAM energy[8] FROM SUMC(square[$]@(25,100))
Powstaje osiem par strumieni square$N i energy$N, po jednej na kanał. Symbol $ wybiera numer instancji rodziny podczas rozwijania szablonu. Nie należy mylić go z [_], które powiela wyrażenie pola wewnątrz jednego zapytania według płaskiego schematu wejścia.
NOTE: Składnię generatora, w tym użycie
[$], sprawdzają test integracyjnystream_generatororaz przypadkiut_compilerwtest/UnitTest/test_compiler.cpp. Agregaty okien rekordów sprawdza testwindow_aggregate. Testy integracyjne opisano w załączniku Testy integracyjne.
Klauzula VOLATILE - tworzy ulotną formę zapytania. Dane pozostają w buforze pamięciowym, którego pojemność kompilator dobiera do potrzeb planu; na dysku pojawia się tylko deskryptor opisujący strukturę danych.
Klauzula STORAGE umożliwia wybór sposobu tworzenia i zarządzania tworzonymi artefaktami. Pełna tabela typów z opisem każdego z nich znajduje się w rozdziale Typy STORAGE.
Operatory klauzuli FROM
Strumieniowe wyrażenie algebraiczne w klauzuli FROM może zawierać:
| Operator | Składnia | Opis |
|---|---|---|
| Suma | A + B | Konkatenacja schematów dwóch strumieni - patrz Sekwencjonowanie sumowania |
| Przeplot | A # B | Przeplot dwóch strumieni - patrz Sekwencjonowanie przeplotu |
| Przesunięcie | A > N | Przesuwa odczyt o N próbek |
| Zmiana interwału | A - r | Przetaktowuje strumień do interwału wymiernego r |
| Rozplot | A & r / A % r | Odzyskuje lewą albo prawą składową przeplotu dla stosunku r |
| Okno AGSE | A @ (k, w) | Buduje ruchome okno danych - patrz Ruchome okno danych AGSE |
| Redukcja | MIN(A) / MAX(A) / AVG(A) / SUMC(A) | Redukuje wielopolowy rekord do jednej wartości - patrz Operatory agregujące |
Agregaty MIN/MAX/AVG/SUMC(wyrażenie : W) występują w liście SELECT, a nie w wyrażeniu strumieniowym FROM. Redukują historię W rekordów i mogą być operandem większego wyrażenia pola, na przykład 2*MIN(a : 5)+1. Obie osie agregacji porównuje rozdział Operatory agregujące.
Priorytet i łączność
Od operatorów wiążących najmocniej do najsłabiej:
- wywołanie reduktora, nazwa strumienia albo wyrażenie w nawiasach;
- łańcuchowalne operatory przyrostkowe
@,&,%,>,-i wygaszana postać.agregator; - przeplot
#; - suma
+.
Operatory binarne # i + są lewostronnie łączne. Operatory przyrostkowe również składają się od lewej, np. A@(1,4)&2 oznacza (A@(1,4))&2.
⚠️ Ostrzeżenie
A#B>NoznaczaA#(B>N), ponieważ przesunięcie wiąże mocniej niż przeplot. Aby przesunąć wynik przeplotu, zapisz(A#B)>N. Ta sama reguła dotyczyA#B-r.
Spacje wokół # nie zmieniają znaczenia: A # B i A#B są tym samym przeplotem.
Wyrażenia pól
Lista SELECT oraz warunki RULE używają wyrażeń skalarnych z odwołaniami do pól, operatorami arytmetycznymi, wartościami NULL i funkcjami. Pełną składnię, priorytety, listę funkcji oraz reguły konwersji opisuje rozdział Wyrażenia pól i funkcje skalarne.
Potęgowanie
Operator ^ potęguje wartości liczbowe na liście SELECT i w warunkach RULE. Wiąże mocniej niż * i /, a te wiążą mocniej niż + i -. Potęgowanie jest prawostronnie łączne:
SELECT v*w^2, v^w^2 STREAM powers FROM source
Powyższy zapis oznacza v*(w^2) oraz v^(w^2). Zapis (v*w)^2 wymaga jawnych nawiasów.
Dla typów całkowitych i wymiernych nieujemna potęga całkowita ma dokładnie semantykę powtarzanego mnożenia, łącznie z promocją typu i przepełnieniem. Dla pozostałych przypadków używane jest obliczenie zmiennoprzecinkowe; wynik nieskończony albo NaN staje się NULL. Operandy tekstowe są niedozwolone.
ℹ️ Info Literał ujemny jest jednym atomem gramatyki:
-2^2oznacza(-2)^2. Dla pola-v^2oznacza-(v^2). W razie wątpliwości użyj nawiasów.
⚠️ Ostrzeżenie Po przeplocie
A#Bnie wolno odwoływać się do jego składowych przezA[0],A.pole,A[_]aniA.*. Przeplot ma jeden wspólny schemat; użyj nazwy strumienia wynikowego albo odzyskaj składową operatorem&/%. Szczegóły opisuje rozdział Aliasowanie.
NOTE: Operator przesunięcia
A > Nma pokrycie w teście:issue56_timeshiftopisanym w załączniku pt. Testy Integracyjne.
NOTE: Propagacja wartości null przez wyrażenia SELECT ma pokrycie w teście:
issue121_null_propagationopisanym w załączniku pt. Testy Integracyjne.
Domyślną ulotność całego planu ustawia DEFAULT VOLATILE. Klauzula PERSISTENT wyłącza ją dla konkretnego wyniku. Szczegóły: VOLATILE i PERSISTENT.
Wyrażenia pól i funkcje skalarne
Wyrażenie pola oblicza jedną wartość rekordu wynikowego. Występuje na liście SELECT, w warunku RULE oraz jako argument agregatu okna rekordowego. Nie należy go mylić z wyrażeniem strumieniowym klauzuli FROM, które buduje i taktuje cały strumień.
Budowanie wyrażenia
Operandami są literały liczbowe i tekstowe, symbol $ wewnątrz generatora, odwołania do pól oraz wyniki funkcji. Pole można wskazać nazwą, kwalifikowaną nazwą strumienia albo płaskim indeksem, na przykład temperature, src.temperature i src[0]. Dla liczbowej deklaracji a T[N] goła nazwa a oznacza cały wpis tablicowy i nie jest operandem skalarnym; należy podać a[0]…a[N-1]. STRING[N] jest jednym polem tekstowym.
Podstawowe operatory arytmetyczne to +, -, *, / i ^. Nawiasy zmieniają grupowanie. Operatory * i / wiążą mocniej niż + i -, a potęgowanie ^ wiąże najmocniej i jest prawostronnie łączne:
| Priorytet operatorów dwuargumentowych (od najwyższego) | Operatory | Łączność |
|---|---|---|
| 1 | ^ | Od prawej: a^b^c oznacza a^(b^c) |
| 2 | *, / | Wspólny priorytet, od lewej: a/b*c oznacza (a/b)*c |
| 3 | +, - | Wspólny priorytet, od lewej: a-b+c oznacza (a-b)+c |
DECLARE v INTEGER, w INTEGER STREAM source, 1 TEXTFILE 'source.txt'
SELECT v-w+1, v/w*2 STREAM precedence FROM source
Dla wiersza wejściowego 12 3 wynik to 10, 8. Równe priorytety w obu parach obowiązują od poprawki #554. Wcześniej + wiązał mocniej niż -, a * mocniej niż /: powyższe pola dawały 8, 2. Jeśli zamierzone jest dawne grupowanie, trzeba zapisać je jawnie: v-(w+1) i v/(w*2).
Przykłady potęgowania:
SELECT v*w^2, v^w^2, (v*w)^2 STREAM powers FROM source
Powyższe pola znaczą odpowiednio v*(w^2), v^(w^2) i (v*w)^2. Literał ujemny jest jednym atomem gramatyki: -2^2 oznacza (-2)^2, natomiast -v^2 oznacza -(v^2).
Dla typów całkowitych i wymiernych nieujemna potęga całkowita ma semantykę powtarzanego mnożenia, łącznie z promocją typu i przepełnieniem. Pozostałe przypadki korzystają z obliczenia zmiennoprzecinkowego; wynik nieskończony albo NaN staje się NULL. Operandy tekstowe są niedozwolone.
Iloczyn dwóch wartości BYTE ma typ INTEGER; ta sama promocja obowiązuje przy potęgowaniu, także dla wykładnika zero. Dla pól b i e typu BYTE oraz e = 0 wyrażenie b^e daje całkowite 1, również przy b = 0, a -(b^e) daje -1. Negacja obejmuje tu wynik typu INTEGER, więc jest arytmetyczna. Zachowanie sprawdzają przypadki exact_power_zero_exponent_is_one_of_the_product_type i negated_byte_power_with_zero_exponent_is_minus_one w ut_expeval.
Wartość NULL jest propagowana przez zwykłą arytmetykę. Dzielenie przez zero daje NULL dla każdego typu liczbowego i nie zatrzymuje dalszego przetwarzania strumienia. Reguły porównań i trójwartościowej logiki warunku RULE opisuje rozdział Warunek logiczny.
Dodawanie, odejmowanie i mnożenie pól UINT są sprawdzane: suma lub iloczyn poza zakresem 32-bitowej liczby bez znaku oraz ujemna różnica dają NULL zamiast zawiniętej wartości. Działanie na parze INTEGER i UINT jest liczone na wartościach dokładnych, a do UINT trafia dopiero wynik: NULL pojawia się tylko wtedy, gdy wynik się w nim nie mieści. Dla u = 10 i i = -2 wyrażenie u + i daje 8, a u * i daje NULL; porównanie takiej pary, np. i < u, też jest dokładne. Arytmetyka INTEGER i RATIONAL również zwraca NULL przy przepełnieniu.
⚠️ Ostrzeżenie Po przeplocie
A#Bnie wolno odwoływać się do jego składowych przezA[0],A.pole,A[_]aniA.*. Przeplot ma jeden wspólny schemat; należy użyć nazwy strumienia wynikowego albo odzyskać składową operatorem&lub%. Szczegóły opisuje rozdział Aliasowanie.
Operatory jednoargumentowe
Obsługa opisana w tej sekcji wymaga wersji silnika zawierającej poprawkę #328.
Operatory +, - i ~ można stosować do pola, wyniku funkcji albo wyrażenia w nawiasach. Każdy element listy SELECT nadal tworzy jedno pole wynikowe, a operand w warunku RULE pozostaje częścią tego warunku.
| Operator | Typ operandu | Wynik |
|---|---|---|
+a | Dowolny typ wartości, także STRING | Wartość i typ a bez zmiany |
-a | INTEGER, RATIONAL, FLOAT, DOUBLE | Negacja arytmetyczna, bez zmiany typu |
-a | BYTE, UINT | Negacja bitowa, bez zmiany typu; taki sam wynik jak ~a |
~a | BYTE, UINT | Odwrócenie wszystkich bitów w szerokości typu operandu |
Dla BYTE o wartości 0 zarówno -a, jak i ~a dają 255; dla wartości 1 dają 254, a dla 255 dają 0. Dla UINT odpowiednie wyniki dla 0 i 1 to 4294967295 i 4294967294. Nie jest to odejmowanie od zera ani negacja logiczna NOT. Jeśli potrzebna jest ujemna wartość arytmetyczna pola bez znaku, należy najpierw jawnie zmienić jego typ, na przykład -to_double(a).
Typ dotyczy obliczonego operandu, a nie samego pola źródłowego. Literał -1 jest ujemną liczbą typu INTEGER; nie korzysta z reguły negacji bitowej dla BYTE lub UINT. NULL przechodzi przez dozwolony operator bez zmiany. Negacja arytmetyczna z przepełnieniem INTEGER lub RATIONAL daje NULL; na przykład dla INTEGER o wartości -2147483648 wyrażenie -a daje NULL.
Operand operatora jednoargumentowego obejmuje potęgowanie, mnożenie i dzielenie, ale zatrzymuje się przed dwuargumentowym + lub -. Dlatego -a+1 oznacza (-a)+1, a -(a+1) neguje całą sumę. -a*b oznacza -(a*b); aby zanegować wyłącznie a, trzeba napisać (-a)*b. Ta różnica może zmienić typ operandu, wynik negacji bitowej lub miejsce przepełnienia. Tak samo ~a*b oznacza ~(a*b). Pozostaje różnica przy potęgowaniu: -2^2 daje 4, natomiast -a^2 oznacza -(a^2); kwadrat zanegowanego pola zapisuje się jako (-a)^2.
DECLARE b BYTE, u UINT, i INTEGER STREAM src, 1 TEXTFILE 'source.txt'
SELECT -src[0], ~src[0], -src[1], ~src[1], +src[2], -(src[2]+1), -src[2]+1 STREAM unary FROM src
RULE negative ON unary WHEN -unary[4] < 0 DO DUMP -1 TO 0
Dla wejścia 0 1 5 wynik ma siedem pól: 255, 255, 4294967294, 4294967294, 5, -6, -4. Reguła sprawdza negację piątego pola, czyli -5 < 0.
-a nad STRING oraz ~a nad INTEGER, RATIONAL, FLOAT, DOUBLE lub STRING są odrzucane podczas kompilacji, zarówno w SELECT, jak i w warunku RULE. Komunikaty podają przyczynę: unary '-' is not defined for STRING albo unary '~' is defined only for BYTE and UINT, not for .... Przy sprawdzaniu pliku przez xretractor -c powód pojawia się w Check result:. Odmowa takiego zapytania ad hoc (xqry -a) pozostawia działający plan i usługę aktywne.
Dostępne funkcje skalarne
Jedyną listą nazw i arności wspólną dla kompilatora i ewaluatora jest tabela rqlFunctions.hpp. Nazwy są dopasowywane bez względu na wielkość liter, a w planie zapisywana jest postać kanoniczna. Nieznana funkcja albo błędna arność zatrzymuje kompilację; błąd nie jest odkładany do wykonania.
| Grupa | Funkcje |
|---|---|
| Matematyczne | Sqrt, Ceil, Floor, Abs, round, trunc, sin, cos, exp, tan, log, log2 |
| Obsługa wartości | isnull, null2zero, IsZero, IsNonZero, Length |
| Konwersje | to_integer, to_float, to_double, to_string |
Wszystkie funkcje przyjmują jeden argument wyrażeniowy. Jedynym wyjątkiem jest opcjonalna szerokość pola wynikowego w to_string(wyrażenie : szerokość).
Predykaty i wartości brakujące
isnull(x)zwraca 1 dlaNULLi 0 dla wartości obecnej;null2zero(x)zamieniaNULLna całkowite zero, ale wartość obecną przepuszcza bez zmiany jej typu;IsZero(x)iIsNonZero(x)zwracają całkowite 1 albo 0 dla argumentu liczbowego.
null2zero jest konwersją stratną: po jej wykonaniu nie da się odróżnić pierwotnego braku od rzeczywistego zera. Nie zastępuje bitmapy NULL przechowywanej w pliku .meta.
Długość napisu
Length(x) działa wyłącznie na napisie. Liczy długość rzeczywistej wartości do pierwszego bajtu zerowego, a nie zadeklarowaną szerokość STRING[N]. Dla pola STRING[8] zawierającego alpha wynikiem jest 5. Argument liczbowy jest błędem wykonania.
Konwersje
to_integer, to_float i to_double konwertują wartość liczbową albo tekstową do wskazanego typu. NULL przechodzi bez zmiany. to_integer obcina część ułamkową w stronę zera, nie podłoguje: to_integer(-8/3) daje -2. Wartość zmiennoprzecinkowa, której INTEGER nie pomieści - także NaN i nieskończoność - daje NULL, tak samo jak przepełnienie arytmetyki. Ta sama reguła obejmuje funkcje matematyczne nad polem całkowitym, których wynik wraca do typu argumentu: Sqrt(-4) i log(0) nad polem INTEGER dają NULL. Zakres jest sprawdzany po obcięciu części ułamkowej: dla argumentu typu DOUBLE wartość 2147483647.5 daje 2147483647, natomiast 2147483648.0 daje NULL. Reguła nie kończy się na typach całkowitych: NaN i nieskończoność nie mają przybliżenia wymiernego, więc wartość zmiennoprzecinkowa zapisywana do pola RATIONAL daje NULL tak samo jak w INTEGER, a nie zero.
Konwersja wartości całkowitej lub wymiernej do węższego typu całkowitego także daje NULL, jeżeli wynik nie mieści się w typie docelowym: dotyczy to liczby ujemnej kierowanej do UINT, UINT większego od INT_MAX kierowanego do INTEGER lub RATIONAL oraz wartości poza zakresem 0..255 kierowanej do BYTE. Przy konwersji RATIONAL do typu całkowitego najpierw obcina się część ułamkową w stronę zera, a potem sprawdza zakres. Niepoprawny tekst liczbowy daje NULL. Przybliżanie skończonej liczby zmiennoprzecinkowej do RATIONAL zatrzymuje się na ostatnim ułamku, którego licznik i mianownik mieszczą się w int. Dla skończonego argumentu typu FLOAT lub DOUBLE najpierw sprawdzana jest część całkowita wartości bezwzględnej: 2147483647.5 i -2147483647.5 mogą być przybliżone, a 2147483648.0 i -2147483648.0 dają NULL.
Konwersja napisu do INTEGER, FLOAT albo DOUBLE musi zużyć cały tekst. to_integer('12') daje 12, ale to_integer('12tail') i to_double('1.5tail') dają NULL; poprawny początek liczbowy nie wystarcza. Te konwersje nie usuwają białych znaków otaczających napis, więc także końcowa spacja powoduje NULL.
Konwersje napisu do RATIONAL w bibliotece C++ akceptują pełne postacie 3/4 oraz 3 (czyli 3/1), także z białymi znakami wokół licznika, separatora i mianownika. Licznik i mianownik muszą mieścić się w int; mianownik nie może być zerem ani INT_MIN. Ujemny mianownik jest normalizowany: 3/-4 daje -3/4, chyba że licznik równy INT_MIN uniemożliwia zmianę znaku. To odrębna ścieżka od odczytu binarnego pola RATIONAL, który wymaga dodatniego mianownika. Niepełne 3/, końcówka 3/4tail, nieliczbowe bad i przepełnienie dają NULL. Reguła ta nie wprowadza funkcji RQL to_rational ani obsługi RATIONAL w źródle TEXTFILE. Wspólny kontrakt obu interfejsów konwersji C++ sprawdza ut_convertTypes, przypadek cast_contract.string_prefixes_and_pair_parsing_match_both_interfaces.
to_string tworzy pole tekstowe. Bez drugiego członu jego szerokość wynosi 32 bajty; postać to_string(x : N) deklaruje N bajtów. Separatorem jest dwukropek, ponieważ przecinek rozdziela pola listy SELECT:
N musi należeć do zakresu 1..65536. to_string(x : 0) jest błędem parsera (to_string width 0 must be greater than zero), a wynikowa konkatenacja napisów również musi zmieścić się w granicy pola. Zobacz Granice wymiarów planu.
SELECT to_string(value : 10), Length(label), null2zero(optional) \
STREAM converted FROM source
Szerokość wyniku tekstowego jest ustalana po rozwiązaniu referencji do pól, dlatego czyste przepisanie STRING[N] i konkatenacja tekstowa zachowują poprawny deskryptor. Typ całego wyrażenia, także liczbowego, wyznacza compiler::inferFieldShapes() po rozwiązaniu odwołań do pól; reguły opisuje rozdział Równanie typów w górę.
Zadeklarowana szerokość jest własnością pola, a nie skutkiem konkretnego przebiegu kompilacji. Obowiązuje także wtedy, gdy cały argument jest stały: to_string(42 : 16) daje STRING[16], a nie STRING[2]. Upraszczanie wyrażeń zwija argument pod wywołaniem, ale samego to_string nie usuwa - inaczej deklaracja znikałaby razem z programem przy ponownej kompilacji planu, czyli po zapytaniu ad hoc (xqry -a), które kompiluje żywy plan drugi raz.
sin, cos i exp
Wszystkie trzy funkcje przyjmują argument liczbowy i zwracają DOUBLE, niezależnie od typu argumentu. sin i cos interpretują kąt w radianach. Na przykład dla pola k typu INTEGER wyrażenia sin(k), cos(k) i exp(k) dają pola typu DOUBLE; wynik nie traci części ułamkowej. NULL na wejściu daje NULL, a wynik niefinitywny (np. exp(1000)) również daje NULL bez zatrzymania strumienia.
Wyjątkiem jest argument typu RATIONAL: kompilator go odrzuca i wymaga jawnego to_double - tak samo jak dla Sqrt, patrz rozdział niżej.
Zmiana typu sin i cos względem starszego silnika może zmienić deskryptor .desc i układ rekordu: INTEGER oraz FLOAT zajmują 4 bajty, a DOUBLE 8 bajtów. Istniejący artefakt o starym schemacie wymaga ponownego utworzenia albo osobnego strumienia wynikowego.
Funkcje niewymierne nad wartością RATIONAL
Sqrt, sin, cos, exp, tan, log i log2 nie przyjmują argumentu typu RATIONAL - kompilator odrzuca taki zapis kanałem Check result: i podaje obejście. Dotyczy to w praktyce reduktorów strumieniowych nad polami BYTE, INTEGER, UINT i RATIONAL, bo ich wynik ma typ RATIONAL. Reduktory nad FLOAT i DOUBLE zachowują typ wejścia:
SELECT * STREAM m FROM AVG(src)
SELECT Sqrt(m[0]) STREAM o FROM m              // odrzucone przy kompilacji
SELECT Sqrt(to_double(m[0])) STREAM o FROM m   // poprawnie
Obowiązuje jedna reguła: funkcja o niewymiernej przeciwdziedzinie nad wartością wymierną wymaga jawnego to_double. Ta sama reguła obejmuje warunek reguły (RULE ... WHEN), który kompilator sprawdza osobnym przebiegiem.
Dla Sqrt, tan, log i log2 powodem bramki jest powrót z obliczenia przez double do RATIONAL: wynik zostawał przybliżony ułamkiem o dużym mianowniku (dla argumentu wymiernego 2/1 pierwiastek dawał 19601/13860, a logarytm 2731/3940). W starszej wersji dwa kolejne mnożenia takiego przybliżenia mogły przepełnić 32-bitowy licznik lub mianownik bez sygnału; Sqrt(x)*Sqrt(x)*Sqrt(x) zwracało -4,247 zamiast +2,828. Obecnie arytmetyka wartości pól typu INTEGER i RATIONAL wykrywa przepełnienie i zapisuje NULL, ale nie znosi to wymogu jawnego to_double dla tych funkcji.
Dla sin, cos i exp powód jest inny: te trzy kończą na DOUBLE i nigdy nie wracają do RATIONAL, więc policzyłyby się poprawnie. Ich odrzucenie jest decyzją o kontrakcie języka, podjętą po to, żeby nie trzeba było pamiętać listy wyjątków - jedna reguła zamiast siedmiu osobnych zachowań. Ceną jest to_double w każdym zapytaniu liczącym np. RMS nad reduktorem.
Ograniczenie nie obejmuje pozostałych funkcji ani innych typów argumentu. Zaokrąglenia Floor, Ceil, round i trunc nad RATIONAL są bezpieczne, bo ich wynik jest całkowity, czyli ma mianownik 1, a Abs liczy się wprost na wartości i mianownika nie rusza w ogóle.
Bramka dotyczy wyłącznie pary z RATIONAL i nie zmienia typu wyniku żadnej funkcji. tan, log i log2 nad INTEGER nadal dają INTEGER, czyli obcinają część ułamkową - to strata jawna i zamierzona, nie przepełnienie. Ewentualne doprowadzenie ich do DOUBLE, tak jak sin, cos i exp, zmieniłoby typ pola w .desc, więc jest osobnym zadaniem.
NOTE: Funkcje i propagację typów sprawdzają testy integracyjne
fncall_runtime_case,string_field_passthrough,issue121_isnull,issue128_numeric_to_stringiissue128_string_to_numericoraz testy jednostkoweut_compiler,ut_expevaliut_facctxtsrc.
Sekwencjonowanie operacji sumowania
Do systemu napływają i są przetwarzane w nim dane. Określenie kolejności ich napływu i przetwarzania możemy opisać terminem - sekwencjonowanie. Sposób w jakim zostaną dane połączone opisywany jest przez wyrażenie algebraiczne umieszczone w klauzuli FROM. Wyrażenia te zapisane są w formie szeregu operacji algebraicznych, podlegającym ścisłym regułom. Podobne reguły poznaliśmy w trakcie nauki w szkole podstawowej – były to reguły dotyczące operacji arytmetycznych w zbiorze liczb takich jak dodawanie, mnożenie dzielenie i odejmowanie.
Na początku przeanalizujmy następujące zapytanie:
DECLARE a BYTE STREAM A, 1 TEXTFILE 'data1.txt'
DECLARE a BYTE STREAM B, 2 TEXTFILE 'data2.txt'
SELECT * STREAM str1 FROM A+B
Zapytanie zapiszę w pliku qplan1.rql. Następnie wykonam następujące polecenia:
$ xretractor -c qplan1.rql -w 1:3 > out.txt
$ swirly out.txt -o out.svg
Program swirly zainstalowany został z repozytorium GitHub [6]. Program ten służy do generacji diagramów kulkowych stosowanych w wyjaśnianiu zachowania operacji asynchronicznych RxJs [7].
Modyfikację jaką zastosowałem w moim przypadku użycia to alternatywne znaczenie pionowych linii. W moim przypadku pionowe linia oddzielają jednolite interwały czasowe – prezentujące ilość cykli o które poprosiliśmy przy wywołaniu (w tym przypadku to 3 cykle). Wygenerowany obraz przedstawia Rys. 5:
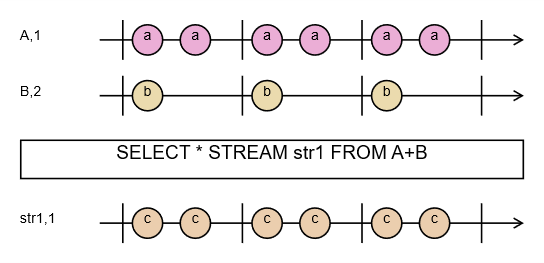
Rys. 5 Schemat Kulkowy - Operacja sumy
W tym miejscu konieczne jest kilka słów wyjaśnienia dotyczące tego generatora oraz sposobu generacji wytycznych dla tego generatora. Wbudowałem w kompilator opcję wizualizacji realizacji sekwencji operacji. Diagramy tworzone przez program Swirly są jednym z wygodnych sposobów prezentacji zależności czasowych. Na wejściu program Swirly oczekuje pliku tekstowego z opisem diagramu. Generator symulujący wskazaną ilość cykli w argumencie i budujący plik dla Swirly został wbudowany w kompilator.
Program xretractor po podaniu jako pierwszy parametr nazwy pliku z planem realizacji zapytania wymaga drugiego parametru ( -w [–diagram] ) – co jest wskazaniem że oczekujemy na wyjściu opisu diagramu kulkowego. Wymaganym argumentem parametru -w są dwie liczby oddzielone dwukropkiem. Pierwsza informuje czy program ma wstawić separatory czasowe na diagramie (to te pionowe linie oddzielające cykle), drugim parametrem jest ile cykli ma zostać zaprezentowane na diagramie.
Jeśli zajrzysz do wygenerowanego pliku out.txt zobaczysz następującą zawartość:
% Creating diagram output grid is on, cycle count:3
% Minimum interval is 1000ms
% Maximum interval is 2000ms
% Grid time is 500ms, divider:2
% Full cycle step count in grid is 4
-|a-a-|a-a-|a-a-|-
title = A,1

-|b---|b---|b---|-
title = B,2

> SELECT * STREAM str1 FROM A+B

-|c-c-|c-c-|c-c-|-
title = str1,1
W tym pliku proszę zwrócić uwagę na dane przedstawione w komentarzach. Są to czasy wyznaczone w trakcie generowania schematu a odnoszące się do skali prezentowanej na schemacie kulkowym. Jak widać, dla naszego zapytania minimalny interwał okna to 1 sekunda, maksymalny to 2 sekundy. Siatka jaka została zidentyfikowana i wyznaczona na pół sekundy. Na schemacie każda litera lub myślnik to właśnie półsekundowy czasokres pomiędzy kolejnymi operacjami.
Wygenerowaną zawartość możemy zawartość zmienić ręcznie. Jeśli zamienimy tą zawartość w następujący sposób:
-|a-b-|c-d-|e-f-|-
title = A,1

-|g---|h---|i---|-
title = B,2

> SELECT * STREAM str1 FROM A+B

-|j-k-|l-m-|n-o-|-
title = str1,1
j:=ag
k:=bg
l:=ch
m:=dh
n:=ei
o:=fi
Wywołamy następnie ponownie program swirly zobaczymy bardziej dokładny rysunek przedstawiający sekwencję zdarzeń występujących w systemie.
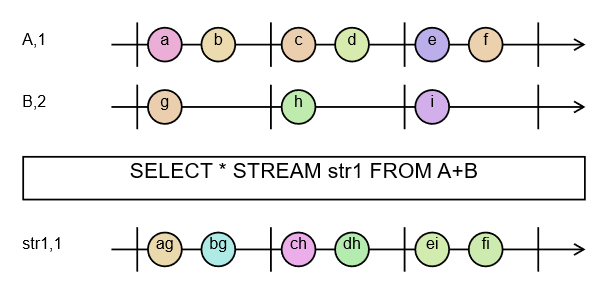
Rys. 6 Schemat kulkowy - Suma, diagram zmodyfikowany
Na diagramie przedstawionym na rysunku Rys. 6 widać, które kulki zostały połączone i z których kulek powstały. Przypominam jednak że to obraz poprawiony ręcznie, dla celów tego opracowania – generator wbudowany w kompilator nie realizuje tej funkcjonalności.
NOTE: Opisana funkcjonalność ma pokrycie w testach:
Pattern1,issue167_triargopisanych w załączniku pt. Testy Integracyjne.
Ta sama nazwa w FROM więcej niż raz
Strumień może wystąpić w wyrażeniu FROM więcej niż raz - wprost i pod innym operatorem, np. bar + MAX(bar) albo src + src>1, lub dwukrotnie pod różnymi operatorami, np. src@(1,5) + src@(2,3). Rekord wejściowy zawiera wtedy osobny blok pól dla każdego wystąpienia, a odwołanie po nazwie (bar[0], src[4]) oraz rozwinięcie SELECT * muszą wskazać jeden z nich. Kompilator wybiera pierwsze wystąpienie w stałej kolejności: najpierw bezpośrednie operandy wyrażenia w kolejności zapisu, dopiero potem strumienie ukryte pod operatorami (reduktorem, przesunięciem, oknem), również w kolejności zapisu. Tę samą kolejność stosuje kontrola zakresu indeksu, więc granica src[k] jest mierzona na tym wystąpieniu, które odwołanie przeczyta.
DECLARE v INTEGER[3] STREAM bar, 1/50 TEXTFILE 'a.txt'
SELECT * STREAM chk FROM bar + MAX(bar)
Strumień chk ma cztery pola: trzy pola bar stojącego wprost w FROM i maksimum rekordu. Operand stojący wprost zawsze wskazuje własne pola, także wtedy, gdy zapisano go jako drugi: w src>1 + src odwołanie src[0] czyta próbkę bieżącą, a nie przesuniętą. W src@(1,5) + src@(2,3) nazwa src jest osiągalna tylko przez okna, więc wskazuje pierwsze z nich: src[4] jest poprawne, a src[5] jest błędem kompilacji. Aby odwołać się do pól drugiego wystąpienia, należy nadać mu własną nazwę osobnym zapytaniem, np. SELECT * STREAM w2 FROM src@(2,3), i użyć w2 w wyrażeniu FROM.
NOTE: Regułę pierwszego wystąpienia sprawdzają testy jednostkowe
ut_compiler:direct_operand_keeps_its_own_slots_beside_a_nested_occurrenceorazrange_check_and_offset_agree_on_a_name_reached_twice.
Sekwencjonowanie operacji przeplotu
Przeanalizujmy teraz operację przeplotu. Stwórzmy plik qplan2.rql o następującej treści:
DECLARE a BYTE STREAM A, 1 TEXTFILE 'data1.txt'
DECLARE a BYTE STREAM B, 2 TEXTFILE 'data2.txt'
SELECT * STREAM str1 FROM A#B
Oprócz znaku # zamiast znaku + w klauzuli from oba pliki się niczym nie różnią. Wywołajmy kompilację oraz program swirly. Plik graficzny prezentować się będzie następująco:
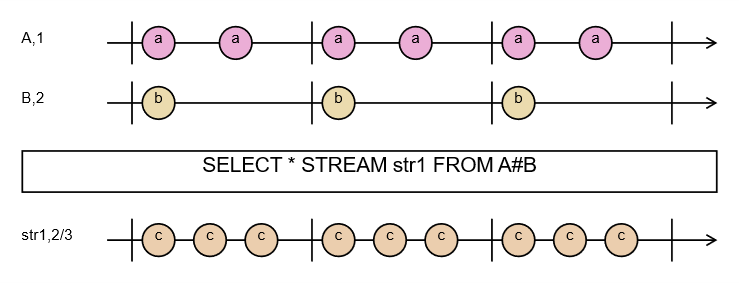
Rys. 7 Schemat kulkowy - operacja przeplotu
Na Rys. 7 widać zmianę. Kulki strumienia str1 zostały równomiernie uporządkowane w czasie. Zdarzenia występujące w zadeklarowanych strumieniach danych wejściowych nie uległy zmianie. Uległa natomiast zmianie zasada budowy strumienia wynikowego str1.
Jeśli zajrzymy do wygenerowanego schematu tekstowego – zobaczymy że wartości czasowe również uległy zmianie:
% Minimum interval is 666ms
% Maximum interval is 2000ms
% Grid time is 333ms, divider:2
% Full cycle step count in grid is 6
Zachęcam do dalszego eksperymentowania z tym sposobem prezentacji zdefiniowanych operacji na seriach czasowych.
NOTE: Opisana funkcjonalność ma pokrycie w testach:
operations,Pattern1opisanych w załączniku pt. Testy Integracyjne.
Klauzula VOLATILE
Klauzula VOLATILE w poleceniu SELECT tworzy strumień przechowywany w pamięci. Na dysku pojawia się jedynie plik deskryptora .desc opisujący schemat danych - same dane nigdy nie są zapisywane.
Domyślna ulotność i wyjątek PERSISTENT
Dyrektywa DEFAULT VOLATILE ustawia przechowywanie w pamięci dla wyników SELECT bez jawnej polityki oraz dla substratów kompilatora. Zastępuje więc powtarzane VOLATILE i dyrektywę SUBSTRAT 'memory':
DEFAULT VOLATILE
DECLARE a INTEGER STREAM sensor, 0.1 DEVICE '/dev/sensor0'
SELECT sensor[0]*100 STREAM scaled  FROM sensor
SELECT scaled[0]     STREAM history FROM scaled PERSISTENT
scaled pozostaje w pamięci, a history zapisuje dane na dysku według zwykłych zasad FILE, RETENTION i STORAGE. PERSISTENT dotyczy tylko wyniku danego SELECT; jego substraty nadal dziedziczą domyślną ulotność.
Dyrektywa może wystąpić tylko raz, przed pierwszym DECLARE, SELECT lub RULE. Nie zmienia źródeł DECLARE. Bez niej dotychczasowe programy zachowują swoje ustawienia. VOLATILE i PERSISTENT są wzajemnie wykluczającymi się klauzulami.
Jawne STORAGE profil przy SELECT zastępuje ustawienie domyślne; np. STORAGE DEFAULT wybiera zwykły magazyn plikowy. Jawne VOLATILE zachowuje pierwszeństwo nad STORAGE, tak jak wcześniej. Połączenie PERSISTENT STORAGE MEMORY jest błędem. Jawne SUBSTRAT 'profil' wybiera magazyn substratów niezależnie od kolejności tych dwóch dyrektyw w nagłówku. Samo FILE lub RETENTION nie wyłącza domyślnej ulotności: do zapisu historii należy dodać PERSISTENT. RETENTION pojemność segmenty przy strumieniu w pamięci jest błędem kompilacji z tą podpowiedzią.
Działanie
SELECT wyrażenie STREAM nazwa FROM źródło VOLATILE
Parser ustawia typ przechowywania na MEMORY z początkową pojemnością 1 albo n z klauzuli RETENTION n:
if (ctx->VOLATILE() != nullptr || inheritVolatile) {
    qry.policy = std::make_pair("MEMORY", std::max<size_t>(qry.policy.second, 1));
}
Następnie kompilator wyznacza pojemność wymaganą przez plan. Jeśli inny strumień czyta historię wyniku VOLATILE, bufor może pomieścić więcej niż jeden rekord. Oznacza to, że:
- bufor w pamięci przechowuje co najmniej ostatni rekord oraz historię potrzebną konsumentom,
- dane nie trafiają na dysk,
- deskryptor
.descjest tworzony - inne procesy mogą poznać schemat strumienia.
Pierścień ma pojemność max(RETENTION n, potrzeba planu, 1) i wlicza się do budżetu [limits] history_memory_mib. Przy dołączaniu reguły ad hoc DO DUMP -H TO M potrzeba H+1 slotów, wliczając rekord bieżący. Dla H > 0 serwer odrzuca żądanie, gdy pojemność N <= H; pierścienia nie można powiększyć w działającym planie. Zasady oczekiwania na historię opisuje Realizacja alarmowania. Zobacz Granice wymiarów planu.
Różnica względem STORAGE MEMORY
| Cecha | VOLATILE | STORAGE MEMORY |
|---|---|---|
| Pojemność bufora | 1 rekord albo RETENTION n; może wzrosnąć według planu | 1 rekord albo RETENTION n; może wzrosnąć według planu |
Klauzula RETENTION n | rozmiar pierścienia | rozmiar pierścienia |
Klauzula RETENTION n s | błąd kompilacji | błąd kompilacji |
Pierwszeństwo nad STORAGE | tak | - |
| Deskryptor na dysku | tak | tak |
| Dane na dysku | nie | nie |
VOLATILE przydaje się gdy wynik zapytania jest pobierany przez xqry na bieżąco i historia nie jest potrzebna - np. aktualna wartość czujnika udostępniana przez system operacyjny.
Przykład
DECLARE a INTEGER STREAM sensor, 0.1 DEVICE '/dev/sensor0'

SELECT sensor[0] * 100 STREAM scaled FROM sensor VOLATILE
Strumień scaled zawiera w każdej chwili jedną, aktualną wartość. Proces xqry może ją odczytać przez pamięć współdzieloną.
Typy STORAGE
Klauzula STORAGE w poleceniu SELECT oraz dyrektywa SUBSTRAT przyjmują jeden z następujących identyfikatorów. Każdy mapuje się na konkretną klasę akcesora danych w implementacji.
Tabela typów
| Słowo kluczowe | Klasa C++ | Retencja | Shadow | Przeznaczenie |
|---|---|---|---|---|
DEFAULT | groupFile<posixBinaryFileWithShadow> | tak | tak | Domyślny tryb produkcyjny; plik .shadow chroni modyfikacje |
DIRECT | groupFile<posixBinaryFile> | tak | nie | Retencja bez ochrony shadow |
MEMORY | memoryFile | tak (RAM) | nie | Dane wyłącznie w pamięci; bufor kołowy bez zapisu na dysk |
POSIX | posixBinaryFile | nie | nie | Pojedynczy plik binarny; bez retencji |
POSIXSHD | posixBinaryFileWithShadow | nie | tak | Pojedynczy plik z ochroną shadow; bez retencji |
GENERIC | genericBinaryFile | nie | nie | Generyczny plik binarny |
Inna wartość w STORAGE albo SUBSTRAT jest błędem kompilacji. Typy źródeł DECLARE - BINFILE, TEXTSOURCE i DEVICE, zapisywane w polu TYPE deskryptora źródła - nie są profilami magazynu: ich akcesory (binaryDeviceRO, textSourceRO) są tylko do odczytu, więc wynik SELECT nie może w nich powstać. Rodzaj źródła wybiera słowo kluczowe w DECLARE.
Odmowa nazywa strumień i dopuszczalne profile:
STORAGE DEVICE of stream dst is not a storage profile but a source kind of DECLARE; use DEFAULT, MEMORY, DIRECT, POSIX, POSIXSHD or GENERIC
W klauzuli STORAGE profil, jak każde słowo kluczowe, ma dwie pisownie - wielkimi albo małymi literami (MEMORY, memory); Memory jest błędem. Wartość dyrektywy SUBSTRAT jest napisem i wielkość liter nie ma w niej znaczenia.
Retencja - artefakty rotowane, starsze pliki usuwane automatycznie (wymaga RETENTION pojemność segmenty w SELECT).
Shadow - każda modyfikacja zapisywana jest do osobnego pliku .shadow; dane historyczne są chronione przed nadpisaniem.
W przypadku MEMORY retencja działa w pamięci jako bufor kołowy: kolejne dopisania nadpisują najstarszy slot (index % capacity). Dane nie są segmentowane do plików i nie trafiają na dysk. RETENTION n ustala rozmiar pierścienia (co najmniej tyle, ile wymaga plan) - tak samo przy STORAGE MEMORY i przy VOLATILE; postać z segmentami RETENTION n s jest tu błędem kompilacji.
Indeks rekordu pozostaje logicznym numerem dopisania, a nie numerem slotu pierścienia. Po C dopisaniach przy pojemności N dostępne są indeksy od max(0, C-N) do C-1. Odczyt lub nadpisanie starszego albo jeszcze niezapisanego rekordu zwraca z akcesora ERANGE; nie odczytuje ani nie zmienia nowszego rekordu zajmującego ten sam slot. Warstwa C++ storage przekazuje tę odmowę jako Result z Errc::IO i errno=ERANGE. Regresje zawiera ut_faccmemory.
Dane, bity NULL i licznik dopisań należą do MemoryStore. Akcesory o tej samej nazwie współdzielą je tylko w obrębie tego samego obiektu MemoryStore; każdy osadzony Engine ma własny. Wywołania bez jawnego magazynu używają MemoryStore::processDefault(). Ostatni akcesor zwalnia dane danej nazwy, więc nowy plan nie dziedziczy starego pierścienia.
Także bez RETENTION magazyn MEMORY ma skończoną pojemność: co najmniej jeden rekord, powiększoną przez kompilator do potrzeb konsumentów. Dawniejszy STORAGE MEMORY mógł rosnąć bez końca albo, przy RETENTION n, zapisać dane na dysk z niewłaściwym typem magazynu. Obecnie rozmiar pierścienia i łączny koszt historii podlegają budżetowi planu. Reguła ad hoc DO DUMP -H TO M wymaga H+1 slotów na historię i rekord bieżący. Przy H > 0 i pojemności N <= H żądanie jest odrzucane; dołączenie reguły nie zwiększa pojemności działającego magazynu. Zasady oczekiwania na historię opisuje Realizacja alarmowania.
Retencja na dysku
Magazyny DEFAULT i DIRECT trzymają dane w segmentach: RETENTION pojemność segmenty zachowuje co najwyżej segmenty plików po pojemność rekordów, a najstarszy segment jest kasowany przy otwarciu nowego. Postać jednoargumentowa RETENTION n oznacza wyłącznie rozmiar pierścienia MEMORY; na magazynie plikowym jest błędem kompilacji z podpowiedzią RETENTION n <segmenty>. segmenty = 0 znaczy „bez limitu segmentów”.
Przykładowo RETENTION 100 STORAGE DIRECT jest odrzucane, ponieważ nie podaje liczby segmentów. Poprawny zapis to RETENTION 100 4 STORAGE DIRECT. Dla STORAGE MEMORY obowiązuje odwrotna zasada: RETENTION 100 ustala pierścień, a RETENTION 100 4 jest odrzucane jako retencja segmentowa przy magazynie w RAM.
Tuż po rotacji na dysku zostaje tylko (segmenty - 1) * pojemność + 1 rekordów. Plan, który czyta wstecz więcej rekordów strumienia (przesunięcie >N, okno @, zakres DUMP), jest błędem kompilacji - odczyt skasowanego segmentu kończyłby działający serwer.
Strumień plikowy bez RETENTION, z segmenty = 0 albo w magazynie bez retencji (POSIX, POSIXSHD, GENERIC) rośnie na dysku bez granicy. Jest to dozwolone - historia trwała. Przy --verbose program xretractor wypisuje takie strumienie na stderr, zarówno przy starcie, jak i w trybie -c, także z --quiet i dla strumieni pośrednich wydzielonych przez kompilator. Bez --verbose na stderr nie ma tego wykazu; ostrzeżenia WARN w dzienniku zależą od konfiguracji logowania i są wyłączone przy budowaniu Release. Granicę dla wszystkich strumieni DEFAULT/DIRECT bez RETENTION może postawić operator kluczem default_retention = [pojemność, segmenty] w sekcji [storage] pliku retractor.toml. Bez tego klucza ograniczenie historii wynika z jawnego RETENTION; sprzątanie przy starcie opisano poniżej.
Start bez dyrektywy ROTATION zaczyna od zera wyniki SELECT i substraty: kasuje całą rodzinę ich plików - dane z plikiem .shadow, .desc, .meta i segmenty retencji. Nie usuwa plików źródeł DECLARE. Z dyrektywą ROTATION zachowane pliki magazynów dyskowych muszą pasować do planu: jeśli .desc ma inny typ magazynu albo inną retencję, start (i xqry --reset) jest odmową z nazwą strumienia i obiema konfiguracjami. W przypadku MEMORY także przy ROTATION usuwane są stare pliki deskryptora i metadanych, aby nowy pierścień nie odziedziczył konfiguracji poprzedniego planu. Zmiana pojemności przy zachowanych segmentach przestawiłaby adresowanie rekordów, dlatego operator wybiera: przywrócić poprzednią konfigurację w planie albo usunąć pliki strumienia.
NOTE: Typ
MEMORY(SUBSTRAT ‘memory’) ma pokrycie w testach:issue61_tmpmem(sekwencyjny i równoległy) opisanych w załączniku pt. Testy Integracyjne.
Dowiązania w ścieżkach magazynu
Zapis do plików magazynu odmawia podążania za dowiązaniem symbolicznym pod końcową nazwą danych, cienia, metadanych lub deskryptora. Jawny REF przekazany przez wywołującego może dopuścić dowiązanie głównego pliku danych; wyjątek nie obejmuje nazw segmentów retencji ani plików pomocniczych. Dowiązania katalogów nadrzędnych pozostają dozwolone. Szczegóły odmów, wyjątku REF i granic ochrony opisano w rozdziale Pliki.
Kiedy używać
Wybór zależy od wymagań środowiska:
- Środowisko produkcyjne, dane krytyczne →
DEFAULT(retencja + shadow) - Środowisko produkcyjne, dane nieistotne historycznie →
MEMORY(zero dysku, retencja w RAM) - Rozwój i debugowanie →
DEFAULTlubDIRECT(dane widoczne na dysku) - Odczyt z pliku binarnego, pliku tekstowego lub urządzenia → nie przez
STORAGE, lecz przez rodzaj źródła wDECLARE(BINFILE,TEXTFILE,DEVICE)
Przykład
SELECT str1[0] STREAM str1 FROM core0 STORAGE MEMORY
SELECT str2[0] STREAM str2 FROM core0 RETENTION 100 4 STORAGE DIRECT
Dla substratów globalnie - dyrektywa SUBSTRAT:
SUBSTRAT 'memory'
Operatory agregujące
Dwie osie agregacji (MIN, MAX, AVG, SUMC)
Te same cztery słowa kluczowe opisują dwie różne konstrukcje. Po stronie FROM reduktor zwija pola jednego bieżącego rekordu. W liście SELECT agregat okna rekordowego zwija jedną wartość wyrażenia obliczoną dla każdego z kolejnych rekordów historii. Położenie konstrukcji rozstrzyga zatem, czy redukcja biegnie poziomo po polach, czy pionowo po czasie.
Reduktory bieżącego rekordu w FROM
Reduktory strumieniowe działają na strumieniu posiadającym wiele pól - typowo na wyniku operatora @(k,w) albo na rekordzie zawierającym tablicę liczbową. Redukują wszystkie płaskie sloty jednego rekordu do jednej wartości.
Składnia
FROM AGREGATOR(wyrażenie_strumieniowe)
gdzie AGREGATOR to jedno z:
| Słowo kluczowe | Działanie |
|---|---|
min / MIN | minimum ze wszystkich pól rekordu |
max / MAX | maksimum ze wszystkich pól rekordu |
avg / AVG | średnia arytmetyczna pól rekordu |
sumc / SUMC | suma wszystkich pól rekordu |
Słowa kluczowe akceptowane są zarówno małymi, jak i wielkimi literami. Są zastrzeżone, dlatego strumień nie może nazywać się min, MAX, avg ani SUMC.
Argumentem może być całe wyrażenie strumieniowe, nie tylko pojedyncza nazwa. Dzięki temu okno i redukcję można zapisać bez pomocniczego zapytania:
SELECT * STREAM total FROM SUMC(src@(1,5))
Postać przyrostkowa strumień.min, .max, .avg i .sumc pozostaje zgodna wstecz, ale jest wygaszana. Parser emituje ostrzeżenie i zaleca postać funkcyjną. Dotychczasowy zapis src@(1,5).sumc jest poprawny, lecz nowe zapytania powinny używać SUMC(src@(1,5)).
Wyniku reduktora nie czyta się po nazwie w liście SELECT. Zapis SELECT avg STREAM o FROM AVG(src) jest odrzucany przez kompilator kanałem Check result:, bo avg jest w tym miejscu operatorem strumieniowym, a nie polem - nie ma go czym wykonać. Wynik redukcji odczytuje się przez SELECT * albo, gdy potrzebne są dalsze obliczenia, przez zmaterializowanie reduktora w osobnym strumieniu:
SELECT *      STREAM m FROM AVG(src)
SELECT m[0]*2 STREAM o FROM m
Pola tablicowe i wartości NULL
Liczbowa deklaracja T[N] jest jednym wpisem deskryptora, ale zajmuje N płaskich slotów rekordu. Reduktor odwiedza wszystkie te sloty. Dlatego poniższe zapytanie liczy minimum ze wszystkich 24 ogniw bieżącego rekordu, a nie tylko z cells[0]:
DECLARE cells INTEGER[24] STREAM battery, 1 TEXTFILE 'cells.txt'
SELECT * STREAM cell_min FROM MIN(battery)
Schematy strumieni pochodnych rozwijają tablice liczbowe do pól skalarnych, zachowując kolejność slotów i układ bajtów. STRING[N] jest natomiast jednym polem tekstowym o szerokości N bajtów, nie tablicą N liczb.
Wartości NULL są pomijane. Jeżeli wszystkie sloty rekordu mają wartość NULL, wynikiem redukcji jest NULL, a nie zero.
Interwał wyjściowy
Agregaty nie zmieniają częstotliwości strumienia - interwał wyniku jest taki sam jak źródła:
\[\Delta_{wynik} = \Delta_{strumień}\]
Typ wyniku
Typ wyniku zależy od typu wartości wejściowych:
| Typ wejściowy | Typ wyniku MIN/MAX/AVG/SUMC |
|---|---|
BYTE, INTEGER, UINT, RATIONAL | RATIONAL |
FLOAT | FLOAT |
DOUBLE | DOUBLE |
Dla typów całkowitych i wymiernych rachunek idzie po liczbach wymiernych, więc AVG nie traci reszty z dzielenia. Dotyczy to także MIN i MAX: minimum trzech siódemek ma typ RATIONAL i wartość 7/1, a nie typ INTEGER. FLOAT i DOUBLE zachowują swój typ; artefakt z takim wejściem nie zmienia się w pole RATIONAL.
Odbiorca pola RATIONAL musi znać układ pary licznik-mianownik (→ Układ pola RATIONAL) albo jawnie przepuścić wynik przez to_string, to_double lub to_integer.
Przykład: średnia z rekordu okna AGSE
DECLARE val INTEGER STREAM src, 1 TEXTFILE 'data.txt'

# AGSE buduje rekord z pięciu próbek, AVG redukuje jego pięć pól
SELECT * STREAM ma5 FROM AVG(src@(1,5))
Strumień ma5 zawiera w każdej chwili średnią z pięciu kolejnych próbek src. Jest to kompozycja operatora AGSE z reduktorem rekordu, a nie agregat z listy SELECT opisany niżej.
Przykład: filtr sygnałowy (sumc)
Fragment z przykładu implementacji filtru sygnałowego:
SELECT source[_] * filter[_] STREAM accRow FROM source@(1,25)+filter
SELECT accRow[0]             STREAM output FROM SUMC(accRow)
Okno znajduje się bezpośrednio w FROM, więc nie wymaga osobnego zapytania. source[_] rozwija się zgodnie z 25 slotami, które source@(1,25) wnosi do rekordu wejściowego. SUMC(accRow) sumuje wszystkie pola rekordu accRow - iloczyny próbek sygnału przez współczynniki filtru - produkując wyjście filtru FIR.
Przykład: MIN i MAX
DECLARE v INTEGER STREAM src, 0.1 DEVICE '/dev/urandom'
SELECT * STREAM min10 FROM MIN(src@(1,10))
SELECT * STREAM max10 FROM MAX(src@(1,10))
NOTE: Reduktory bieżącego rekordu mają pokrycie w testach
simple_max,wide_from_names,agse_arrayiarray_derived, opisanych w załączniku Testy integracyjne.
Agregaty okna rekordowego w SELECT
Składnia
SELECT wyrażenie_z_AGREGATOR(wartość_rekordu : szerokość) \
STREAM wynik FROM źródło
Sam AGREGATOR(wartość_rekordu : szerokość) jest operandem zwykłego wyrażenia pola. Można go łączyć z literałami, innymi polami, operatorami arytmetycznymi i funkcjami skalarnymi:
SELECT 2*MIN(a : 5)+1, null2zero(AVG(a+b : 5))-10 STREAM transformed FROM src
Nie wolno jedynie zagnieżdżać agregatu okna w argumencie innego agregatu okna. szerokość jest dodatnią liczbą rekordów. Dla rekordu wynikowego o indeksie logicznym n agregat oblicza wartość_rekordu osobno na rekordach źródła od n-(szerokość-1) do n, a następnie redukuje dokładnie te wartości. Okno jest stemplowane końcem i przesuwa się o jeden rekord. Interwał wyniku pozostaje równy interwałowi źródła, początek logiczny przesuwa się o szerokość-1, a ogon startowy jest dziedziczony ze źródła.
DECLARE a INTEGER, b INTEGER STREAM src, 1 TEXTFILE 'data.txt'

SELECT MIN(a : 5), MAX(a : 5), AVG(a+b : 5), SUMC(a : 5) STREAM stats FROM src
Kilka agregatów nad tym samym wyrażeniem, źródłem i szerokością współdzieli jedno przejście po historii. Wartości NULL są pomijane; okno bez ani jednej wartości obecnej daje NULL. Typ wyniku podlega tej samej tabeli promocji co reduktor bieżącego rekordu, a ustalony typ jest zachowywany przez czyste kopie, przesunięcia i pozostałe operatory kopiujące schemat.
Ograniczenia argumentu
Argument musi być liczbowym wyrażeniem odczytującym co najmniej jedno pole jednego przechowywanego źródła. Zapytanie z agregatem okna rekordowego musi mieć w FROM pojedyncze, zwykłe odwołanie do strumienia. Kompilator odrzuca:
- szerokość niedodatnią;
- wyrażenie tekstowe albo stałe, które nie odczytuje pola;
- wyrażenie mieszające historię kilku strumieni;
- zagnieżdżony agregat okna i użycie agregatu w warunku
RULE; - złożoną klauzulę
FROM, na przykładFROM src - 2; - gołą nazwę tablicy liczbowej.
Dla DECLARE a INTEGER[3] trzeba wskazać jeden kanał, na przykład MIN(a[0] : 5). MIN(a : 5) nie oznacza wszystkich elementów tablicy z każdego rekordu i zostaje odrzucone. Redukcję wszystkich elementów jednego rekordu zapisuje się osobno jako FROM MIN(strumień).
Łączenie redukcji po kanałach i po czasie
Obie osie można składać bez serializacji tablicy i bez ręcznego tworzenia osobnego strumienia dla każdego kanału:
DECLARE value INTEGER[24] STREAM sensors, 1/10 TEXTFILE 'sensors.txt'

SELECT *                    STREAM row_min      FROM MIN(sensors)
SELECT MIN(row_min[0] : 10) STREAM interval_min FROM row_min
Pierwszy MIN redukuje 24 równoległe wartości jednego rekordu. Drugi redukuje wyniki z dziesięciu kolejnych rekordów, więc interval_min jest minimum z 240 wartości, ale zachowuje interwał źródła i emituje przesuwne okno po każdym rekordzie. Jeżeli potrzebny jest wynik rzadszy, należy rozrzedzić gotowy strumień zgodnie z następną sekcją.
Hopping window
Agregat w SELECT nie ma argumentu kroku. Hopping window powstaje przez rozrzedzenie gotowego strumienia okien operatorem - w drugim węźle:
SELECT MIN(a : 5) STREAM sliding FROM src
SELECT *          STREAM hopping FROM sliding - 2
Argument operatora - jest docelowym interwałem wyniku. Dla skoku H nad źródłem o interwale \(\Delta\) należy podać \(H\Delta\). Rozdzielenie na dwa węzły zachowuje w każdym oknie pięć kolejnych rekordów i dopiero potem wybiera co H-ty wynik. Bezpośrednie SELECT MIN(a : 5) ... FROM src - 2 nie jest skrótem tej konstrukcji i nie kompiluje się.
NOTE: Składnię, typy, brzegi, współdzielenie obliczeń, wyrażenia, wartości
NULLi ograniczenia agregatów okna rekordowego sprawdzająwindow_aggregateoraz testy jednostkoweut_compileriut_expeval.
Dalszy rachunek na wyniku agregatu
Funkcje skalarne należą do składni wyrażeń pól, nie do żadnego rodzaju okna. Pełną listę, reguły nazw i arności oraz semantykę typów opisuje rozdział Wyrażenia pól i funkcje skalarne. Poniżej pozostają tylko konwersje szczególnie istotne przy odczycie wyniku agregatu.
isnull(x) zwraca 1 dla NULL i 0 dla wartości obecnej. null2zero(x) zamienia NULL na całkowite zero, ale wartość obecną przepuszcza bez zmiany jej typu. Jest to konwersja stratna, a nie sposób eksportu informacji o braku. Dzielenie przez zero daje NULL dla każdego typu liczbowego i nie zatrzymuje dalszego przetwarzania strumienia.
Przykład konwersji: to_string
Funkcja to_string konwertuje wyrażenie liczbowe na ciąg tekstowy o zadanej szerokości. Wynik trafia do pola typu STRING w strumieniu wynikowym.
Składnia
to_string(wyrażenie : szerokość)
to_string(wyrażenie)
Parametr szerokość (liczba naturalna po dwukropku :) określa szerokość pola wyjściowego w bajtach. Pominięcie parametru daje domyślną szerokość 32 bajtów.
ℹ️ Info
Separator argumentów to dwukropek
:, nie przecinek,. Przecinek jest separatorem listy SELECT - użycie przecinka wto_string(x, n)spowoduje błąd parsowania.
Przykład
DECLARE v INTEGER STREAM src, 1 TEXTFILE 'data.txt'

SELECT to_string(src[0]:10) STREAM labels FROM src
Strumień labels zawiera wartości src sformatowane jako tekst w polu 10-bajtowym.
Konkatenacja z literałem
Ciąg wynikowy można łączyć z literałem stringowym operatorem +:
SELECT to_string(src[0]:8) + '_ok' STREAM tagged FROM src
Rozmiar pola wynikowego: 8 (z to_string) + 3 (literal _ok) = 11 bajtów.
Zastosowanie
to_string przydaje się przy eksporcie do systemów przyjmujących dane tekstowe (Graphite, InfluxDB przez xqry) lub przy tworzeniu etykiet zdarzeń łączonych z wyjściem DO DUMP.
NOTE: Opisana funkcjonalność ma pokrycie w testach:
issue121_isnull,issue128_numeric_to_string,issue128_string_to_numericopisanych w załączniku pt. Testy Integracyjne.
Przykład konwersji: to_integer
Funkcja to_integer konwertuje wyrażenie liczbowe na pole typu INTEGER. Jest podstawową drogą odczytu artefaktu z agregatem: pole RATIONAL zamienia na liczbę całkowitą, którą czytelnik odczyta bez znajomości układu pary licznik-mianownik.
Składnia
to_integer(wyrażenie)
Zaokrąglenie
⚠️ Ostrzeżenie
to_integerobcina w stronę zera, a nie podłoguje. Dla wartości ujemnych wynik różni się od podłogi o jeden.
Reguła jest ta sama dla argumentu wymiernego i zmiennoprzecinkowego - w obu przypadkach część ułamkowa jest odrzucana, a znak zachowany:
| Wartość wejściowa | to_integer | podłoga (dla porównania) |
|---|---|---|
8/3 | 2 | 2 |
-8/3 | -2 | -3 |
-4/3 | -1 | -2 |
-2.6666… | -2 | -3 |
Wartość NULL przechodzi przez funkcję bez zmiany - to_integer(NULL) daje NULL, a nie zero.
Pułapka przy przenoszeniu na Pythona
Operator // w Pythonie podłoguje, więc naiwne przepisanie zapytania rozjeżdża się z silnikiem na każdej wartości ujemnej:
>>> -8 // 3        # Python: podłoga
-3
>>> int(-8 / 3)    # to samo, co robi to_integer
-2
Model odtwarzający zachowanie silnika musi liczyć średnią obciętą jawnie:
def truncated_mean(values):
    """Obcięcie w stronę zera, tak jak rzutowanie średniej wymiernej."""
    total = sum(values)
    quotient = abs(total) // len(values)
    return quotient if total >= 0 else -quotient
Ten sam problem dotyczy każdego języka, w którym dzielenie całkowite podłoguje.
Zastosowanie
to_integer jest właściwe tam, gdzie odbiorca artefaktu ma przyjąć liczbę całkowitą i część ułamkowa nie jest potrzebna. Tam, gdzie wartość ma pozostać dokładna, właściwe jest to_string, które zapisuje ułamek jako tekst licznik/mianownik, albo odczyt pary wprost (→ Układ pola RATIONAL).
NOTE: Opisana funkcjonalność ma pokrycie w testach:
issue128_string_to_numericopisanym w załączniku pt. Testy Integracyjne, oraz w testach jednostkowychut_payloadiut_convertTypes, przypinających układ polaRATIONALi regułę zaokrąglenia.
Polecenie RULE
To polecenie to jedno z ostatnich opracowanych przeze mnie rozszerzeń systemu. Rozszerza ono funkcjonalność systemu o mechanizm alarmowania.
NOTE: Opisana funkcjonalność ma pokrycie w testach:
issue42_ruleopisanych w załączniku pt. Testy Integracyjne.
Składnia polecenia RULE przedstawia się następująco:
RULE nazwa_reguły
ON nazwa_strumienia_danych
WHEN warunek_logiczny
DO DUMP kroki_wstecz TO kroki_w_przód [RETENTION segmenty]
Lub w taki sposób:
RULE nazwa_reguły
ON nazwa_strumienia_danych
WHEN warunek_logiczny
DO SYSTEM polecenie_systemu
Rys. 8. Diagram składni polecenia RULE
Diagram składni (railroad) przedstawiony na Rys. 8 został wygenerowany z reguły rule_statement gramatyki ANTLR4 (RQL.g4). Za DO są trzy warianty: DUMP zapisuje zakres rekordów, SYSTEM wykonuje polecenie systemowe, a SET ?NAZWA = wyrażenie zleca zmianę zmiennej planu. Zaokrąglone pola oznaczają symbole dosłowne, prostokąty wartości użytkownika, a tory omijające element jego opcjonalność.
Tak zdefiniowane zdarzenia podpinają się do zdefiniowanych strumieni danych. Nazwa reguły musi być unikalna w obrębie strumienia wskazanego przez ON; różne strumienie mogą mieć reguły o tej samej nazwie. Strumień danych powinien zostać zdefiniowany przed pojawieniem się polecenia stworzenia reguły w pliku rql.
W każdej postaci polecenia RULE tworzona jest nazwa reguły, warunek logiczny oraz nazwa strumienia do którego proces uruchamiany poleceniem DO jest podłączany. Warunek może korzystać z pól strumienia wskazanego przez ON, stałych LET i bieżących wartości VAR.
W pierwszej wersji polecenia w której występuje klauzula DO DUMP definiujemy proces, który umożliwia zebranie danych, które napłyną w przyszłości. Jeśli pominiemy klauzulę RETENTION, zrzut nastąpi bezpośrednio do pliku z nazwą reguły poprzedzonej nazwą strumienia. Jeśli dołączymy klauzulę RETENTION, pliki będą podlegały retencji w zakresie zdefiniowanej w parametrze ‘segmenty’. Będą dołączane sekwencyjne numery na końcu każdego zrzutu. Zrzuty są binarne i zachowują schemat wszystkich pól źródłowego strumienia danych. Tutaj na uwagę powinno zasługiwać to, że polecenie tworzy proces w systemie, który po pojawieniu się warunku logicznego którego wartość powinna być prawdą – pobiera dane z przeszłości oraz zakłada ich napływ i rejestrację w przyszłości. Nic nie stoi na przeszkodzie aby jednak zebrać dane tylko z przeszłości lub tylko z przyszłości. Jeśli wartości kroki_* przyjmą wartości ujemne to odnosimy się do przeszłości (tzn. do danych historycznych w stosunku do momentu wystąpienia zdarzenia opisanego warunkiem logicznym)
Klauzula DO SYSTEM umożliwia wywołanie zdarzenia systemowego po zajściu w warunku logicznego opartego na zarejestrowanych danych. W ten sposób dowolne polecenie systemowe może zostać wywołane.
Przykłady deklaracji reguł w języku RQL:
RULE testrule1 ON str1 WHEN str1[0] > 11 DO DUMP -5 TO 5 RETENTION 100

RULE testrule2 \
ON str1 \
WHEN str1[0] = 13 OR str1[0] = 11 \
DO SYSTEM 'echo "systemcall"'
Zakładamy, że zdefiniowano uprzednio strumień str1 którego dane w postaci liczb o typie całkowitym pojawiają się co sekundę. W takim przypadku pierwsza reguła podpinając się do tego strumienia oczekuje aż dane, których wartość przekracza wartość 11. Jeśli takie zdarzenie zajdzie dokona się zrzut danych obejmujących obszar 5 sekund wstecz i 5 sekund po zajściu zdarzenia opisanego w warunku logicznym.
Druga reguła z trochę innym warunkiem logicznym wyświetli na ekranie w którym został uruchomiony proces systemu RetractorDB tekst o treści „systemcall”.
Składnia polecenia RULE
Pełna składnia polecenia RULE ma postać:
RULE <nazwa>
ON <strumień>
WHEN <warunek>
DO <akcja>
Gdzie <akcja> jest dokładnie jedną z trzech form:
SYSTEM '<polecenie_systemowe>'
DUMP [-]<krok_wstecz> TO [-]<krok_w_przód> [RETENTION <n>]
SET ?NAZWA = <wyrażenie_skalarne>
Ograniczenie
Reguła może być podpięta wyłącznie pod strumień zadeklarowany poleceniem SELECT (artefakt lub substrat). Podpięcie pod strumień wejściowy DECLARE jest błędem kompilacji:
# NIEPRAWIDŁOWE - core0 jest deklaracją, nie można podpiąć reguły
RULE r1 ON core0 WHEN core0[0] > 10 DO SYSTEM 'echo alarm'
Warunek WHEN
Warunek to wyrażenie logiczne ewaluowane do wartości prawda/fałsz po każdej nowej próbce strumienia.
Operatory porównania: =, !=, <, >, <=, >=. Operatory logiczne: OR, AND, NOT. Przykłady:
WHEN str1[0] > 100
WHEN str1[0] = 0 OR str1[0] = 255
WHEN str1[0] >= 10 AND str1[0] <= 90
WHEN NOT str1[0] = 0
Akcja DO SYSTEM
Akcja DO SYSTEM wykonuje podane polecenie powłoki (przez wywołanie system(3)) w momencie spełnienia warunku. RetractorDB loguje kod wyjścia polecenia - niezerowy kod jest raportowany jako błąd w logu.
RULE alert1 \
ON wyniki \
WHEN wyniki[0] > 1000 \
DO SYSTEM 'curl -s http://monitoring/alert'
W poleceniu można użyć dowolnego programu dostępnego w PATH: skryptów powłoki, programów Pythona, wywołań REST, wysyłki powiadomień, etc.
Regułę DO SYSTEM wolno zamówić tylko w pliku planu, z którego instancja startuje - autorem tego pliku jest ten, kto uruchamia usługę. Oba kanały IPC odmawiają: xqry --adhoc przyjmuje reguły DO DUMP i DO SET, a xqry --reset odrzuca cały plan zawierający DO SYSTEM, bo kanał ten nie niesie autorstwa (→ xqry). Operator, który świadomie oddaje kanał reset, ustawia service.unrestricted = true w konfiguracji TOML (→ xretractor).
Akcja DO SET
DO SET ?NAZWA = wyrażenie zapisuje zmienną zadeklarowaną przez VAR. Prawa strona jest wyrażeniem skalarnym nad bieżącym rekordem ON, stałymi LET i zmiennymi planu; jej typ musi być typem zmiennej. Stała LET nie może być celem. NULL zastępuje poprzednią wartość.
VAR COUNT = 0
DECLARE x INTEGER STREAM src, 1 TEXTFILE 'signal.txt'
SELECT src[0], ?COUNT STREAM counted FROM src
RULE tick ON counted WHEN 1 = 1 DO SET ?COUNT = ?COUNT + 1
Rekord counted pokazuje stan licznika sprzed slotu. Zapis jest buforowany i widoczny od następnego slotu. Przy kilku zapisach tej samej zmiennej wygrywa ostatnia wyzwolona reguła w kolejności tekstowej. Jedna reguła wykonuje jedną akcję; do połączenia SET i DUMP potrzebne są dwie reguły z tym samym warunkiem.
Reguła SET na całej rodzinie generatora jest odrzucana. Szczegóły kontekstów, typów, ad hoc i resetu oraz przykłady histerezy i uc10 zawiera rozdział VAR i DO SET.
Akcja DO DUMP
Akcja DO DUMP zapisuje okno próbek strumienia do pliku binarnego w momencie spełnienia warunku. Pozwala zachować kontekst zdarzenia: dane przed jego wystąpieniem i dane po nim.
RULE zdarzenie ON wyniki WHEN wyniki[0] > 500 DO DUMP -10 TO 5
Parametry zakresu:
| Parametr | Znaczenie |
|---|---|
ujemny step_back (np. -10) | dołącz 10 próbek historycznych sprzed zdarzenia |
0 jako step_back | zacznij zrzut od chwili zdarzenia |
dodatni step_back (np. 2) | opóźnij start zrzutu o 2 próbki po zdarzeniu |
step_forward (np. 5) | zbierz łącznie step_forward - step_back próbek |
Całkowita liczba zrzucanych rekordów: abs(step_forward - step_back). Przykład: DUMP -5 TO 5 → 10 rekordów (5 historycznych + 5 kolejnych). DUMP 0 TO 1 → 1 rekord (bieżąca próbka).
Granica step_back musi być ściśle mniejsza od step_forward. Równe lub odwrócone granice są odrzucane przez parser, także przy dołączaniu reguły ad hoc. Wartość step_back może być ujemna (historia) lub nieujemna (opóźnienie). Obie granice mogą być ujemne: DUMP -5 TO -2 zapisuje trzy rekordy o pozycjach t-5, t-4 i t-3 względem rekordu wyzwalającego t. Prawa granica jest wyłączona; ten zakres nie obejmuje rekordu bieżącego ani przyszłych.
Pliki zrzutu
Pliki są tworzone w katalogu konfigurowanym przez dyrektywę STORAGE. Konwencja nazewnictwa:
<strumień>_<nazwa_reguły>_dump.tmp          # bez RETENTION
<strumień>_<nazwa_reguły>_dump_<n>.tmp      # z RETENTION (n = 0..N-1)
Format pliku to surowe dane binarne zgodne z deskryptorem strumienia (bez nagłówka). Do odczytu pliku można użyć narzędzia xtrdb.
Zrzut niesie wyłącznie wartości. Nie towarzyszy mu ani .desc, ani .meta, więc schemat trzeba podać z zewnątrz, a mapa NULL i przerwy w transmisji nie mają w nim żadnej reprezentacji: pole NULL zapisuje się wartością zastępczą swojego typu, a rekord, którego silnik nie miał, zerami. Informacje o braku i o przerwie są pojęciami wnętrza silnika i na zewnątrz nie wychodzą - pełny kontrakt wraz z drogami, które wierność zachowują, opisuje Realizacja alarmowania.
Opcja RETENTION
Parametr RETENTION <n> ogranicza liczbę przechowywanych zrzutów - stary plik jest nadpisywany przez nowy (bufor cykliczny). Bez RETENTION każde wyzwolenie nadpisuje jeden plik _dump.tmp.
RULE zdarzenie ON wyniki WHEN wyniki[0] > 500 DO DUMP -10 TO 5 RETENTION 20
Powyższy przykład przechowuje 20 ostatnich zrzutów w plikach wyniki_zdarzenie_dump_0.tmp … wyniki_zdarzenie_dump_19.tmp.
Wiele reguł dla jednego strumienia
Do jednego strumienia można przypiąć dowolną liczbę reguł różnych typów:
RULE alert_wysoki \
ON pomiary \
WHEN pomiary[0] > 900 \
DO SYSTEM 'notify-send "Przekroczono prog"'

RULE alert_niski \
ON pomiary \
WHEN pomiary[0] < 10 \
DO SYSTEM 'notify-send "Zbyt niska wartosc"'

RULE zapis_anomalii \
ON pomiary \
WHEN pomiary[0] > 900 \
DO DUMP -20 TO 10 RETENTION 5
Wszystkie reguły danego strumienia są ewaluowane przy każdej nowej próbce.
Konstrukcja mechanizmu
Przez alarmowanie rozumiemy proces przetwarzania danych bieżących i bieżącego reagowania systemu w razie rozpoznania zaistniałego zjawiska przez system. Aby alarmowanie mogło funkcjonować, musza w systemie istnieć mechanizmy wspierające ten proces. W systemie RetractorDB opracowałem model alarmowania oparty na deklaracji reguł związanych z obserwacją strumieni danych. Reguły te zawierają operacje matematyczne umożliwiające analizę warunków logicznych i uruchomienie zewnętrznych procesów lub realizację zrzutu danych w wybranym oknie czasowym.
NOTE: Opisana funkcjonalność ma pokrycie w testach:
issue42_ruleopisanych w załączniku pt. Testy Integracyjne.
Prezentacji składni polecenia RULE na stronie 24 wspomina o tej funkcjonalności. W tym rozdziale chciałbym przybliżyć zasady działania tego rozwiązania.
Budując przykład przedstawiający zasadę działania alarmowania stwórzmy następujący plik zapytania – query.rql:
DECLARE a UINT STREAM core0, 1 TEXTFILE 'datafile1.txt'
SELECT str4[0] STREAM str4 FROM core0>1

RULE regulation1 \
ON str4 \
WHEN str4[0] = 20 or str4[0] = 23 \
DO SYSTEM 'echo "test"'
W pliku datafile1.txt znajdują się liczby w postaci tekstowej od 20 do 28.
$ seq 20 28 > datafile1.txt
Powyższe 3 polecenia deklarują efemeryczne źródło danych, jedno polecenie przetwarzania danych poprzez przesunięcie w czasie o jedną próbkę w czasie. Oraz regułę alarmowania. Wykonanie następującego polecenia:
$ xretractor -c query.rql -d -u -p -i > out.dot &&
dot -Tpng out.dot -o out.png
Wyświetlając plik out.png zobaczymy na ekranie coś zbliżonego (Rys. 9):
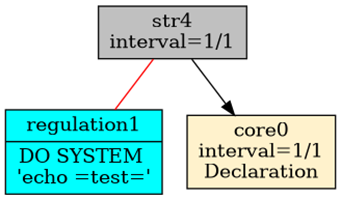
Rys. 9 Zależność obiektów w przypadku użycia alarmowania
Obraz zaprezentuje jaka zachodzi zależność pomiędzy procesami odpowiedzialnymi za artefakty, alarmowanie oraz efemerydy. Równie dobrze powinno się udać podłączyć proces odpowiedzialny za alarmowanie do substratu.
Obiekty alarmowania przedstawiane są w kolorze błękitnym i połączone z obiektami, które monitorują za pomocą czerwonych, nieskierowanych linii.
Obiektów odpowiedzialnych za alarmowanie można podłączyć więcej niż jeden. Można podać więcej poleceń RULE skojarzonych z danym poleceniem tworzącym strumień danych.
Jeśli przyjrzymy się bliżej zobaczymy, że z procesem odpowiedzialnym za alarmowanie jest uruchamiany warunkiem. Następującym poleceniem możemy podejrzeć co tam właściwie się dzieje:
$ xretractor -c query.rql -d -u -p > out.dot &&
dot -Tpng out.dot -o out.png
Plik wyjściowy prezentuje się w następujący sposób (Rys. 10):
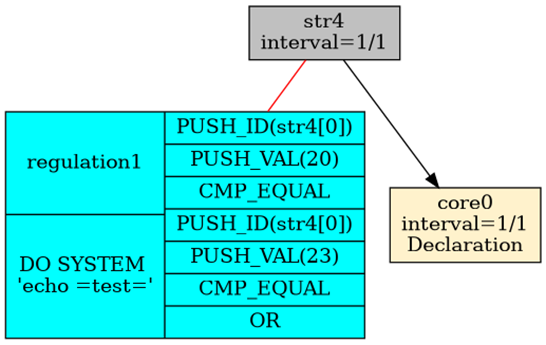
Rys. 10 Kod odpowiedzialny za warunek uruchomienia alarmowania.
Ten warunek musi zostać w ostatecznej formie wyliczony do wyrażenie reprezentującego prawdę lub fałsz.
Warunek logiczny w RULE
Klauzula WHEN polecenia RULE przyjmuje wyrażenie logiczne, które jest ewaluowane na każdym nowym rekordzie wskazanego strumienia. Jeśli wyrażenie zwraca prawdę - uruchamiany jest proces zdefiniowany w klauzuli DO.
Operatory porównania
| Operator | Znaczenie |
|---|---|
= | równy |
!= | różny |
> | większy |
< | mniejszy |
>= | większy lub równy |
<= | mniejszy lub równy |
Pojedyncze porównanie ma dwa operandy skalarne. Łańcuchy takie jak 0 < pomiary[0] < 10, 0 <= pomiary[0] < 10 lub pomiary[0] = 1 = 1 są błędami składni; parser wskazuje drugi operator porównania. Zakres zapisuje się przez dwa porównania połączone AND:
RULE zakres ON pomiary WHEN 0 < pomiary[0] AND pomiary[0] < 10 DO DUMP -1 TO 0
Odrzucanie łańcuchów obowiązuje od poprawki #555. Starszy parser przyjmował je i używał wyniku porównania jako operandu kolejnego porównania; nie sprawdzał w ten sposób zakresu.
Spójniki logiczne
| Operator | Znaczenie |
|---|---|
AND | koniunkcja - oba warunki muszą być spełnione |
OR | alternatywa - wystarczy jeden warunek |
NOT | negacja - warunek musi być niespełniony |
Priorytety w WHEN, od najwyższego do najniższego, to: arytmetyka, porównanie, NOT, AND, OR. NOT pomiary[0] < 0 neguje wynik całego porównania pomiary[0] < 0; dla wartości obecnej warunek jest prawdziwy, gdy pole jest nieujemne. W NOT pomiary[0] < 0 AND pomiary[0] > 5 negacja dotyczy pierwszego porównania, a oba warunki łączy AND. AND wiąże mocniej niż OR.
Od poprawki #555 NOT należy wyłącznie do warunku WHEN. Nie można używać go jako operatora pola w SELECT ani wewnątrz arytmetyki, np. pomiary[0] + NOT pomiary[0]. Wcześniej NOT pomiary[0] < 0 negowało samo pole, a dopiero potem porównywało wynik z zerem, przez co warunek nigdy nie był prawdziwy.
Gramatyka nie obsługuje nawiasów grupujących warunki logiczne ani porównania. Nawiasy mogą grupować wyrażenia arytmetyczne po obu stronach porównania, np. (pomiary[0]+1) < 10. Złożone warunki należy zapisywać z uwzględnieniem powyższych priorytetów.
Warunek z samym polem STRING jest prawdziwy, gdy napis nie jest pusty. Porównanie napisów i NOT nad napisem zwracają INTEGER 1 albo 0. AND i OR używają typu lewego operandu, a jeśli jest on NULL - prawego; wynik oparty na napisie jest INTEGER. Dlatego WHEN NOT status[0] jest prawdziwe dla pustego napisu, a fałszywe porównanie napisu nie uruchamia reguły przez OR. Wartość NULL nadal podlega trójwartościowej logice warunku.
Struktura wyrażenia
Warunek buduje się z pól schematu strumienia wskazanego w klauzuli ON. Pola identyfikowane są tak samo jak w SELECT - przez nazwę strumienia z indeksem:
WHEN strumień[indeks] operator wartość
Złożone warunki łączymy spójnikami:
WHEN strumień[0] > 10 AND strumień[1] != 0
WHEN strumień[0] = 5 OR strumień[0] = 7
WHEN NOT strumień[0] < 0
Przykłady
RULE alarm_wysoki \
ON pomiary \
WHEN pomiary[0] > 100 OR pomiary[0] < -100 \
DO DUMP -10 TO 10 RETENTION 50

RULE sygnalizacja \
ON status \
WHEN status[0] = 1 AND status[1] != 0 \
DO SYSTEM 'systemctl restart sensor-reader'

RULE jednorazowy ON dane WHEN NOT dane[0] = 0 DO DUMP -5 TO 0
Dostęp do pól
Warunek odwołuje się do pól strumienia wskazanego w ON. Indeks pola odpowiada pozycji w schemacie tego strumienia - tak samo jak w klauzuli SELECT. Warunek czyta rekord wyjściowy strumienia, więc indeks równy liczbie jego pól lub większy jest błędem kompilacji (zob. Indeks poza zakresem). Aliasowanie działa identycznie jak opisano w rozdziale Aliasowanie.
Jeżeli strumień z ON powstał przez przeplot A#B, warunek musi używać nazwy strumienia wynikowego:
RULE poprawna ON wynik WHEN wynik[0] > 0 DO DUMP -1 TO 0
Odwołanie do nazwanej składowej przeplotu jest niejednoznaczne i kończy kompilację błędem:
RULE bledna ON wynik WHEN A[0] > 0 DO DUMP -1 TO 0
Reguła obowiązuje również wtedy, gdy # jest ukryty w substracie złożonego wyrażenia FROM.
Przykład alarmowania
W oknie terminala uruchamiamy proces xretractor uruchamiając przedstawiony z początku rozdziału plik query.rql
$ xretractor query.rql
test
test
test
…
W drugim oknie terminala proponuję uruchomić polecenie:
$ xqry -s str4
27
28
20
21
22
23
24
25
26
27
Oba okna proponuję ustawić obok siebie. Zobaczymy, że pojawianie się wartości 20 i 23 powoduje uruchomienie akcji po stronie serwera wyświetlającej napis test. Należy pamiętać, że w systemie może pojawić się dowolne polecenie systemowe lub wywołanie dowolnego programu w zależności o tego co umieścimy w deklaracji DO SYSTEM.
Zapis sesji (Animacja poniżej):

Animacja. Zapis sesji przykładu alarmowania
Przykład 2: zapis kontekstu zdarzenia (DO DUMP)
Akcja DO DUMP pozwala utrwalić okno próbek z otoczenia zdarzenia - dane sprzed i po jego wystąpieniu. Jest to przydatne gdy chcemy zachować kontekst anomalii do późniejszej analizy.
Tworzymy plik query.rql:
STORAGE 'temp'

DECLARE a INTEGER STREAM core0, 1 TEXTFILE 'datafile1.txt'
SELECT str1[0] STREAM str1 FROM core0

RULE zapis_anomalii ON str1 WHEN str1[0] > 24 DO DUMP -3 TO 3
Dane wejściowe - liczby od 20 do 28:
$ seq 20 28 > datafile1.txt
Uruchamiamy xretractor:
$ xretractor query.rql
Gdy wartość strumienia str1 przekroczy 24, reguła wyzwoli zapis 6 rekordów (3 historyczne + 3 kolejne) do pliku binarnego temp/str1_zapis_anomalii_dump.tmp.
Odczyt pliku zrzutu
Plik zrzutu nie zawiera nagłówka .desc - przy otwieraniu w xtrdb należy podać schemat ręcznie:
$ xtrdb
> storage temp
> open str1_zapis_anomalii_dump { INTEGER a }
> size
> list 6
> quit
Wypisane wartości są wszystkim, co plik niesie: zrzut nie ma też pliku .meta, więc NULL i przerwa w transmisji nie mają w nim reprezentacji, a zero może być prawdziwym zerem, polem NULL albo rekordem, którego silnik nie miał (→ Realizacja alarmowania).
Przykład 3: rotacja zrzutów (DO DUMP z RETENTION)
Bez RETENTION każde kolejne wyzwolenie reguły nadpisuje ten sam plik. Gdy zdarzenia powtarzają się, użyj RETENTION N aby zachować ostatnie N zrzutów w osobnych plikach.
STORAGE 'temp'

DECLARE a INTEGER STREAM core0, 1 TEXTFILE 'datafile1.txt'
SELECT str1[0] STREAM str1 FROM core0

RULE zapis_anomalii ON str1 WHEN str1[0] > 24 DO DUMP -3 TO 3 RETENTION 5
Każde wyzwolenie tworzy kolejny plik (rotacja cykliczna):
temp/str1_zapis_anomalii_dump_0.tmp
temp/str1_zapis_anomalii_dump_1.tmp
temp/str1_zapis_anomalii_dump_2.tmp
temp/str1_zapis_anomalii_dump_3.tmp
temp/str1_zapis_anomalii_dump_4.tmp
Po przekroczeniu pojemności (RETENTION 5) najstarszy plik jest nadpisywany przez nowy.
Przykład 4: wiele reguł na jednym strumieniu
Do jednego strumienia można przypiąć dowolną liczbę reguł. Poniższy przykład łączy obie akcje - powiadomienie systemowe i zapis kontekstu:
STORAGE 'temp'

DECLARE a INTEGER STREAM core0, 1 TEXTFILE 'datafile1.txt'
SELECT str1[0] STREAM str1 FROM core0

RULE prog_dolny \
ON str1 \
WHEN str1[0] < 21 \
DO SYSTEM 'echo "ALARM: wartosc ponizej progu dolnego" >> alarm.log'

RULE prog_gorny \
ON str1 \
WHEN str1[0] > 26 \
DO SYSTEM 'echo "ALARM: wartosc powyzej progu gornego" >> alarm.log'

RULE zapis_kontekstu ON str1 WHEN str1[0] > 26 DO DUMP -5 TO 5 RETENTION 10
Reguły prog_gorny i zapis_kontekstu reagują na ten sam warunek niezależnie - przekroczenie progu górnego jednocześnie zapisuje log i utrwala okno danych. Reguła prog_dolny obsługuje osobno próg dolny.
Wszystkie trzy reguły są ewaluowane przy każdej nowej próbce strumienia str1.
Polecenie LET
Polecenie LET nadaje nazwę stałej liczbowej. Plan może potem odwoływać się do niej przez ?NAZWA wszędzie tam, gdzie przyjmuje liczbę: w parametrach okna @, indeksach pól, rozmiarach, przesunięciu, interwałach, retencji, granicach DUMP i w wyrażeniach. Zapytanie opisuje wtedy rolę parametru (WINDOW_WIDTH, ALARM_LIMIT) zamiast powtarzać magiczne liczby, a zmiana parametru wymaga edycji jednego wiersza.
Stała nie jest zmienną: jej wartość jest ustalona w chwili wczytania planu i nie zmienia się podczas wykonania. Liczby wpisane wprost w zapytanie (literały) pozostają pełnoprawne, a obie formy mogą występować w jednym planie.
NOTE: Opisana funkcjonalność ma pokrycie w testach:
let_constants,let_typediadhoc_parse_erroropisanych w załączniku pt. Testy Integracyjne oraz w testach jednostkowych kompilatora (ut_compiler).
Składnia
LET nazwa_stałej = wartość
LET nazwa_stałej : TYP = wartość
Rys. 67. Diagram składni polecenia LET
Diagram składni (railroad) przedstawiony na Rys. 67 został wygenerowany na podstawie reguły let_statement z gramatyki ANTLR4 systemu (RQL.g4). Za słowem kluczowym LET stoi nazwa stałej, opcjonalna adnotacja typu : TYP (zob. Jawny typ), znak = i wartość: liczba całkowita lub dziesiętna albo ułamek licznik/mianownik, każda z opcjonalnym znakiem minus.
Przykład syntetyczny:
LET SIGNAL_INDEX = 0
LET STATUS_INDEX = 1
LET WINDOW_STEP = 3
LET WINDOW_WIDTH = 16
LET ALARM_LIMIT = 250

DECLARE signal INTEGER, status INTEGER STREAM sample, 1 TEXTFILE 'sample.txt'
SELECT sample[?SIGNAL_INDEX], sample[?STATUS_INDEX] STREAM channels FROM sample
SELECT * STREAM block FROM channels@(?WINDOW_STEP, ?WINDOW_WIDTH)
RULE high_signal ON channels WHEN channels[?SIGNAL_INDEX] >= ?ALARM_LIMIT DO DUMP -1 TO 1
Kompilacja tego planu (xretractor -c) daje dokładnie ten sam plan co zapis z literałami 0, 1, @(3, 16) i >= 250.
Prawa strona
Prawą stroną jest zawsze jeden literał:
| Postać | Przykład | Uwagi |
|---|---|---|
| liczba całkowita | LET N = 16, LET OFFSET = -3 | zakres 32-bitowej liczby całkowitej ze znakiem |
| liczba dziesiętna | LET GAIN = 0.5, LET T = 2. | postać jak literał zmiennoprzecinkowy RQL; zapis z wykładnikiem (1E3) nie jest przyjmowany |
| ułamek | LET SOURCE_INTERVAL = 1/40 | mianownik różny od zera |
Wyrażenie (LET A = 1 + 2), odwołanie do innej stałej (LET B = ?A) i znak plus (LET X = +1) są błędami składni.
Jawny typ
Adnotacja LET NAZWA : TYP = literał nadaje stałej typ niezależny od pisowni literału. TYP to INTEGER, UINT, FLOAT, DOUBLE albo RATIONAL, także w pisowni Integer, Uint, Float, Double, Rational - ta sama lista co w VAR. STRING, BYTE i inne typy są błędem składni. Stała bez adnotacji zachowuje się jak dotąd (zob. Typ stałej), a plan bez adnotacji kompiluje się do identycznego planu.
Literał deklaracji przechodzi tę samą konwersję co literał zmiennej z adnotacją (macierz w rozdziale VAR - Jawny typ): do INTEGER i UINT tylko dokładnie, do RATIONAL dokładnie z tekstu literału (0.25 to 1/4), do FLOAT i DOUBLE z zaokrągleniem. Literał bez wartości w danym typie jest odmową wskazującą deklarację, np. line 1:4: value -1 of constant ?N is out of range for UINT.
W wyrażeniu SELECT i RULE ... WHEN stała z adnotacją jest liczbą w typie z adnotacji. Pozwala to zapisać w wyrażeniu wartości, których literał nie wyraża:
LET K : DOUBLE = 0.1
LET Q : RATIONAL = 1/4
LET N : UINT = 3000000000

DECLARE x DOUBLE, k INTEGER, u UINT STREAM src, 1 TEXTFILE 'data.txt'
SELECT src[0] * ?K, src[1] * ?Q, src[2] STREAM scaled FROM src
RULE above ON scaled WHEN scaled[2] > ?N DO DUMP -1 TO 1
src[0] * ?Kmnoży przez0.1w precyzjiDOUBLE. StałaLET C = 0.1bez adnotacji jest w wyrażeniu wartościąFLOAT(0.100000001490116…), ato_double(?C)tego nie naprawia, bo argument jest jużFLOAT.src[1] * ?Qdaje poleRATIONAL(dlak = 3wartość3/4). Bez adnotacji ułamek w wyrażeniu jest odmową, a zapis1/4- dzieleniem całkowitym.scaled[2] > ?Nporównuje dwie wartościUINT. Liczby 3000000000 nie da się zapisać literałem całkowitym w wyrażeniu.
Typ pola SELECT wynika z typów operandów tak jak dla pól i literałów: DOUBLE * FLOAT daje DOUBLE, INTEGER * RATIONAL - RATIONAL, UINT + INTEGER - UINT.
-?NAZWA neguje wartość w typie z adnotacji. Negacja bez wartości w tym typie jest odmową: przy LET N : UINT = 5 zapis -?N daje expression -?N = 5 (line 3:8) is out of range for UINT.
Po prawej stronie DO SET stała z adnotacją zachowuje się jak każda stała: jeśli jest całą prawą stroną, jej tekst jest konwertowany do typu zmiennej (zob. VAR), a adnotacja stałej nie ma znaczenia. Przy LET K : DOUBLE = 0.1 i VAR R : RATIONAL = 0 zapis DO SET ?R = ?K ustawia dokładnie 1/10. Każda inna prawa strona ze stałą typowaną ma typ wynikający z typów operandów, jak każde wyrażenie.
W kontekstach strukturalnych (indeksy, rozmiary, @, >, okna, retencja, DUMP, interwały, TIMEOUT) stała z adnotacją jest dopuszczalna tylko z typem naturalnym dla kontekstu: INTEGER w kontekstach całkowitych, INTEGER albo RATIONAL w interwale DECLARE, w operatorach &, %, - i w TIMEOUT. Kontekst bierze wtedy wartość po konwersji: LET W : INTEGER = 4/2 w src > ?W daje to samo co src > 2, a LET T : RATIONAL = 0.0000001 jako interwał to dokładnie 1/10000000. Każda inna adnotacja jest odmową, a nie cichą konwersją: kto pisze LET W : DOUBLE = 3, zadeklarował wartość DOUBLE, a przesunięcie wymaga liczby całkowitej - line 3:27: constant ?W : DOUBLE cannot be used in time shift; it takes a constant without annotation or annotated INTEGER.
Nazwa i odwołanie
Nazwa stałej zaczyna się od litery i składa się z liter, cyfr i podkreślników. Znak $ jest niedozwolony, aby odwołania nie myliły się z indeksem generatora strumieni. Wielkość liter ma znaczenie: ?signal i ?SIGNAL to różne stałe.
Odwołanie to jeden token: znak ? i bezpośrednio po nim nazwa, bez spacji (? NAZWA jest błędem leksera). Stałe mają osobną przestrzeń nazw: ?X nigdy nie jest polem ani strumieniem, a goły identyfikator X nigdy nie jest stałą. Stała może więc nosić tę samą nazwę co pole, strumień lub funkcja bez kolizji, a istniejące zapytania nie zmieniają znaczenia. ? wewnątrz napisu, ścieżki, komentarza i polecenia SYSTEM pozostaje zwykłym tekstem.
Słowo LET (także let) jest zastrzeżone i nie może być nazwą strumienia, pola ani reguły.
Zasięg
- Stała obowiązuje od wiersza deklaracji do końca pliku planu.
LETmoże stać w dowolnym miejscu pliku, ale przed pierwszym użyciem; odwołanie przed deklaracją jest błędem. - Ponowna deklaracja tej samej nazwy jest błędem, także przy kolizji z VAR.
LETiVARdzielą przestrzeń nazw; stałej nie da się nadpisać ani użyć jako celuDO SET. - Stałe należą do jednego planu: nie przechodzą do innego pliku, kolejnego wczytania ani zapytań ad hoc.
- Nieużyta stała nie jest błędem.
xretractorwypisuje ostrzeżenie na stderr, także z--quiet, np.xretractor: warning: line 2: constant ?UNUSED is declared but never used. Przy ponownym wczytaniu planu przez kanał reset to samo ostrzeżenie trafia do dziennika serwera.
Gdzie można użyć stałej
?NAZWA może stanąć wszędzie tam, gdzie gramatyka przyjmuje literał liczbowy. W każdym miejscu podlega tym samym ograniczeniom co literał (zakres, znak, granice planu z rozdziału Granice wymiarów planu).
| Miejsce | Zapis ze stałą | Wymagana wartość |
|---|---|---|
parametry okna @ | src@(?WINDOW_STEP, ?WINDOW_WIDTH), src@(?STEP, -?WIDTH) | całkowita; krok > 0, szerokość różna od zera (ujemna jak w literale) |
| indeks pola | src[?FIELD_INDEX] | całkowita, ≥ 0 |
| rozmiar pola tablicowego | INTEGER[?CHANNEL_COUNT], STRING[?TEXT_WIDTH] | całkowita, > 0 |
| rozmiar rodziny strumieni | STREAM result[?FAMILY_SIZE] | całkowita, > 0 |
| indeks generatora | src[?LAST_INDEX-$] | całkowita; arytmetyka indeksu jak dla literału |
| przesunięcie | src > ?SHIFT | całkowita, ≥ 0 |
| okno rekordowe | AVG(src[?FIELD_INDEX] : ?HISTORY_WIDTH) | całkowita, > 0 |
| szerokość tekstu | to_string(x : ?TEXT_WIDTH) | całkowita, > 0 |
| retencja | RETENTION ?CAPACITY ?SEGMENTS | całkowite; pojemność > 0, segmenty ≥ 0 |
DUMP | DUMP -?BEFORE TO ?AFTER RETENTION ?KEEP | całkowite; granice jak w literale, retencja ≥ 0 |
interwał DECLARE | STREAM src, ?SOURCE_INTERVAL TEXTFILE '...' | > 0 |
operatory &, %, - | src - ?OUTPUT_INTERVAL | > 0 |
TIMEOUT | TIMEOUT ?WAIT | ≥ 0 |
wyrażenie w SELECT i RULE ... WHEN | src[0] * ?GAIN + ?OFFSET, x >= ?ALARM_LIMIT | całkowita lub dziesiętna; z adnotacją także UINT, DOUBLE i RATIONAL |
Na diagramach składni poleceń SELECT, DECLARE i RULE gałąź ?stała stoi obok liczby wszędzie tam, gdzie diagram pokazuje liczbę: przy rozmiarach, interwałach, TIMEOUT, retencji i granicach DUMP. Pozostałe miejsca z tabeli należą do wyrażeń, których diagramy nie rozpisują.
Przykład obejmujący wszystkie konteksty jednocześnie:
LET SOURCE_INTERVAL = 1/40
LET TEXT_WIDTH = 8
LET FAMILY_SIZE = 2
LET LAST_INDEX = 1
LET VALUE_INDEX = 0
LET HISTORY_WIDTH = 4
LET SHIFT = 2
LET OUTPUT_INTERVAL = 1/20
LET GAIN = 0.5
LET OFFSET = -3
LET CAPACITY = 1000
LET SEGMENTS = 2

DECLARE value INTEGER, label STRING[?TEXT_WIDTH] STREAM src, ?SOURCE_INTERVAL TEXTFILE 'wide.txt'
SELECT src[?LAST_INDEX-$] STREAM fam[?FAMILY_SIZE] FROM src
SELECT AVG(src[?VALUE_INDEX] : ?HISTORY_WIDTH) STREAM avg_value FROM src
SELECT to_string(src[?VALUE_INDEX] : ?TEXT_WIDTH) STREAM text FROM src > ?SHIFT
SELECT src[?VALUE_INDEX] * ?GAIN + ?OFFSET STREAM scaled FROM src - ?OUTPUT_INTERVAL RETENTION ?CAPACITY ?SEGMENTS
Typ stałej
Stała bez adnotacji ma typ swojego literału. W każdym miejscu parser zamienia ją tak samo, jak zamieniłby literał tej postaci wpisany w to miejsce, bez niejawnej konwersji:
| Kontekst | stała całkowita | stała dziesiętna | ułamek |
|---|---|---|---|
konteksty całkowite (indeksy, rozmiary, @, >, okna, retencja, DUMP) | wartość | odmowa: is not an integer | odmowa: is not an integer |
interwał DECLARE, &, %, -, TIMEOUT | n jak literał n | jak literał x.y (zamiana na ułamek z tą samą kontrolą zakresu) | jak literał a/b |
wyrażenie w SELECT i RULE ... WHEN | INTEGER | FLOAT | odmowa: w wyrażeniu 1/40 jest dzieleniem całkowitym, a nie literałem ułamka - zapisz stałą dziesiętnie |
Stała z adnotacją ma typ z adnotacji - zob. Jawny typ.
Ułamek złożony ze stałej, np. ?N/40 lub ?A/?B, nie jest literałem ułamka. W interwale jest błędem składni, a w wyrażeniu - zwykłym dzieleniem wartości stałej przez 40.
Znak minus
Tam, gdzie literał przyjmuje znak minus (szerokość okna @, granice DUMP, TIMEOUT, wyrażenia), można napisać -?X. Zapis neguje wartość stałej, a wynik podlega tym samym ograniczeniom co literał. Przy LET W = 3 zapis src@(1, -?W) daje to samo co src@(1, -3), a przy LET W = -3 zapis src@(1, ?W) daje ten sam wynik. W wyrażeniu -?X jest jednym czynnikiem, jak literał -2: -?X^2 oznacza (-X)^2. W TIMEOUT ujemny wynik jest odmową: TIMEOUT -?W przy W = 1 daje DECLARE dev: TIMEOUT ?W = 1 (...) must not be negative, a -?Z przy Z = 0 jest przyjmowane.
Stała znika przed wykonaniem
Stałe rozwiązuje wyłącznie parser: do kompilatora trafiają już liczby. Deklaracja LET nie tworzy strumienia, pola, węzła planu ani operacji wykonywanej dla każdego rekordu, a nazwy nie są wyszukiwane w trakcie przetwarzania.
Skutki:
- plan z
LETi ten sam plan z literałami dają identyczny wynik kompilacji: programy, schematy, typy, interwały, wymagania historii i retencji; - wydruki
xretractor -c(tekst, CSV i graf DOT) pokazują liczby, nie nazwy stałych - nazwy występują tylko w komunikatach parsera; - optymalizacje planu działają na liczbach, jak dla literałów.
Zapytania ad hoc
Zapytanie ad hoc (xqry) nie widzi stałych działającego planu. Zapytanie z deklaracją LET jest odrzucane ('LET' is not supported), a odwołanie ?X kończy się błędem nieznanej stałej. Odmowa nie zmienia działającego planu i nie zatrzymuje serwera.
Błędy
Każdy błąd stałej jest odmową kompilacji: xretractor kończy pracę z kodem błędu, a serwer odrzuca zapytanie bez zmiany planu. Komunikat podaje nazwę stałej, kontekst i pozycję wiersz:kolumna w pliku planu.
| Sytuacja | Przykład komunikatu |
|---|---|
| nieznana stała lub użycie przed deklaracją | line 2:14: constant ?NOPE in field index is not declared; LET must precede its first use |
| ponowna deklaracja | line 3:4: constant ?A is already declared on line 2 |
$ w nazwie | line 2:4: constant name A$B must not contain '$' |
| zerowy mianownik | line 2:4: fraction 1/0 of constant ?D has a zero denominator |
| wartość poza zakresem literału | line 2:4: value 2147483648 of constant ?X is out of range |
| wartość niecałkowita w kontekście całkowitym | line 3:14: constant ?H = 0.5 in field index is not an integer |
ułamek w wyrażeniu (bez adnotacji; z : RATIONAL jest przyjmowany) | constant ?F = 1/40 (line 3:19) is a fraction, which an expression has no literal for; write it as a decimal |
| literał bez wartości w typie z adnotacji | line 1:4: value 2.5 of constant ?N is out of range for INTEGER |
| negacja bez wartości w typie z adnotacji | expression -?N = 5 (line 3:8) is out of range for UINT |
| adnotacja niedopuszczalna w kontekście strukturalnym | line 3:9: constant ?N : UINT cannot be used in field index; it takes a constant without annotation or annotated INTEGER |
| naruszenie ograniczenia miejsca | AGSE window ?W = 0 (line 3:34) must be greater than zero, interval ?N = -1 (line 3:29) must be greater than zero, DUMP RETENTION ?B = -2 (line 4:52) must not be negative |
wyrażenie lub odwołanie po prawej stronie, spacja po ?, typ spoza listy (BYTE, STRING) | błąd składni parsera, np. token recognition error at: '? ' |
Ograniczenia miejsca, których nie da się sprawdzić w chwili podstawienia - np. indeks poza schematem strumienia czy pusty zakres DUMP - zgłasza kompilator tym samym komunikatem co dla literału.
Pomiary i porównania
Narzędzia porównujące różne wersje silnika na tym samym tekście planu wymagają, aby każda porównywana wersja umiała ten plan wczytać. Wersje sprzed wprowadzenia LET odrzucają plan ze stałymi, dlatego do takich porównań należy używać planów z literałami, a warianty z LET trzymać w osobnych plikach.
Polecenie VAR i akcja DO SET
VAR deklaruje zmienną liczbową wspólną dla całego planu. Odczyt ?NAZWA pobiera jej bieżącą wartość, a reguła RULE ... DO SET zleca zmianę. Zmienna pozwala zapamiętać stan między rekordami: zatrzask alarmu, licznik od początku pracy albo średnią wykładniczą. Nie tworzy strumienia, pola ani węzła drzewa zapytań.
W odróżnieniu od stałej LET, podstawianej przez parser, VAR pozostaje częścią stanu wykonania. Ten sam znacznik ? oznacza stałą albo zmienną zależnie od deklaracji.
Składnia, nazwy i typy
VAR NAZWA = literał
VAR NAZWA : TYP = literał
RULE nazwa_reguły ON strumień WHEN warunek DO SET ?NAZWA = wyrażenie
Diagram jest generowany z reguły var_statement gramatyki RQL.g4. Prawą stroną deklaracji jest jeden literał, z opcjonalnym minusem. Bez jawnego typu typ zmiennej wynika z pisowni literału:
| Deklaracja | Typ zmiennej | Uwagi |
|---|---|---|
VAR COUNT = 0 | INTEGER | 32-bitowa liczba całkowita ze znakiem |
VAR GAIN = 0.5 | FLOAT | 32-bitowa liczba zmiennoprzecinkowa, także przy zapisie 0.0 |
VAR RATIO = 1/3 | RATIONAL | ułamek z niezerowym mianownikiem |
Napisy, NULL jako literał inicjalizujący, wyrażenia (VAR X = 1 + 2), odwołania (VAR X = ?Y), znak plus i zapis wykładniczy nie są przyjmowane. Wartość musi mieścić się w zakresie literału danego typu.
Nazwa zaczyna się od litery, dalej zawiera litery, cyfry i podkreślniki. Wielkość liter ma znaczenie; $ jest niedozwolony. W odwołaniu nie ma spacji po ?. Deklaracja musi poprzedzać pierwsze użycie. LET i VAR mają jedną przestrzeń nazw: nie można zadeklarować tej samej nazwy ponownie, także zmieniając rodzaj deklaracji. Ta przestrzeń jest odrębna od nazw pól i strumieni. VAR, var, SET i set są słowami zastrzeżonymi, podobnie jak nazwy typów, w tym RATIONAL i Rational.
Jawny typ
Adnotacja VAR NAZWA : TYP = literał ustala typ zmiennej niezależnie od pisowni literału. TYP to INTEGER, UINT, FLOAT, DOUBLE albo RATIONAL, także w pisowni Integer, Uint, Float, Double, Rational. Tylko w ten sposób można zadeklarować zmienną UINT albo DOUBLE, bo te typy nie mają własnej postaci literału. W pozostałych przypadkach adnotacja zapisuje intencję w planie: VAR SUMA : FLOAT = 0 zamiast VAR SUMA = 0.0. STRING, BYTE i inne typy są błędem składni. Tę samą adnotację przyjmuje stała LET.
Literał deklaracji jest konwertowany do wskazanego typu. Do INTEGER i UINT konwersja musi być dokładna. Do RATIONAL wartość jest liczona dokładnie z tekstu literału i skracana, więc 0.25 daje 1/4. Do FLOAT i DOUBLE wartość jest zaokrąglana tak jak literał dziesiętny w wyrażeniu. Literał, który nie ma wartości w danym typie, kończy kompilację odmową z nazwą, typem i pozycją, np. line 1:4: value -1 of variable ?N is out of range for UINT.
| Literał \ typ | INTEGER | UINT | FLOAT | DOUBLE | RATIONAL |
|---|---|---|---|---|---|
10 | 10 | 10 | 10.0 | 10.0 | 10/1 |
-1 | -1 | odmowa | -1.0 | -1.0 | -1/1 |
2.5 | odmowa | odmowa | 2.5 | 2.5 | 5/2 |
2.0, 4/2 | 2 | 2 | 2.0 | 2.0 | 2/1 |
1/3 | odmowa | odmowa | zaokrąglone | zaokrąglone | 1/3 |
3000000000 | odmowa | 3000000000 | 3000000000.0 | 3000000000.0 | odmowa |
0.123456789012 | odmowa | odmowa | zaokrąglone | zaokrąglone | odmowa |
RATIONAL przechowuje licznik i mianownik jako 32-bitowe liczby całkowite ze znakiem. Dlatego 3000000000 i 0.123456789012, którego mianownik po skróceniu przekracza ten zakres, nie mają wartości w tym typie. UINT przyjmuje literały od 0 do 4294967295.
Poniższy plan czyta signal.txt, w którym każdy wiersz zawiera próbkę DOUBLE i znacznik całkowity:
VAR COUNT : UINT = 0
VAR TOTAL : DOUBLE = 0
VAR LIMIT : RATIONAL = 0.25

DECLARE x DOUBLE, k INTEGER STREAM src, 1 TEXTFILE 'signal.txt'
SELECT src[0], src[1], ?COUNT, ?TOTAL, ?LIMIT STREAM totals FROM src
RULE count ON totals WHEN totals[0] > ?LIMIT DO SET ?COUNT = ?COUNT + 1
RULE acc ON totals WHEN 1 = 1 DO SET ?TOTAL = ?TOTAL + totals[0]
RULE raise ON totals WHEN totals[1] > 0 DO SET ?LIMIT = ?LIMIT * 2
RULE clear ON totals WHEN totals[1] < 0 DO SET ?COUNT = 0
RULE restore ON totals WHEN totals[1] < 0 DO SET ?LIMIT = 0.1
TOTAL sumuje pole DOUBLE bez zawężania do FLOAT. Bez adnotacji akumulator wymagałby to_float(...) w każdym SET i traciłby precyzję. COUNT jest zerowany literałem 0, a LIMIT wraca do dokładnie 1/10. Oba zapisy działają dzięki konwersji literału w SET. Plan bez adnotacji liczy to samo co przed jej wprowadzeniem.
Nieużyta zmienna powoduje ostrzeżenie declared but never used, także przy --quiet; samo użycie jej jako celu SET wystarcza, aby była uznana za użytą.
Dozwolone konteksty
| Miejsce | Odczyt VAR |
|---|---|
wyrażenie skalarne listy SELECT | tak, np. src[0] * ?GAIN |
warunek RULE ... WHEN | tak, np. ?ALARM = 0 |
prawa strona DO SET | tak, np. ?COUNT + 1 |
| indeksy pól i generatora, rozmiary pól i rodzin strumieni | odmowa |
parametry @, przesunięcie >, interwały, operatory &, % i - na strumieniach | odmowa |
szerokość okna rekordowego, szerokość to_string, TIMEOUT, RETENTION, granice DUMP | odmowa |
argument agregacji po oknie rekordowym, np. AVG(src[0] * ?GAIN : 4) | odmowa |
Wartości strukturalne ustalają kształt planu i czas przetwarzania; można tam używać literałów albo LET. VAR w argumencie okna rekordowego jest odrzucana, ponieważ historyczny rekord nie niesie historycznej wartości zmiennej. Aby najpierw utrwalić przeskalowane wartości, utwórz osobny strumień SELECT, a okno oblicz nad jego polami.
Warunek i prawa strona SET korzystają z bieżącego rekordu strumienia wskazanego przez ON, stałych LET i zmiennych planu. Odwołanie do pola innego strumienia, reduktor strumieniowy albo okno rekordowe w SET są odrzucane; potrzebne dane należy wcześniej obliczyć w SELECT. Cel ON musi być strumieniem utworzonym przez SELECT. Reguła SET na całej rodzinie generatora jest odrzucana: jej kopie pisałyby jedną zmienną z tym samym pierwszeństwem. VAR jest wspólna dla planu, a stan osobny dla kanałów wymaga osobnych deklaracji i reguł.
Zapis widoczny od następnego slotu
Slot to jedna chwila siatki czasowej, w której silnik oblicza wszystkie należne strumienie. Wszystkie wyrażenia SELECT, warunki i prawe strony SET w tym slocie czytają wartości zmiennych sprzed slotu. Zapis trafia do bufora, a silnik zatwierdza go dopiero na końcu udanego slotu, po przesunięciu źródeł. Czytelnicy widzą go od następnego slotu, niezależnie od swojej pozycji w planie.
Na strumieniu o innym interwale zmiana będzie widoczna przy jego następnym należnym rekordzie. Slot nie jest stałym opóźnieniem w sekundach. Przy jednym strumieniu próbkowanym co sekundę jest to opóźnienie o jedną próbkę. Slot przerwany błędem nie zatwierdza zapisów zmiennych; nie oznacza to wycofania zapisanych już rekordów ani efektów DUMP lub SYSTEM.
Histereza
Poniższy kompletny plan czyta signal.txt (jedna liczba całkowita na wiersz):
LET ALARM_ON = 250
LET ALARM_OFF = 200
VAR ALARM = 0

DECLARE x INTEGER STREAM src, 1 TEXTFILE 'signal.txt'
SELECT src[0], ?ALARM STREAM status FROM src
RULE alarm_on ON status WHEN status[0] >= ?ALARM_ON DO SET ?ALARM = 1
RULE alarm_off ON status WHEN status[0] < ?ALARM_OFF DO SET ?ALARM = 0
| Slot | Wejście | status[1]: stan zapisany w rekordzie | ALARM po slocie |
|---|---|---|---|
| 0 | 220 | 0 | 0 |
| 1 | 260 | 0 | 1 |
| 2 | 220 | 1 | 1 |
| 3 | 190 | 1 | 0 |
| 4 | 220 | 0 | 0 |
Przekroczenie 250 w slocie 1 ustawia zmienną po obliczeniu rekordu. Dlatego pole alarmu jest równe 1 dopiero w slocie 2. Między progami stan pozostaje zapamiętany. Reguła sprawdzająca bezpośrednio próbkę może wykonać DUMP w slocie przekroczenia; reguła sprawdzająca dopiero zmienną zobaczy zmianę w następnym slocie.
Licznik i średnia wykładnicza
VAR COUNT = 0
VAR E = 0.0

DECLARE x INTEGER STREAM src, 1 TEXTFILE 'signal.txt'
SELECT src[0], ?COUNT, ?E STREAM history FROM src
RULE count ON history WHEN history[0] > 100 DO SET ?COUNT = ?COUNT + 1
RULE ema ON history WHEN 1 = 1 DO SET ?E = ?E * 0.5 + history[0] * 0.5
Dla pierwszych trzech próbek równych 200:
| Slot | COUNT w rekordzie | E w rekordzie | COUNT po slocie | E po slocie |
|---|---|---|---|---|
| 0 | 0 | 0.0 | 1 | 100.0 |
| 1 | 1 | 100.0 | 2 | 150.0 |
| 2 | 2 | 150.0 | 3 | 175.0 |
Rekord pokazuje licznik i EMA obliczone z wcześniejszych próbek. Jest to opóźnienie o slot, jak rejestr z^-1. Początkowe E = 0.0 i 32-bitowa arytmetyka FLOAT są częścią tego przykładu.
Konflikty zapisów
Jeśli kilka reguł zapisuje tę samą zmienną w jednym slocie, wygrywa ostatnia wyzwolona reguła w kolejności tekstowej planu, także gdy reguły dotyczą różnych strumieni. Nie rozstrzyga kolejność wykonania węzłów, ich interwał ani pozycja instrukcji SELECT. Reguła z fałszywym warunkiem nie bierze udziału w konflikcie.
Wszystkie prawe strony czytają tę samą starą wartość: dwie wyzwolone reguły SET ?COUNT = ?COUNT + 1 dają łącznie przyrost o 1, a nie o 2. Jedna reguła ma jedną akcję (SET, DUMP albo SYSTEM); kilka akcji wymaga kilku reguł z takim samym warunkiem.
uc10: chłodnia i licznik cykli sprężarki
Przykład pochodzi z publicznego szkicu uc10. Temperatura w temp.txt jest podawana co sekundę w dziesiątych częściach stopnia. hour.txt zawiera po jednej liczbie całkowitej na takt godzinny. Sprężarka włącza się przy 5,0 stopnia i wyłącza przy 2,0; więcej niż 6 cykli wyzwala zrzut historii.
LET T_ON = 50
LET T_OFF = 20
LET MAX_CYCLES = 6
VAR COMP = 0
VAR CYCLES = 0

DECLARE t INTEGER STREAM temp, 1 TEXTFILE 'temp.txt'
DECLARE k INTEGER STREAM hour, 3600 TEXTFILE 'hour.txt'
SELECT temp[0], ?COMP, ?CYCLES STREAM status FROM temp
SELECT hour[0] STREAM hour_tick FROM hour
RULE cycle ON status WHEN status[0] >= ?T_ON AND ?COMP = 0 DO SET ?CYCLES = ?CYCLES + 1
RULE comp_on ON status WHEN status[0] >= ?T_ON DO SET ?COMP = 1
RULE comp_off ON status WHEN status[0] <= ?T_OFF DO SET ?COMP = 0
RULE hour_reset ON hour_tick WHEN 1 = 1 DO SET ?CYCLES = 0
RULE short_cycling ON status WHEN ?CYCLES > ?MAX_CYCLES DO DUMP -60 TO 0
Reguła cycle wykrywa zbocze: w slocie włączenia COMP nadal ma wartość 0, choć comp_on zleca już zapis 1. Gdy cycle i hour_reset wyzwolą się razem, późniejsza w tekście hour_reset ustala CYCLES = 0. Cykl rozpoczęty dokładnie w tym slocie nie zostaje doliczony do nowej godziny. Dotyczy to również początkowego slotu wspólnego dla obu strumieni; wolny strumień nie czeka godziny na swój pierwszy rekord.
short_cycling również czyta stan sprzed slotu: siódmy cykl jest widoczny w warunku od następnego slotu. Zrzut -60 TO 0 obejmuje 60 wcześniejszych rekordów i nie obejmuje rekordu wyzwalającego. Przykład pokazuje stan planu; nie wysyła polecenia do fizycznej sprężarki.
Zapisz wybrany kompletny plan w osobnym pliku i sprawdź go poleceniem xretractor -c plan.rql. Kompilacja nie wymaga istnienia źródeł; wykonanie wymaga wskazanych plików i katalogu wyników. Przykłady są syntetyczne i nie pochodzą z korpusu uc01-uc08 używanego w pracy DEBS.
Typowanie i NULL
Typ zmiennej jest ustalony raz w deklaracji: przez adnotację albo, bez niej, przez literał. Wyrażenie po prawej stronie SET musi mieć dokładnie ten typ; niejawnej konwersji nie ma. Przy VAR X = 0 zapis SET ?X = ?X + 0.5 to odmowa kompilacji; podobnie zapis DOUBLE do zmiennej FLOAT. Użyj jawnej konwersji, np. to_integer(...), to_float(...) lub to_double(...), albo zadeklaruj zmienną w typie wyrażenia. Gdy wyrażenie ma typ INTEGER, UINT, FLOAT, DOUBLE albo RATIONAL, komunikat odmowy podpowiada taką deklarację: ... use an explicit conversion function or declare VAR X : FLOAT = ....
Wyjątkiem jest prawa strona SET złożona z jednego literału, także ujemnego, albo jednej stałej LET. Parser konwertuje ją do typu zmiennej tak samo jak literał deklaracji z adnotacją, licząc z tekstu literału. SET ?COUNT = 0 zeruje zmienną UINT, SET ?E = 0 zmienną FLOAT, a SET ?LIMIT = 0.1 zapisuje w zmiennej RATIONAL dokładnie 1/10. Literał bez wartości w typie zmiennej jest odmową z celem, typem i pozycją, np. value -1 in DO SET ?COUNT is out of range for UINT; tak samo SET ?X = 0.5 przy VAR X = 0. Nawias i ułamek tworzą już wyrażenie. (0) ma typ INTEGER, a 1/4 jest dzieleniem całkowitym o typie INTEGER, więc oba zapisy są odmową dla zmiennej UINT i RATIONAL, a 1/4 w zmiennej INTEGER daje 0. Ułamek zapisuje się do zmiennej RATIONAL jako literał dziesiętny 0.25 albo przez stałą: LET Q = 1/4 i SET ?LIMIT = ?Q. Ułamkowa stała LET jest odmową w wyrażeniu, ale jako cała prawa strona SET jest przyjmowana.
Wynik NULL, także z dzielenia przez zero, przepełnienia albo odczytu brakującego pola, zastępuje poprzednią wartość. Typ deklaracji pozostaje bez zmian. NULL propaguje się w kolejnych wyrażeniach; ?X * 0 z NULL nadal daje NULL. Można sprawdzić go przez isnull(?X) i zapisać poprawną wartość regułą. Samo ?X = 0 nie wykrywa NULL; warunek, który daje NULL, nie wyzwala akcji.
Cykl życia i restart
Wartości zaczynają od literałów deklaracji przy pierwszym wczytaniu planu, jego ponownym wczytaniu, zaakceptowanym xqry --reset i restarcie usługi. Także ponowne wczytanie identycznego tekstu zeruje pamiętany stan do wartości z deklaracji. VAR nie jest zapisywana w artefaktach ani odtwarzana z nich. Odrzucone ad hoc lub reset nie zmieniają wartości i reguł działającego planu; przyjęte ad hoc zachowuje wartości istniejących zmiennych.
Zmiana kontraktu: utrata samonaprawy po restarcie. Plan bez VAR, oparty na skończonej historii wejść, może odtworzyć wynik po ponownym zgromadzeniu wymaganych okien i ogona rozruchowego. Stan VAR może zależeć od zdarzenia dowolnie odległego w przeszłości, więc samo odczekanie startupLatency go nie odtworzy. W przykładzie histerezy alarm ustawiony na 1 po restarcie wraca do 0. Jeśli kolejne próbki pozostaną w paśmie 200-249, stan sprzed restartu nie wróci; potrzebne jest nowe przekroczenie progu włączenia albo odtworzenie właściwej historii od początku.
Powrót do stanu z deklaracji jest przyjętym zachowaniem po przerwie monitorowania: silnik nie zakłada, co zaszło podczas utraty sygnałów. Nie ma obecnie opcji trwałości VAR w config.toml; ewentualny tryb opt-in jest osobnym tematem #543.
Ad hoc i monitoring
Kanał ad hoc pozwala czytać VAR aktywnego planu w SELECT i WHEN oraz dołączać reguły DO SET. Nie pozwala deklarować VAR ani LET i nie widzi stałych LET pliku planu. Reguła dołączona ad hoc zaczyna oceniać warunek od następnego nowego rekordu celu; jej zapis obowiązuje od slotu po wyzwoleniu. W konflikcie wygrywa z regułami planu i wcześniej dołączonymi regułami ad hoc. Po wymianie planu reguły ad hoc znikają wraz ze starą epoką.
xqry --vars (-v) pokazuje spójny obraz zatwierdzonych wartości między slotami, w kolejności deklaracji. Z --yaml zwraca listę variables; --jsonl jest odrzucane. To odczyt: bezpośrednie polecenie przypisania wartości przez xqry nie istnieje. Zmianę może zlecić reguła DO SET, także dołączona ad hoc. Stan pokazany między slotami może już zawierać zapis, którego nie ma jeszcze w polu zmiennej ostatniego rekordu SELECT.
Pokrycie w testach
Kontrakt sprawdzają ut_compiler, ut_expeval, ut_expressionShape, ut_exprSimplify i ut_dataModel oraz integracje it_var_read-run, it_var_set-value, it_var_reset-run, it_var_adhoc-run, it_var_xqry-run i it_var_typed-value. var_typed sprawdza zmienne z adnotacją UINT, DOUBLE i RATIONAL wobec wyroczni Pythona, wraz z typami w xqry --vars. var_set porównuje histerezę, licznik, EMA i przeskalowane uc10/uc11/uc12/uc14 z niezależną wyrocznią Pythona liczoną od początku przebiegu. var_reset pokazuje utratę zatrzasku po ponownym wczytaniu. Jest to zakres opisany w katalogu testów, a nie deklaracja trwałości lub sterowania urządzeniami.
Dyrektywy konfiguracyjne
Dostępne są cztery dyrektywy konfiguracyjne:
- STORAGE
- SUBSTRAT
- ROTATION
- DEFAULT VOLATILE
STORAGE, SUBSTRAT i ROTATION przyjmują parametr tekstowy w apostrofach. DEFAULT VOLATILE nie przyjmuje napisu. Przykład dyrektyw z parametrem:
STORAGE 'temp_folder'
SUBSTRAT 'memory'
ROTATION 'rotation_counter.txt'
Rys. 11. Diagram składni dyrektyw konfiguracyjnych
Diagram składni (railroad) przedstawiony na Rys. 11 został wygenerowany na podstawie reguł compiler_option i default_statement z gramatyki ANTLR4 systemu (RQL.g4). Trzy górne gałęzie (reguła compiler_option) mają identyczną budowę: jedno ze słów kluczowych STORAGE, SUBSTRAT lub ROTATION (zaokrąglone zielone pola), po którym następuje wartość ujęta w apostrofy - dowolny tekst (ścieżka katalogu dla STORAGE, nazwa pliku licznika dla ROTATION) albo nazwa jednego z predefiniowanych profili pamięci (dla SUBSTRAT). Dolna gałąź (reguła default_statement) to para słów kluczowych DEFAULT VOLATILE bez żadnej wartości.
Dyrektywa STORAGE wskazuje katalog plików wynikowych. Bez niej xretractor używa storage.dir z konfiguracji TOML, a dopiero gdy ten klucz również nie jest ustawiony - bieżącego katalogu procesu. Jawna dyrektywa RQL ma pierwszeństwo przed konfiguracją (patrz plik konfiguracyjny).
Substraty to zapytania oraz ich efekty, które powstają w wyniku rozkładu poleceń systemu przez kompilator na podstawie wyrażeń algebry szeregów czasowych. Są to zapytania, które widać w planie realizacji zapytań ale nie są one specyfikowane bezpośrednio w pliku .rql. Wynikają one z implementacji procesu konstrukcji planu realizacji zapytań.
Bez DEFAULT VOLATILE lub jawnego SUBSTRAT takie zapytania materializują dane na dysku w magazynie DEFAULT. Bez retencji ich pliki rosną bez ograniczenia; klucz storage.default_retention w konfiguracji TOML może ograniczyć także historię substratów. Przechowywanie wyników pośrednich na dysku bywa przydatne przy rozwoju oprogramowania, a SUBSTRAT 'memory' pozwala zachować tylko historię potrzebną planowi w ograniczonym buforze RAM.
Możliwe opcje w poleceniu SUBSTRAT to: memory, default, direct, posix, posixshd, generic (wielkość liter nie ma znaczenia). Inna wartość jest błędem kompilacji - także device i textsource, które są typami źródeł DECLARE, a nie profilami magazynu. Pełny opis każdego typu - klasa C++, obsługa retencji i shadow - znajdziesz w rozdziale Typy STORAGE.
Ostatnia dyrektywa - Rotation to dyrektywa wskazująca na odmienny tryb kończenia pracy przez system. Domyślnie po kompilacji wszystkie pliki wytworzone przez system pozostają w stanie w jakim system zarejestrował dane. Po kolejnym wywołaniu polecenia systemowego – wszystkie pliki artefaktów i substratów są usuwane. Użycie dyrektywy Rotation w pliku rql z deklaracją zapytań sprawi że system utworzy plik wymieniony w parametrze dyrektywy i umieści tam licznik zwiększany z każdym uruchomieniem systemu. Plikom z artefaktami i substratami po każdym zakończeniu pracy systemu zostanie zmieniona nazwa – dostaną rozszerzenie .old oraz numer wynikający ze wzrastającego licznika. Ten proces nazywamy rotacją artefaktów.
DEFAULT VOLATILE
DEFAULT VOLATILE
Ta dyrektywa (reguła default_statement) ustawia domyślny magazyn pamięciowy zarówno dla nazwanych wyników SELECT, jak i substratów kompilatora. Umieszcza się ją raz w nagłówku, przed DECLARE, SELECT i RULE. Jawny SUBSTRAT ma pierwszeństwo dla substratów; PERSISTENT lub jawne STORAGE przy SELECT zastępuje ustawienie domyślne dla jego wyniku. Źródła DECLARE pozostają bez zmian. Przykład i pełne zasady: VOLATILE i PERSISTENT.
Architektura systemu
Konstrukcja systemu przetwarzania danych to rozdział stricte techniczny. Przedstawię tutaj jak system został zaprojektowany, zbudowany gdzie i jak obecnie rozmieszczone są jego funkcjonalności.
System RetractorDB został zaimplementowany w języku C++ pod kontrolą systemu Linux. Kod źródłowy podlega procesowi ciągłej integracji i testowania na platformie GitHub wspieranej przez CircleCI. Kod uruchamiany i rozwijany jest lokalnie na platformie Linux WSL2. Porzuciłem rozwój i implementację systemu pod kontrolą systemu Windows. W początkowej fazie utrzymywałem taką opcję i być może w przyszłości do niej powrócę. Jednak utrzymanie zbyt wielu platform rozwojowych znacząco opóźnia proces szybkiego prototypowania i rozwoju systemu. Nadal zachowuję i utrzymuję funkcjonalność systemu na platformie Linux ARM. Kod kompiluję i testuje się pod kontrolą maszyn opartych na architekturze ARM i x86-64 pracujących w zasobach CircleCI. Raspberry PI to jedna z docelowych platform produkcyjnych systemu RetractorDB przewidziana dla potrzeb Edge IoT.
Kompilacja kodu systemu korzysta z Conan 2, CMake i Ninja. Przygotowanie narzędzi, budowanie ze źródeł i instalację gotowych pakietów opisuje Instalacja systemu. Linux pozostaje ogólnym kontraktem wdrożeniowym tej instrukcji; port Apple służy wyłącznie do rozwoju i testów, a jego ograniczenia opisano w instrukcji budowania ze źródeł.
Przegląd poruszonych w rozdziale tematów
Rozdział zbudowany jest warstwowo - od widoku ogólnego do szczegółów implementacyjnych.
-
System jako trójka współpracujących programów:
xretractorjako proces realizujący plan zapytań,xqryjako wieloinstancyjny klient danych bieżących,xtrdbjako narzędzie inspekcji plików binarnych. Na jednym hoście może działać wiele nazwanych procesówxretractor, każdy z własnym obszarem Boost IPC. Na schemacie Rys. 12 widać granicę odpowiedzialności komponentów dla jednej takiej instancji. -
Nazwy instancji, rozdzielenie obiektów IPC, rejestr
xrdbbus, globalna ochrona nazw strumieni i plików magazynu oraz reguły automatycznego kierowania poleceńxqry. Rozdział opisuje również stałą tożsamośćservice, wymianę całego planu przezxqry --reseti znaczenie trybów pokazywanych przezxqry --bus. -
Które ścieżki danych są zawsze aktywne (napływ danych → xretractor → artefakty), a które opcjonalne lub diagnostyczne. Opisano też mechanizm graceful shutdown - xretractor reaguje na sygnały
SIGINT,SIGTERMiSIGHUPkończąc bieżący cykl bez ryzyka uszkodzenia plików. -
Artefakty, substraty i efemerydy
Kluczowy podział taksonomiczny systemu. Każdy typ strumienia ma inne przeznaczenie i inną strategię składowania: artefakty materializowane na dysku jako trwały wynik, substraty to strumienie pośrednie niezbędne podczas obliczeń, efemerydy - ulotne źródła danych, których nie można ani nie warto przechowywać.
-
Czteroplikowa struktura artefaktu: plik binarny z danymi (stałej długości rekordy, brak nagłówka), deskryptor
.descopisujący schemat rekordu w gramatyce ANTLR4, plik metadanych.metaz indeksem wartości null i przerw w transmisji (kodowanie RLE), opcjonalny plik cienia.shadowdo niedestruktywnej modyfikacji historycznych rekordów. Deskryptor określa strategię składowania przez poleTYPE. -
Proces przekształcania pliku
.rqlw gotowy plan realizacji zapytania. Flaga-curuchamia tryb kompilacji bez wykonania; połączona z-d -f -sgeneruje wyjście DOT, któregraphvizzamienia w graf przepływu danych. Graf pokazuje dwie domeny: stos wyrażeń arytmetycznych (PUSH, ADD, itp.) i algebrę strumieniową. Opisano pełny zestaw flag trybu kompilacji i wykonania. -
Przetwarzanie i dystrybucja danych
Kompletny walkthrough: od przygotowania pliku danych przez uruchomienie
xretractor, przez podgląd statystyk strumieniowania (xqry -d), po wizualizację na żywo w gnuplot (xqry -s str1 -p 50,50 | gnuplot) i transmisję przez sieć za pomocąnc. Przykład łączy dwa źródła - plik tekstowy i/dev/urandom- ilustrując jak operator+w klauzuli FROM realizuje algebraiczne łączenie strumieni. -
Narzędzie
xtrdb- interaktywny inspektor plików binarnych wzorowany na stylu dbase. Polecenia.open,.desc,.list,.rlisti.metapozwalają przeglądać zawartość artefaktów bez znajomości formatu binarnego. Narzędzie służy też do weryfikacji deterministyczności: te same dane wejściowe powinny zawsze dawać identyczne wyniki.
Trzy polecenia wystarczające do uruchomienia kompletnego przepływu:
xretractor -c query.rql          # weryfikacja poprawności pliku zapytań
xretractor query.rql             # uruchomienie przetwarzania
xqry -s <strumień>               # odczyt danych bieżących
Czwarty element - xtrdb - pojawia się przy diagnostyce i testowaniu, nie w typowym przepływie produkcyjnym.
Perspektywa ogólna
System zbudowany jest w oparciu o 3 programy dostępne jako polecenia systemowe. Pierwszym jest kompilator oraz system realizujący plany zapytań. Drugim jest klient dostępu do danych bieżących, trzecim jest program umożliwiający dostęp zrzutów binarnych. Ich nazwy to kolejno:
- xretractor
- xqry
- xtrdb
Program xretractor tworzy proces wykonujący jeden niezależny plan systemu RetractorDB. Na hoście może działać wiele nazwanych instancji, każda z własnym obszarem pamięci współdzielonej. Program xqry tworzy procesy komunikujące się z wybraną instancją, a wspólna magistrala umożliwia ich wykrywanie i routing. Program xtrdb służy do analizy danych i metadanych zapisywanych w plikach bazy danych.
Poniżej przedstawiona jest na Rys. 12 schematycznie architektura systemu RetractorDB. Uwzględniono wszystkie istniejące aktualnie komponenty. Obszary ujęte w prostokątach z nagłówkami wypełnionymi poleceniami systemowymi odpowiadają istniejącym komponentom. Obszar zapisu artefaktów to symboliczna reprezentacja systemu plików.

Rys. 12 Schemat przepływu danych pomiędzy procesami RetractorDB
Na Rys. 12 widzimy procesy realizowane przez programy xretractor, xtrdb oraz xqry. Rysunek przedstawia jedną instancję wykonawczą; przy uruchomieniu wieloserwerowym blok xretractor wraz z jego IPC i klientami powtarza się dla każdej nazwy. Relacje pomiędzy instancjami opisano w rozdziale Wiele instancji i magistrala.
Proces xretractor komunikuje się z procesami xqry poprzez własny, nazwany obszar pamięci współdzielonej. W tej pamięci dla każdej subskrypcji xqry tworzona jest kolejka danych. Dane są odbierane na bieżąco przez procesy xqry. Zadaniem procesów xqry jest wysyłka danych dalej do innych systemów lub procesów. Jeśli proces xqry ginie lub jest kończony, właściwa instancja xretractor zwalnia zasoby dedykowane temu klientowi.
Oprócz kierowania danych do wysyłki poprzez pamięć współdzieloną, system RetractorDB zapisuje dane do tzw. Obszaru zapisu artefaktów. Aktualnie jest to katalog do którego zapisywane są na bieżąco efekty procesu przetwarzania strumieni danych w oparciu o plany realizacji zapytań realizowane w systemie RetractorDB.
⚠️ Ostrzeżenie
Przedstawiona na rysunku Baza danych to nie jest Relacyjna baza danych. Przez bazę danych na przedstawionym rysunku rozumiemy zbiór plików binarnych lub tekstowych, którymi zarządza RetractorDB. Dane pobierane są z urządzeń i zapisywane w rotujących lub nie plikach binarnych lub tekstowych. Dostęp do tych danych realizowany jest za pomocą narzędzia xtrdb lub w trakcie działania systemu przez proces xqry.
Plik z zapytaniami i dyrektywami RQL podaje się jako pierwszy argument polecenia uruchamiającego system. Argument ten jest opcjonalny: wywołanie xretractor bez pliku zapytań uruchamia tryb bezczynny (idle) - proces wstaje, zajmuje blokadę usługi, otwiera kanał IPC i czeka, nie budując planu ani siatki czasu. Dzięki temu jednostka systemd może wstać razem z systemem operacyjnym, zanim operator dostarczy zestaw zapytań. Wyjątkiem jest tryb --onlycompile, gdzie brak pliku pozostaje błędem - nie ma czego kompilować.
Zestaw zapytań można dostarczyć później trzema drogami. xqry -a dodaje pojedyncze SELECT, DECLARE albo RULE do aktywnego planu. xqry --reset plik.rql atomowo zastępuje cały plan bez restartu procesu i może uruchomić pierwszą epokę instancji bezczynnej. Uruchomienie xretractor plik.rql przy działającej usłudze może natomiast zweryfikować plik, zapisać go jako plan startowy i zrestartować jednostkę systemd. Pełny zestaw wraz z dyrektywami :STORAGE, :SUBSTRAT i :ROTATION przyjmują dwie ostatnie drogi.
NOTE: Tryb idle ma pokrycie w teście
service_idle(warianty z flagą--servicei ze zmiennąXRETRACTOR_SERVICE).
Wiele instancji i magistrala
Na jednym hoście może działać równocześnie wiele procesów xretractor. Każda instancja ma własną nazwę, blokadę, obszar IPC, plan i klientów. Wspólna magistrala xrdbbus rejestruje żywe instancje, umożliwia ich wyszukiwanie przez xqry i pilnuje, aby dwa plany nie przejęły zasobów, których nie mogą bezpiecznie współdzielić.

Rys. 13. Równolegle działające instancje i wspólna magistrala xrdbbus
Na Rys. 13 każda instancja kompiluje własny plan i zgłasza własny zestaw nazw strumieni w slocie magistrali; ponumerowane węzły zastępują tam nazwy, bo istotne jest tylko to, że nie powtarzają się one między instancjami. Rozłączne są nazwy obiektów, nie obszar pamięci: na Linuksie segment magistrali i obiekty IPC wszystkich instancji leżą w tym samym /dev/shm, a odróżnia je sufiks nazwy instancji - dla instancji alfa są to kolejka poleceń RetractorQueryQueue.alfa, segment odpowiedzi RetractorReply_v1.alfa i kolejka subskrypcji klienta brcdbr.alfa.<pid>. Segment odpowiedzi ma stałe sloty i atomowe stany; nie używa osobnego nazwanego muteksu mapy. Wspólny jest również katalog magazynu, w którym pliki poszczególnych instancji pozostają rozłączne.
Wyjątkiem jest tryb usługowy: w domyślnej przestrzeni hosta może działać dokładnie jedna instancja oznaczona jako usługa. Domyślnie otrzymuje ona stałą nazwę service, dzięki czemu skrypty mogą kierować polecenia do --server service bez wcześniejszego przeglądania magistrali.
Tożsamość instancji
Instancję można wskazać na trzy sposoby:
| Mechanizm | Znaczenie |
|---|---|
xretractor --name pomiary plan.rql | Stała nazwa podana przez operatora. |
xretractor --autoname plan.rql | Losowa nazwa w stylu nazw kontenerów; jest wypisywana przy starcie. |
server.autoname = true | Automatyczna nazwa ustawiona w pliku TOML, o ile nie podano --name. |
Jawne --name ma pierwszeństwo przed konfiguracją. Nazwa musi pasować do [a-z][a-z0-9_-]* i może mieć najwyżej 32 znaki. --name i --autoname wzajemnie się wykluczają.
Brak nazwy zachowuje historyczną tożsamość: nazwy obiektów IPC i pliku blokady nie mają sufiksu. Taka instancja również pojawia się w magistrali, jako (unnamed), i uczestniczy w kontroli kolizji.
Zmienna RDB_NAMESPACE wybiera osobny segment magistrali oraz, jeżeli nie podano --name ani --autoname, staje się domyślną nazwą serwera i celem xqry. Jest używana przede wszystkim przez równoległe testy integracyjne. Jawne opcje --name, --autoname i --server pozostają nadrzędne. Limit jednej usługi jest egzekwowany osobno w każdej przestrzeni magistrali. Różne wartości RDB_NAMESPACE przy tej samej jawnej nazwie serwera nie rozdzielają jednak obiektów IPC: o ich nazwach decyduje wybrana tożsamość instancji.
Przed uruchomieniem instancja zajmuje blokadę swojego pliku w katalogu paths.lock_dir (domyślnie katalogu tymczasowym) oraz dodatkową blokadę tożsamości IPC pod /tmp/xretractor_ipc.<nazwa-kolejki-poleceń>.lock. Druga lokalizacja jest stała i niezależna od TMPDIR oraz paths.lock_dir. Zajęta tożsamość IPC blokuje start przed usuwaniem artefaktów i tworzeniem IPC, również gdy magistrala jest niedostępna. Zmiana katalogu blokad lub przestrzeni magistrali nie pozwala przejąć obiektów żywego serwera.
Blokada tożsamości IPC jest plikiem w /tmp. Czyszczenie katalogu tymczasowego według wieku (systemd-tmpfiles, na macOS periodic daily) może go usunąć spod działającego serwera, a PrivateTmp=yes w jednostce daje procesom różne pliki przy wspólnym /dev/shm. Dlatego po sprawdzeniu wyłączności trybu usługowego magistrala sprawdza także tożsamość: instancja o tej samej nazwie co żywy wpis magistrali, w tym druga instancja bezimienna, dostaje odmowę is already running z kodem ENOLCK (37 na Linuksie), zanim usunie artefakty lub utworzy IPC (#565). Przy niedostępnej magistrali tożsamość chroni wyłącznie plik blokady.
Zasoby prywatne i wspólne
Nazwane instancje mają rozłączne obiekty Boost.Interprocess. Nazwy bazowe kolejki poleceń i segmentu odpowiedzi otrzymują sufiks instancji, a kolejka subskrybenta zawiera również PID klienta. Zatrzymanie jednej instancji kończy tylko jej subskrypcje i usuwa jej IPC; może również posprzątać porzucone zasoby po martwych procesach. Zasoby żywych instancji pozostają chronione.
Nowe obiekty IPC tworzone przez serwer otrzymują jawny tryb 0600, który ogranicza dostęp do konta serwera bez polegania na umask procesu. Dotyczy to kolejki poleceń, kolejek subskrypcji, segmentu odpowiedzi i segmentu magistrali. Rozłączne nazwy oddzielają zasoby współpracujących instancji, a blokady koordynują ich tworzenie i sprzątanie.
Naprawa #465 wprowadza tworzenie kolejki poleceń, kolejek subskrypcji i segmentu odpowiedzi przez create_only. Kolizja nazwy nie prowadzi do przejęcia istniejącego obiektu. Przy otwieraniu kolejki lub segmentu serwer i klient wymagają właściciela zgodnego ze swoim efektywnym UID (geteuid()) oraz dokładnego trybu 0600. Oczekiwany UID pochodzi z uprawnień procesu, nie z metadanych otwieranego obiektu. Przed mapowaniem sprawdzane są również typ obiektu, pojedyncze dowiązanie, zgodność nazwy z otwartym obiektem i ochrona katalogów przed podmianą wpisów przez inne konto.
Przy starcie lub restarcie serwer może usunąć pozostałości własnego konta po zajęciu blokady tożsamości IPC; stare szersze uprawnienia takiego obiektu nie wykluczają jego sprzątnięcia. Ponowna subskrypcja usuwa własną poprzednią kolejkę i tworzy nową o żądanej pojemności. Sprzątanie odmawia usunięcia obiektu innego UID, także gdy wykonuje je root. Porzucone blokady innych kont są pomijane, a blokady tożsamości i obecności nadal chronią zasoby żywych instancji. Sprzątacz nie usuwa też obiektów IPC instancji, która ma żywy slot w magistrali bieżącej przestrzeni RDB_NAMESPACE, nawet gdy jej plik blokady tożsamości zniknął. Sprzątacz pozostałości nie wyszukuje wszystkich kolejek subskrypcji po SIGKILL.
Odmowa jest logowana na poziomie ERROR, także w Release, z nazwą obiektu, powodem oraz UID właściciela, jeżeli można go ustalić. Obca kolejka poleceń lub obcy segment odpowiedzi powoduje odmowę startu; obca kolejka subskrypcji powoduje odmowę tej subskrypcji. Magistrala może otworzyć istniejący segment dopiero po tej samej weryfikacji, a odrzucony segment pozostaje nietknięty. Jej niedostępność zachowuje opisany poniżej tryb awaryjny pojedynczego serwera.
⚠️ Ostrzeżenie
xqrymusi działać z tym samym efektywnym UID co serwer. Dotyczy to również administratora: samo uruchomienie klienta jako root nie uprawnia go do otwarcia IPC usługi należącej do innego konta. Dla usługi działającej jakoretractorużyj na przykładsudo -u retractor xqry --server service --dir. Współdzielenie magistrali wymaga tego samego UID; nazwa instancji aniRDB_NAMESPACEnie zastępują kontroli właściciela. Dopuszczenie regułSYSTEMw wymienianym planie nadal zależy odservice.unrestricted(zobacz xqry).
Magistrala jest wspólna dla hosta lub przestrzeni RDB_NAMESPACE. Każdy żywy serwer publikuje w niej nazwę, PID, tryby pracy, plik planu i nazwy strumieni. Gdy wpis procesu jest czytelny, slot pozostaje żywy przy zgodnym PID i niezerowym czasie startu; proces zombie nie blokuje zasobów. Na Linuksie silnik czyta /proc/<pid>/task/<pid>/stat, a na macOS korzysta z adaptera systemowego.
Nieczytelny wpis procesu oznacza brak możliwości rozstrzygnięcia, a nie potwierdzenie śmierci właściciela. Na Linuksie nieudany odczyt potwierdza brak procesu dopiero wtedy, gdy kill(pid, 0) zwraca ESRCH; sukces lub EPERM pozostawia wynik niepewny. bus::isProcessAlive() zachowuje wtedy slot i jego roszczenia, również gdy nie może porównać czasu startu. Chroni to właściciela ukrytego przez hidepid lub ProtectProc, lecz może utrzymywać stare roszczenia po ponownym użyciu PID. Sam brak dostępu do wpisu nie uprawnia więc do zwolnienia zasobów. Regułę sprawdza ut_bus::BusFixture.UnreadableOwnerKeepsSlot.
Bieżąca wersja układu używa segmentu xrdbbus_v7, a przy ustawionym RDB_NAMESPACE segmentu xrdbbus_v7_<RDB_NAMESPACE>. Każda przestrzeń ma osobny rejestr i osobną kontrolę kolizji. Użytkownicy segmentu utrzymują blokadę obecności flock na pliku /tmp/<segment>.lock. Ostatni wychodzący, a po awarii sprzątacz, usuwa segment tylko wtedy, gdy zajmie wyłączną blokadę obecności i żaden slot nie należy do żywej instancji. Drugi warunek chroni serwer, którego plik obecności usunęło czyszczenie katalogu tymczasowego albo który pracuje w innym PrivateTmp: krótkotrwały xqry --bus nie usuwa wtedy jego segmentu, a kolejna instancja widzi jego roszczenia zamiast zakładać drugi segment. Tej ochrony nie mają procesy mapujące segment bez slotu (klienci) ani serwer w krótkim oknie przed zajęciem slotu. xqry --bus nie pokazuje przestrzeni, której plik obecności zniknął, do następnego podłączenia uczestnika. Wersje układu mają osobne rejestry: równoczesne uruchomienie binariów v6 i v7 nie zapewnia między nimi kontroli kolizji strumieni i magazynów. Przed aktualizacją należy zakończyć starsze instancje.
Zajmowanie współdzielonej blokady obecności ponawia nieblokujące próby flock przez okres do 500 ms. Przejściowy właściciel blokady wyłącznej może ją w tym czasie zwolnić; jeśli nadal ją trzyma, magistrala pozostaje niedostępna zamiast bezterminowo blokować jej dołączenie. Ten termin dotyczy oczekiwania na flock, nie całej procedury otwierania pliku. Osobna pętla otwarcia lub utworzenia ma limit 100 prób. Blokady obecności i tożsamości IPC wymagają zwykłego pliku bez podążania za dowiązaniem; ponieważ są otwierane tylko do odczytu, nie wymagają właściciela zgodnego z UID czytelnika. Zapisywana blokada instancji dodatkowo wymaga tego samego UID i jednego dowiązania - zobacz warunki startu.
Przed uruchomieniem albo wymianą planu magistrala sprawdza rozłączność:
- nazw wszystkich strumieni, również wygenerowanych przez kompilator i dodanych ad hoc;
- znormalizowanych ścieżek zapisywanych plików magazynu;
- pliku licznika dyrektywy
:ROTATION.
Roszczenie następuje przed usuwaniem starych artefaktów i zakładaniem IPC. Przegrana instancja nie może więc skasować danych działającego właściciela. Komunikat odmowy podaje kolidujący zasób, nazwę instancji i jej PID.
Przy xqry --reset zasoby nowego planu są najpierw rezerwowane. Na granicy slotu stary model jest rozbierany, plan wymieniany, a rezerwacja zastępuje aktywny zestaw zasobów magistrali. Model nowej epoki powstaje dopiero po tej aktywacji; polecenia wymagające modelu czekają na jego publikację. Błąd parsowania, kompilacji, limitu lub kolizja wykryta przed przyjęciem resetu pozostawia dotychczasowy plan i jego roszczenia bez zmian.
Nieodwracalny błąd muteksu magistrali ENOTRECOVERABLE jest raportowany na poziomie ERROR, także w Release, raz na obiekt Bus. Komunikat wskazuje segment /dev/shm do usunięcia po zakończeniu wszystkich instancji, które go mapują. Usunięcie segmentu używanego przez działającą instancję może rozdzielić rejestr zasobów. Start i import ad hoc zachowują tryb awaryjny opisany poniżej; przy resecie niesprawny muteks dołączonej magistrali powoduje odmowę na etapie rezerwacji, zanim klient otrzyma potwierdzenie przyjęcia.
Jeżeli blokada magistrali zawiedzie dopiero przy aktywacji po przyjęciu resetu, stary model jest już rozebrany. Serwer kontynuuje nowym planem w trybie awaryjnym, bez publikacji nowego zestawu zasobów i bez egzekwowania ich rozłączności. Slot magistrali może nadal pokazywać nazwy starego planu, więc routing według niego nie jest wtedy wiarygodny. Brak wymaganej rezerwacji lub slotu jest odrębnym naruszeniem niezmiennika i kończy proces przez FatalError. Reset nie daje pełnej gwarancji wycofania awarii po przyjęciu.
⚠️ Ostrzeżenie
Niedostępność lub uszkodzenie magistrali nie zatrzymuje pojedynczego serwera, o ile może on zająć blokady instancji i tożsamości IPC. Start jest dopuszczany z ostrzeżeniem, ale globalna ochrona nazw strumieni i ścieżek magazynu nie jest wtedy egzekwowana. Blokada tożsamości IPC nadal obowiązuje. To tryb awaryjny, a nie poprawna konfiguracja wieloserwerowa.
Routing poleceń xqry
xqry rozstrzyga cel na podstawie jednej migawki magistrali bieżącej przestrzeni RDB_NAMESPACE, bez odpytywania kolejnych serwerów i bez czekania na ich timeouty. Zbiorczy przegląd --bus nie rozszerza zasięgu routingu pozostałych poleceń.
| Sytuacja | Wynik |
|---|---|
Podano --server nazwa | Wskazana instancja jest używana bez automatycznego routingu. |
| Działa dokładnie jedna instancja | Klient wybiera ją automatycznie. |
Kilka instancji, --select lub --detail | Wybierany jest właściciel strumienia. |
Kilka instancji, ad hoc SELECT | Wszystkie źródła muszą należeć do jednej instancji. |
Kilka instancji, ad hoc RULE | Celem jest właściciel strumienia z klauzuli ON. |
Kilka instancji, ad hoc DECLARE | Trzeba podać --server, bo deklaracja nie ma właściciela wejścia. |
| Kilka instancji, polecenie całej instancji | --hello, --dir, --kill i --reset wymagają --server. |
Zapytanie ad hoc nie może łączyć źródeł z różnych instancji. RetractorDB nie przesyła strumieni pomiędzy serwerami; plany są niezależnymi grafami wykonania.
Przegląd magistrali
Polecenie xqry --bus nie kontaktuje się z żadnym serwerem. Bez ustawiania RDB_NAMESPACE wykrywa wszystkie dostępne dla bieżącego konta magistrale bieżącej wersji, które mają żywe instancje. Dla każdej wypisuje osobną sekcję NAMESPACE: z nazwami instancji, PID, trybem, plikiem zapytań i strumieniami; (default) oznacza magistralę bez przestrzeni nazw. Modyfikator --yaml daje jeden dokument apiVersion: xqry/v1 z listą servers; każdy wpis ma pole namespace, równe null dla magistrali domyślnej albo cytowanej nazwie przestrzeni. Gdy nie ma żywych instancji, tabela jest pusta, a YAML zawiera servers: [].
Kolumna MODE może zawierać kilka liter:
| Litera | Tryb |
|---|---|
N | zwykłe wykonanie taktowane zegarem |
R | --realtime |
F | --no-clock |
U | --until-eof |
M | ustawiony limit --llimitqry |
X | --xqrywait |
S | tryb usługowy lub jednostka systemd |
Przykładowa sesja:
xretractor alfa.rql --name alfa --noanykey &
xretractor beta.rql --name beta --noanykey &

xqry --bus
xqry --select temperatura          # routing według właściciela strumienia
xqry --server alfa --dir           # jawne polecenie całej instancji
xqry --server beta --kill          # zatrzymuje tylko instancję beta
Przepływ danych i sterowania
Dane i sterowanie w systemie RetractorDB tworzą kilka potencjalnych sposobów użycia komponentów systemu. Na Rys. 14 przedstawiono schematycznie przepływ danych pomiędzy procesami systemu RetractorDB, procesami systemu Linux oraz danymi źródłowymi i rezultatami pracy poszczególnych procesów.
Najgrubsze linie przedstawiają przepływ, który występuje zawsze w procesie przetwarzania regularnych serii czasowych. Po otrzymaniu pliku .rql proces xretractor kompiluje go, buduje drzewo planu i rozpoczyna przetwarzanie napływających danych oraz tworzenie plików binarnych zawierających artefakty. Bez pliku może uruchomić się w stanie bezczynnym i czekać na pełny plan przesłany przez xqry --reset.
NOTE: Opisana funkcjonalność ma pokrycie w teście:
consistencyopisanym w załączniku pt. Testy Integracyjne.
Aby móc sterować procesem xretractor po wystartowaniu używamy procesu xqry. Za jego pomocą możemy zatrzymać proces xretractor, pobrać statystyki lub zażądać dostępu do danych bieżących.
Reszta strzałek prezentuje przepływy danych zależne od prowadzonego z użyciem RetractorDB procesu. Strzałki przerywane są typowo przeznaczone do celów diagnostycznych.
Każdy z procesów na schemacie został oznaczony dodatkowo liczbą utrzymywanych ciągłych procesów w systemie. Historyczne oznaczenie „1” przy xretractor opisuje jedną instancję planu przedstawioną na rysunku, a nie współczesny limit całego hosta. Nazwane instancje mogą działać równocześnie; w domyślnej przestrzeni hosta dokładnie jedna może pracować jako usługa. Magistrala xrdbbus egzekwuje rozłączność ich zasobów. Program xtrdb nie utrzymuje ciągłego procesu: czyta dane, zwraca wynik i kończy pracę, ewentualnie działa interaktywnie. Proces xqry oznaczony jest jako „N”, ponieważ do każdej instancji xretractor może być podłączonych wielu klientów.

Rys. 14. Przepływ danych i sterowania
Zatrzymanie xretractor
Proces xretractor obsługuje sygnały systemowe i kończy pracę w kontrolowany sposób po otrzymaniu:
| Sygnał | Polecenie | Znaczenie |
|---|---|---|
SIGINT | Ctrl+C w terminalu | przerwanie interaktywne |
SIGTERM | kill <pid> | standardowe zakończenie procesu |
SIGHUP | kill -HUP <pid> | zakończenie przy zamknięciu terminala |
Wszystkie trzy sygnały powodują ten sam efekt: graceful shutdown - pętla przetwarzania kończy bieżący cykl i zatrzymuje się. Sygnał, który zastanie pętlę w oczekiwaniu na termin kolejnego slotu, kończy ją od razu, a slot, którego termin jeszcze nie nadszedł, nie jest już liczony (patrz Harmonogram slotów). Pozwala to bezpiecznie zamknąć xretractor działającego jako usługa bez ryzyka uszkodzenia plików artefaktów.
Zatrzymanie przez xqry
Obok sygnałów systemowych xretractor można zatrzymać programowo - za pomocą polecenia:
xqry --server nazwa --kill
Jak przebiega zamknięcie krok po kroku
1. xqry wysyła żądanie „kill“
Proces xqry rozstrzyga instancję z opcji --server albo z magistrali, buduje komunikat IPC i umieszcza go w jej kolejce poleceń. Nazwa bazowa RetractorQueryQueue otrzymuje sufiks nazwanej instancji. Wiadomość zawiera identyfikator procesu xqry (PID) i polecenie kill.
2. xretractor odbiera polecenie i ustawia flagę zatrzymania
Wątek komunikacyjny obiektu IpcServer wybranej instancji stale nasłuchuje na swojej kolejce. Dyspozytor executorsm::commandProcessor po odebraniu komunikatu kill ustawia atomowy licznik iLoopLimitCnt na wartość stop_now i budzi pętlę wykonawczą. Ten sam mechanizm jest używany przez obsługę sygnałów systemowych - niezależnie od źródła efekt jest identyczny dla tej jednej instancji.
3. Główna pętla przetwarzania wykrywa flagę i kończy bieżący cykl
Pętla główna sprawdza iLoopLimitCnt przy każdej iteracji. Gdy wykryje wartość stop_now, kończy bieżący cykl i wychodzi z pętli - bez przerywania w połowie obliczeń. Zapewnia to integralność zapisywanych artefaktów.
4. xretractor próbuje powiadomić podłączonych klientów (broadcast OOB)
Po wyjściu z pętli xretractor wywołuje IpcServer::broadcastOutOfBusiness(). Obiekt IPC przegląda rejestr subskrypcji, w którym polecenie show zapisało PID klienta i nazwę strumienia. Dla każdego klienta podejmuje jedną nieblokującą próbę wysłania komunikatu OUT_OF_BUSSINESS. Pełna lub uszkodzona kolejka może nie otrzymać znacznika. Niezależnie od wyniku próby serwer usuwa nazwę kolejki i wpis subskrypcji; zamknięcie nie czeka na potwierdzenie odbioru.
5. Klient xqry kończy działanie po znaczniku lub po upływie limitu ciszy
Każda subskrypcja xqry ma własną kolejkę zawierającą nazwę serwera i PID klienta. Po odebraniu komunikatu OUT_OF_BUSSINESS xqry ustawia wewnętrzną flagę done i kończy działanie w kontrolowany sposób. Jeśli znacznik nie dotarł, klient może zakończyć się dopiero po upływie skonfigurowanego limitu braku danych. Odbiorca nie może traktować dostarczenia znacznika jako gwarancji zamknięcia.
6. Sprzątanie zasobów IPC
Na zakończenie xretractor usuwa własny segment odpowiedzi, kolejkę poleceń, muteks i kolejki swoich klientów oraz zwalnia slot magistrali i blokady. Właściciel usuwa pliki blokad przed ich zwolnieniem. Dodatkowe sprzątanie przy wyjściu usuwa dostępne porzucone zasoby martwych instancji; zasoby żywych procesów pozostają nietknięte. Ostatni użytkownik segmentu magistrali może go usunąć po uzyskaniu wyłącznej blokady obecności.
Po SIGKILL procedury wyjścia nie działają i zasoby mogą pozostać. Polecenie xretractor --cleanup pozwala posprzątać rozpoznane pozostałości bez uruchamiania planu. Jego zakres, ograniczenia i liczniki opisano w opcjach xretractor. Nie usuwa ono kolejek odpowiedzi klientów ani segmentów starszych wersji magistrali.
Błąd krytyczny i sprzątanie awaryjne
Błąd krytyczny podczas startu albo w wątku komunikacyjnym przechodzi przez tę samą końcową politykę własności zasobów, ale nie próbuje kontynuować cyklu. Dziennik spdlog jest opróżniany, a nie niszczony przed procedurami atexit. Jeżeli błąd powstał w samym wątku komunikacyjnym, sprzątanie odłącza ten wątek zamiast próbować dołączyć go do niego samego. Następnie usuwa kolejki i pamięć IPC, a blokadę usługi zwalnia jako ostatnią.
Proces kończy się statusem 1. Dzięki temu kolejny start nie zastaje osieroconych zasobów ani blokady, a błąd pierwotny nie jest maskowany wtórnym SIGSEGV lub SIGABRT podczas zamykania.
NOTE: Obie ścieżki - błąd podczas startu i błąd zgłoszony z wątku komunikacyjnego - sprawdza test
fatal_exit_path.
Co się dzieje przy wielu procesach xqry
RetractorDB jest zaprojektowany do pracy z wieloma równoległymi klientami. Gdy w systemie działają jednocześnie - powiedzmy - trzy procesy xqry subskrybujące różne strumienie, a jeden z nich wywoła xqry --kill:
- wskazany xretractor przetworzy żądanie kill jednorazowo, niezależnie od tego, który klient je wysłał,
- mechanizm
IpcServer::broadcastOutOfBusiness()podejmie próbę wysłaniaOUT_OF_BUSSINESSdo każdej zarejestrowanej subskrypcji tej instancji, - klient, który odbierze znacznik, zakończy działanie; pozostali klienci mogą czekać do upływu limitu ciszy,
- klienci, którzy nie subskrybowali żadnego strumienia (np. xqry wywołany tylko z
--dirlub--hello), nie są wpisani do mapy i nie muszą być powiadamiani - te polecenia kończą działanie natychmiast po udzieleniu odpowiedzi.
Klienci podłączeni do innych nazwanych instancji nie otrzymują tego komunikatu i pracują dalej.
Limit ciszy klienta określa timing.query_no_data_timeout_ms w konfiguracji TOML; domyślnie wynosi 10000 ms. Chroni również przed czekaniem bez końca po awarii serwera lub utracie znacznika OOB podczas zwykłego zamknięcia. Pełny kontrakt odbioru opisują opcje xqry.
Artefakty, Substraty, Efemerydy
Z racji faktu, że system przeznaczony jest do pracy ciągłej i teoretycznie otrzymywane wyniki bez prowadzenia procesu retencji danych zapełniłby każdy nośnik danych wprowadzamy dodatkowe definicje związane z charakterem przetwarzanych danych.
Przedstawiając opis Rys. 14 wspominano o artefaktach. Jest to jedna z definicji wymagających wyjaśnienia.
✅ Uwaga
Definicja (Artefakt): Przez artefakty rozumiemy dane przetwarzane w systemie w postaci strumieni, które docelowo zostają zmaterializowane jako utrwalony wynik i efekt przetwarzania innych danych.
Ciągłe serie czasowe możemy czytać z urządzeń, następnie je przetwarzać – redukować lub dopasowywać rozmiar danych w czasie i wymiarze. Ale z reguły pewne dane powinny zostać zapisane. Czy te dane potem będą podlegać retencji – jest sprawą drugorzędną. Takie dane, które stanowią efekt i oczekiwaną odpowiedź systemu będziemy nazywać artefaktami. Czymś co oczekujemy i materializujemy dla potrzeb użytkownika końcowego.
✅ Uwaga
Definicja (Substrat): Substraty to obiekty pośrednie. W wyniku przetwarzania serii czasowych mogą powstać strumienie danych, które są ulotne. Potrzebne jedynie do i w trakcie przetwarzania.
Ich rozmiar może być znaczący biorąc pod uwagę jak daleko cofamy się wstecz w przypadku np. konieczności zrzutów danych monitorowania z przeszłości. Jednak ich istnienie jest bez znaczenia w aspekcie pożądanych wyników działania systemu. Takie strumienie danych nazywamy substratami. Pojawiają się w wyniku działania systemu, nie występują z reguły jawnie w zapytaniach – ale wynikają z procesu przetwarzania serii czasowych, jednak ich wyniki są niezbędne do realizacji zadania.
✅ Uwaga
Definicja (Efemeryd): Efemerydy to obiekty, w oparciu o które tworzymy źródłowe strumienie danych, danych których nie można zmagazynować. Są to z reguły dane ulotne, efemeryczne.
System czyta np. liczby przypadkowe z odpowiednią częstotliwością i to właśnie źródło danych dostarcza danych ulotnych. Nie można ich zwrócić, przechowywanie ich z reguły mija się z celem – należy je przekazać do dalszego przetwarzania w celu wytworzenia artefaktów lub substratów a następnie zniszczyć i pobrać, nowe aktualne.
Format zapisu danych
W systemie przetwarzane są serie czasowe w trzech postaciach: artefaktów, efemerydów i substratów. Każdy typ ma inne przeznaczenie i inną strategię przechowywania.
Substraty i Artefakty - formalnie niczym nie różnią się w systemie. Jedyna różnica to fakt, że substraty zostały wygenerowane w oparciu o równiania algebry strumieni danych i nie zostały zapisane bezpośrednio w ciągu poleceń dla kompilatora. Jeśli zadeklarujemy strumień Artefaktu, który pokryje postać substratu - substrat zostanie zredukowany. Efemerydy to strumienie, które powstały za pomocą polecenia Declare - zawierają wartości które istnieją tylko przez chwilkę.
Typy akcesorów składowania
NOTE: Opisana funkcjonalność ma pokrycie w teście:
txtsrcopisanym w załączniku pt. Testy Integracyjne.
Pole TYPE w deskryptorze (lub dyrektywa STORAGE w RQL) wybiera implementację FileInterface:
Typ (TYPE_PROFILE) | Klasa implementacji | Zastosowanie |
|---|---|---|
DEFAULT | groupFile<posixBinaryFileWithShadow> | Artefakty domyślne - plik danych + plik cienia, z retencją |
DIRECT | groupFile<posixBinaryFile> | Zapis bezpośredni bez cienia, z retencją |
POSIX | posixBinaryFile | Surowy zapis POSIX bez cienia |
POSIXSHD | posixBinaryFileWithShadow | POSIX z plikiem cienia |
MEMORY | memoryFile | Składowanie wyłącznie w RAM (efemerydy) |
GENERIC | genericBinaryFile | Ogólny akcesor binarny |
BINFILE | binaryDeviceRO | Zwykły plik binarny danych wejściowych, DECLARE ... BINFILE (tylko odczyt) |
DEVICE | binaryDeviceRO | Urządzenie znakowe albo FIFO, DECLARE ... DEVICE (tylko odczyt) |
TEXTSOURCE | textSourceRO | Tekstowe źródło danych wejściowych, DECLARE ... TEXTFILE (tylko odczyt) |
Zestaw plików artefaktu i substratu
Artefakty i substraty zapisywane na dysk mogą być skojarzone z maksymalnie pięcioma plikami:
| Plik | Rozszerzenie | Cel |
|---|---|---|
| Plik danych binarnych | (nazwa strumienia) | Główny strumień rekordów - append-only |
| Plik deskryptora | .desc | Schemat rekordu (pola, typy, rozmiary, typ składowania) |
| Plik metadanych | .meta | Indeks wartości null i przerw w transmisji (RLE) |
| Plik cienia danych | .shadow | Modyfikacje rekordów bez nadpisywania danych oryginalnych |
| Plik cienia indeksu | .meta.shadow | Nadpisania wzorców null towarzyszące .shadow |
%% pdf-width: 50%
%% pdf-height: 70%
graph TD
  D[".desc: deskryptor (schemat rekordu)"]
  B["Plik danych binarnych (rekordy N×R bajtów)"]
  M[".meta: metadane (indeks null i przerw)"]
  S[".shadow: plik cienia danych (modyfikacje rekordów)"]
  MS[".meta.shadow: cień indeksu (nadpisania null)"]

    D -->|"opisuje strukturę"| B
    B -->|"towarzyszący indeks"| M
    B -->|"opcjonalne nadpisania"| S
    S -.->|"para spójności"| MS
    M -->|"nadpisania wzorców"| MS

    style S fill:#f9c,color:#000
    style MS fill:#f9c,color:#000
    style M fill:#cdf,color:#000
Rys. 15. Zestaw plików artefaktu i ich powiązania
Diagram na Rys. 15 przedstawia statyczną relację między plikami artefaktu: .desc definiuje strukturę rekordu, .meta indeksuje null i przerwy, .shadow przechowuje opcjonalne nadpisania rekordów, a .meta.shadow - odpowiadające im nadpisania wzorców null. Dwa pliki cienia zawsze idą w parze.
Pliki cienia i plik metadanych są opcjonalne. Przy ciągłym napływie danych bez przerw i bez modyfikacji wystarczy sam plik danych binarnych i deskryptor.
Efemerydy nie mają własnego pliku danych - ich źródłem jest obiekt zewnętrzny (plik tekstowy, urządzenie), którego system nie tworzy ani nie usuwa. Powstaje dla nich natomiast deskryptor .desc opisujący schemat odczytu. Indeks .meta nie powstaje: dla źródeł deklarowanych wstrzykiwany jest inertny wariant indeksu metadanych, działający wyłącznie w pamięci.
Plik zrzutu tworzony przez regułę DO DUMP do tego zestawu nie należy, choć rekordy ma w tym samym układzie. Nie towarzyszy mu ani .desc, ani .meta, ani żaden nagłówek, więc niesie same wartości: informacja o NULL i o przerwie w transmisji zostaje wewnątrz silnika i do zrzutu nie dociera. Kontrakt zrzutu opisuje Realizacja alarmowania.
Rozdziały
- Pliki artefaktu - deskryptor, dane binarne, metadane, plik cienia i relacje między nimi
- Mechanizm rotacji plików - dyrektywa
ROTATION, cykl życia plików, przykłady sesji - Narzędzie inspekcji
xtrdb -s- mapa składowania, sekcje raportu, przykłady - Podsumowanie - uzasadnienie przyjętej struktury, porównanie podejść
Pliki
Rozdział opisuje pięć plików tworzących kompletny zestaw artefaktu lub substratu: deskryptor schematu (.desc), główny plik danych binarnych, indeks metadanych (.meta), plik cienia danych (.shadow) i plik cienia indeksu (.meta.shadow). Dla każdego pliku przedstawiono format binarny, semantykę pól oraz reguły zapisu i odczytu. Rozdział obejmuje też klasę metaData - mechanizm kompresji RLE, obsługę przerw w transmisji, interfejs aktualizacji i persystencję po restarcie. Sekcja końcowa pokazuje relacje między wszystkimi plikami na poziomie operacji append, update i read.
Zakres rozdziału nie obejmuje mechanizmu rotacji plików między sesjami (→ Rotacja) ani narzędzia inspekcji xtrdb -s (→ Narzędzie inspekcji).
Otwieranie plików i dowiązania
Pliki magazynu - dane, .shadow, .meta, .meta.shadow i .desc - są otwierane z O_NOFOLLOW: dowiązanie symboliczne pod końcową nazwą pliku powoduje odmowę otwarcia zamiast zapisu lub obcięcia jego celu. W profilu GENERIC odmowa może nastąpić dopiero przy pierwszym zapisie. Niedostępny indeks metadanych może wyłączyć jego persystencję bez zatrzymania strumienia; odmowa otwarcia dowiązania nie oznacza więc zawsze odmowy całego planu.
Wyjątek dotyczy głównego pliku danych wskazanego przez jawny REF przekazany przez wywołującego (plan lub schemat w xtrdb). Taki wybór operatora może zezwolić na końcowe dowiązanie danych. Sam REF odczytany z istniejącego .desc nie daje tego uprawnienia, podobnie jak dopuszczenie katalogu przez storage.ref_dirs. Wyjątek nie obejmuje plików pomocniczych ani nazw segmentów retencji tworzonych przez silnik.
O_NOFOLLOW sprawdza tylko ostatni komponent ścieżki. Katalog magazynu i jego przodkowie nadal mogą być dowiązaniami; podmiana katalogu nadrzędnego w trakcie rozwiązywania ścieżki pozostaje poza tą gwarancją. ut_rdb sprawdza odmowy i dozwolone przypadki kontrolne. Pliki DUMP mają odrębną politykę usunięcia końcowego wpisu i utworzenia nowego pliku na wyłączność - zobacz Realizacja alarmowania.
Plik deskryptora (.desc)
Plik .desc opisuje strukturę rekordu. Jest parsowany przez gramatykę ANTLR4 (DESC.g4) i może zawierać pola danych, metainformację o typie składowania oraz politykę retencji.
Składnia
{ <polecenie>* }
Każde polecenie to jedno z poniższych:
BYTE     nazwa [N]          # tablica N bajtów (domyślnie N=1)
INTEGER  nazwa [N]          # 32-bitowe liczby całkowite ze znakiem
UINT     nazwa [N]          # 32-bitowe bez znaku
FLOAT    nazwa [N]          # 32-bitowe zmiennoprzecinkowe (IEEE 754)
DOUBLE   nazwa [N]          # 64-bitowe zmiennoprzecinkowe
RATIONAL nazwa [N]          # para int32: licznik i mianownik
STRING   nazwa [rozmiar]    # ciąg znaków o stałej długości
REF      "ścieżka/plik"     # plik danych (ścieżki względne liczone od katalogu procesu)
TYPE     identyfikator      # typ składowania (DEFAULT, MEMORY, POSIXSHD, …)
RETENTION pojemność segment # retencja cykliczna na dysku
RETMEMORY pojemność         # retencja cykliczna w pamięci
Przykłady plików .desc
Artefakt domyślny - dwa pola numeryczne, składowanie DEFAULT (plik danych + plik cienia):
{
  INTEGER  ts
  FLOAT    value
  TYPE     DEFAULT
}
Wynik SELECT lub substrat w RAM - magazyn MEMORY z pierścieniem jednego rekordu (źródła efemeryczne DECLARE mają typ BINFILE, TEXTSOURCE albo DEVICE):
{
  DOUBLE   x
  DOUBLE   y
  TYPE     MEMORY
  RETMEMORY 1
}
Substrat z retencją - do 1000 rekordów na dysku (10 segmentów po 100):
{
  INTEGER  ts
  FLOAT    a
  FLOAT    b
  TYPE     DEFAULT
  RETENTION 100 10
}
Deklaracja źródła binarnego (DECLARE w RQL generuje ten schemat):
{
  INTEGER  a
  FLOAT    b
  TYPE     BINFILE
  REF      "sensor/data.bin"
}
Rozmiary typów pól
| Typ | Rozmiar pojedynczej wartości |
|---|---|
BYTE | 1 B |
INTEGER | 4 B |
UINT | 4 B |
FLOAT | 4 B |
DOUBLE | 8 B |
RATIONAL | 8 B (dwa int32) |
STRING | N B (deklarowany rozmiar) |
Dla pól tablicowych nazwa[N] całkowity rozmiar = rozmiar_typu × N. Pola TYPE, REF, RETENTION i RETMEMORY nie zajmują miejsca w rekordzie - są metadanymi deskryptora.
Rozmiar rekordu R = suma rozmiarów wszystkich pól danych.
Układ pola RATIONAL
Pole RATIONAL przechowuje liczbę wymierną jako parę liczb całkowitych ze znakiem, zapisaną w rekordzie wprost, bez nagłówka i bez znacznika typu:
offset +0   int32   licznik
offset +4   int32   mianownik
Kolejność bajtów jest natywna dla maszyny - na x86-64 i ARM64 little-endian, tak samo jak dla pól INTEGER i UINT. Pole zajmuje 8 bajtów; dla pola tablicowego RATIONAL nazwa[N] pary leżą jedna za drugą, 8 × N bajtów.
Wartość jest zawsze zapisana w postaci nieskracalnej, a mianownik jest zawsze dodatni - znak liczby niesie wyłącznie licznik. Wynika to z arytmetyki boost::rational, która normalizuje wynik przy każdym przypisaniu, a nie z konwencji zapisu. W szczególności:
- zero zapisuje się jako
0/1, nigdy jako0/0ani0/5; - liczba całkowita zapisuje się jako
n/1- poleRATIONALo mianowniku 1 to dokładnie liczba całkowita, bez zaokrągleń (na tym niezmienniku opiera się też test podzielności slotu w algorytmie przeglądu drzewa zapytań); - mianownik nigdy nie jest zerem - żadna droga zapisu w systemie takiej pary nie produkuje.
Niezmiennik opisuje jednak zapis, a nie każdy plik, który silnikowi można podstawić. Od 23 września 2026 odczyt sprawdza go na granicy bajty–wartość: para, której mianownik jest mniejszy lub równy zeru, daje NULL, a nie liczbę wymierną. Obejmuje to wyzerowany rekord (0/0), mianownik równy INT_MIN i parę INT_MIN/-1, czyli dokładnie te bajty, na których poprzednia wersja kończyła przerwaniem procesu przez SIGFPE. Para z dodatnim mianownikiem przechodzi też przez normalizację, więc zapis skracalny wraca skrócony (2/4 jako 1/2). Para 1/-2 daje NULL, ponieważ jej mianownik jest ujemny. Dla pliku zapisanego przez system nie zmienia to nic - takich par nie ma w nim żadna.
Pola typu RATIONAL produkują reduktory MIN, MAX, AVG i SUMC, gdy wartość wejściowa ma typ BYTE, INTEGER, UINT albo RATIONAL. Dotyczy to reduktorów bieżącego rekordu w FROM, wygaszanej notacji .min/.max/.avg/.sumc oraz agregatów historii AGG(wyrażenie : W) w liście SELECT. Wejście FLOAT lub DOUBLE zachowuje własny typ (→ Operatory agregujące). Reduktor nad wejściem całkowitym lub wymiernym jest w praktyce głównym źródłem typu RATIONAL w artefakcie.
Przykład zmierzony
Plan liczący średnią z okna trzech próbek:
DECLARE v INTEGER STREAM src, 1 TEXTFILE 'data.txt'

SELECT * STREAM ravg FROM AVG(src@(1,3))
dla wejścia -3, -3, -2, 7, 7, 7, … daje deskryptor { RATIONAL avg } i plik danych, w którym pierwszy rekord ma osiem bajtów:
f8 ff ff ff   03 00 00 00
└─ licznik ─┘ └ mianownik ┘
   -8            3            →  -8/3
Czwarty rekord to 07 00 00 00 01 00 00 00, czyli 7/1 - średnia z trzech siódemek zapisana jako liczba wymierna o mianowniku 1, a nie jako INTEGER.
Odczyt bez rozbierania bajtów
Układ pary trzeba znać tylko przy czytaniu pliku binarnego wprost. Sam fakt, że pole jest typu RATIONAL i zajmuje 8 bajtów, wypisuje xtrdb -s nazwa z deskryptora (→ Narzędzie inspekcji) - narzędzie pokazuje strukturę, nie wartości. Wartość odczytuje się natomiast, przepuszczając pole przez konwersję już w zapytaniu; trzy funkcje dają trzy różne kompromisy:
| Zapis w SELECT | Wynik dla -8/3 | Uwaga |
|---|---|---|
to_string(pole : N) | napis -8/3 w polu STRING[N] | postać dokładna; liczba całkowita wychodzi jako 7/1, nie 7 |
to_double(pole) | pole DOUBLE o wartości -2.6666… | przybliżenie, ale bez utraty znaku i rzędu wielkości |
to_integer(pole) | pole INTEGER o wartości -2 | obcięcie w stronę zera, nie podłoga - → Wyrażenia pól i funkcje skalarne |
Do eksportu do systemów tekstowych właściwe jest to_string, bo zachowuje wartość dokładnie; to_integer jest wygodne, ale gubi część ułamkową i robi to inaczej, niż podłoguje Python - opis zaokrąglenia jest przy funkcjach wyrażeń.
Pole TYPE a strategia składowania
Pole TYPE w deskryptorze bezpośrednio wyznacza, który akcesor (FileInterface) zostanie użyty przez storage::initializeAccessor(). Brak pola TYPE jest równoznaczny z DEFAULT. Wartość jest nieczuła na wielkość liter (MEMORY = memory).
Plik danych binarnych
Plik danych to sekwencja rekordów o stałej długości, zapisywanych jeden po drugim bez żadnego nagłówka. Rozmiar pojedynczego rekordu R wyznaczany jest przez deskryptor jako suma bajtów wszystkich pól.
| Offset w pliku | Zawartość | Rozmiar |
|---|---|---|
| 0 | Rekord 0 | R bajtów |
| R | Rekord 1 | R bajtów |
| 2R | Rekord 2 | R bajtów |
| … | … | … |
| (N-1) × R | Rekord N-1 | R bajtów |
Każdy rekord zawiera upakowane wartości pól w kolejności zdefiniowanej przez deskryptor:
| Offset w rekordzie | Pole | Rozmiar |
|---|---|---|
| 0 | pole_0 | len_0 bajtów |
| len_0 | pole_1 | len_1 bajtów |
| len_0 + len_1 | … | … |
| len_0 + len_1 + … + len_n | pole_n | len_n bajtów |
Operacja append (dodanie nowego rekordu) dopisuje dane na koniec pliku. Operacja update (modyfikacja istniejącego rekordu) - jeśli istnieje plik cienia - trafia do pliku cienia, a nie do pliku głównego.
Przykład
DECLARE a INTEGER, b FLOAT STREAM src, 0.1 BINFILE 'data.dat'
SELECT * STREAM str1 FROM src
Rozmiar rekordu: INTEGER (4 B) + FLOAT (4 B) = 8 bajtów. Plik wynikowy str1 po zapisaniu 50 rekordów zajmuje 50 × 8 = 400 bajtów. Przy interwale 0.1 s jest to 5 sekund danych. data.dat jest istniejącym źródłem tylko do odczytu; DECLARE go nie powiększa.
Odczyt rekordu, którego nie ma
Żądanie indeksu leżącego za ostatnim rekordem - albo odczyt z pustego magazynu - nie jest odczytem udanym. Od 23 września 2026 storage::read() i storage::revRead() oddają w takim razie osobny status NoSuchRecord, zerują bufor docelowy i ustawiają cały wzorzec null na jedynki: rekord, którego nie ma, jest wartością nieokreśloną, nie rekordem zerowym. Jest to ta sama konwencja, którą dataModel::fetchBack() i fetchForward() stosują dla odczytu poza zgromadzoną historią.
Ma to znaczenie dla wyniku, nie tylko dla diagnostyki. Wcześniej ta gałąź zwracała powodzenie i oznaczała wyzerowany rekord jawnie jako nie-null, więc semantyka pochłaniania NULL-i się nie włączała i reduktory MIN, MAX, SUMC i AVG składały sfałszowane zero do wyniku zamiast pominąć brakujący rekord (→ Operatory agregujące). Narzędzie xtrdb rozróżnia wstępną odmowę indeksu poza zakresem (record out of range, bez zmiany payloadu) od nieudanego odczytu dopuszczonego indeksu (error i, dla listy, fetch error). Szczegóły opisuje xtrdb.
Wzorzec null żyje w payloadzie i w indeksie .meta, czyli wewnątrz silnika. Zrzut DO DUMP go nie niesie - rekord nieistniejący zapisuje się w nim jako zera nieodróżnialne od danych (→ Realizacja alarmowania).
Plik metadanych (.meta)
Plik .meta to indeks wartości null i przerw w transmisji. Przechowuje informację o tym, które pola rekordów mają wartość null i gdzie wystąpiły przerwy - bez duplikowania samych danych.
Format pliku
| Pozycja | Zawartość | Rozmiar |
|---|---|---|
| Nagłówek | pole zarezerwowane (int64, zawsze 0) | 8 bajtów |
| Wpis RLE 0 | gapFlag | count | bitsetSize | bitset | zmienny |
| Wpis RLE 1 | gapFlag | count | bitsetSize | bitset | zmienny |
| … | … | … |
| Wpis RLE k | wpis bieżący (w pamięci) | zmienny |
Format wpisu RLE
Każdy wpis opisuje ciąg kolejnych rekordów z identycznym wzorcem null:
| Pole | Rozmiar | Opis |
|---|---|---|
gapFlag | 1 B | 0 = normalny rekord, 1 = przerwa |
recordCount | 8 B (size_t) | liczba rekordów w ciągu |
bitsetSize | 8 B (size_t) | liczba pól (N) |
bitset | ⌈N/8⌉ B | bit i = pole i ma wartość null |
Wzorzec null dotyczy konkretnego rekordu: bit ustawiony dla jednego pola nie zmienia pozostałych pól ani innych rekordów opisanych tym samym deskryptorem. Liczbowe pole tablicowe T[N] jest jednym wpisem deskryptora i ma jeden wspólny bit null dla wszystkich N elementów; ustawiony bit oznacza null całego pola. Przy przekształceniu N pól skalarnych w jedno T[N] null w dowolnym z nich ustawia ten wspólny bit.
Kompresja RLE
Kolejne rekordy z tym samym wzorcem null są scalane w jeden wpis przez zwiększenie recordCount. Nowy wpis tworzony jest dopiero gdy wzorzec się zmienia.
10 rekordów, 2 pola, bez null:
| Wpis | isGap | count | bitset |
|---|---|---|---|
| wpis 0 | F | 10 | [F,F] |
Null w polu 1 od rekordu 5:
| Wpis | isGap | count | bitset |
|---|---|---|---|
| wpis 0 | F | 5 | [F,F] |
| wpis 1 | F | 5 | [F,T] |
Przerwa w transmisji po rekordzie 3:
| Wpis | isGap | count | bitset |
|---|---|---|---|
| wpis 0 | F | 3 | [F,F] |
| wpis 1 | T | 7 | [T,T] |
| wpis 2 | F | … | [F,F] |
Marker przerwy w transmisji (gap)
Przerwa w transmisji (np. wyłączenie systemu, zanik sygnału) rejestrowana jest jako wpis z isGap=true i wszystkimi bitami null ustawionymi na true. Parametr count przechowuje długość przerwy w jednostkach interwału strumienia. Sam plik danych binarnych nie zawiera żadnych dodatkowych rekordów dla przerwy - informacja żyje wyłącznie w pliku .meta.
NOTE: Opisana funkcjonalność ma pokrycie w testach:
issue113_meta_internal,issue113_meta_autocreateopisanych w załączniku pt. Testy Integracyjne.
Klasa metaData
Plikiem .meta zarządza klasa rdb::metaData. Jest ona koordynatorem: sama utrzymuje politykę RLE (leniwe nadpisanie ostatniego wpisu, numeracja rekordów), a wyspecjalizowane fragmenty deleguje do osobnych jednostek:
| Jednostka | Nagłówek | Rola |
|---|---|---|
IndexRecord | indexRecord.hpp | format pojedynczego wpisu i jego (de)serializacja |
MetaIndexStore | metaIndexStore.hpp | surowe I/O pliku .meta - nagłówek, wpisy zatwierdzone, cache |
GapDetector | gapDetector.hpp | maszyna stanów wykrywania przerw (nullfill, absorpcja, przerwa oczekująca) |
splitSegment(), sumNonGapRecords() | rleSegment.hpp | operacje na segmentach RLE |
storageShadow | storageShadow.hpp | wariant kierujący aktualizacje do cienia indeksu (.meta.shadow) |
Sama metaData hermetyzuje trzy obszary odpowiedzialności:
- Agregację RLE w pamięci - buforuje bieżący segment (ostatnią serię rekordów z identycznym wzorcem null) w polu
currentEntry_, nie zapisując go do pliku przy każdym rekordzie. - Trwałość danych - wyłącznie zakończone segmenty (gdy wzorzec się zmienia lub gdy nastąpi jawne wywołanie
flushCurrentEntry()) trafiają do pliku jako wpisy zatwierdzone (committed). - Indeks zapytań - udostępnia interfejs do odpytywania wzorca null dla dowolnego rekordu oraz wykrywania przerw w transmisji.
Klasa przechowuje dwa stany:
| Stan | Lokalizacja | Opis |
|---|---|---|
| Zatwierdzone segmenty | plik .meta na dysku | wszystkie zakończone przebiegi RLE |
Segment bieżący (currentEntry_) | pamięć operacyjna | aktualnie akumulowany przebieg (jeszcze niezapisany lub do nadpisania) |
Cykl życia obiektu
Diagram stanów (Rys. 16) przedstawia przejścia między fazami obiektu metaData:
%% pdf-width: 30%
stateDiagram-v2
    [*] --> Budowa : konstruktor
    Budowa --> Aktywny : loadIndex()
    Aktywny --> Aktywny : onRecordAppended()
    Aktywny --> Aktywny : onRecordModified()
    Aktywny --> Aktywny : onTransmissionGap()
    Aktywny --> Aktywny : flushCurrentEntry()
    Aktywny --> [*] : destruktor (auto flush)
Rys. 16. Cykl życia obiektu metaData
Konstruktor (metaData(descriptor, path)):
- Inicjalizuje pusty
currentEntry_na podstawie liczby pól deskryptora. - Wywołuje
loadIndex()- jeżeli plik istnieje, wczytuje wszystkie zatwierdzone segmenty, wyznaczacommittedRecordCount_, a ostatni niegapowy segment przenosi z powrotem docurrentEntry_(umożliwia kontynuację serii RLE po restarcie). - Jeżeli plik nie istnieje, tworzy go i zapisuje nagłówek (8 bajtów zarezerwowanych, zera).
Destruktor automatycznie wywołuje flushCurrentEntry(), gwarantując, że bieżący bufor trafi na dysk nawet gdy program zakończy pracę w normalnym trybie.
Interfejs aktualizacji
Klasa wyróżnia trzy scenariusze zmiany stanu metadanych:
onRecordAppended(nullBitset)
Wywoływany przez storage po każdym dołączeniu nowego rekordu do pliku danych.
wzorzec identyczny z currentEntry_?
├─ TAK → zwiększ currentEntry_.recordCount (akumulacja RLE, brak I/O)
└─ NIE → flushCurrentEntry() (poprzedni segment na dysk)
          ustaw currentEntry_ = {nullBitset, count=1}
Operacja I/O następuje wyłącznie przy zmianie wzorca - dla serii identycznych rekordów koszt to jedna inkrementacja licznika w pamięci.
onRecordModified(index, nullBitset)
Wywoływany przez storage przy aktualizacji istniejącego rekordu. Zachowanie zależy od trybu pracy:
Tryb normalny (brak pliku cienia danych): lokalizuje rekord w segmentach RLE i rozbija segment na maksymalnie trzy części: przed modyfikowanym rekordem, sam rekord, za nim.
rekord w currentEntry_ (pamięć)?
├─ TAK → splitSegment() w pamięci, nowe fragmenty dołączone do pliku
└─ NIE → wczytaj plik, splitSegment(), przepisz plik (rewriteFile)
Przykład rozbicia segmentu [allNull × 5] przy modyfikacji rekordu 2:
Przed:  [allNull × 5]
Po:     [allNull × 2] [allPresent × 1] [allNull × 2]
Wariant z cieniem (storageShadow, wstrzykiwany zamiast bazowego metaData dla magazynów utrzymujących plik .shadow): zamiast modyfikować główny indeks, dopisuje jedno nadpisanie wzorca null do pliku .meta.shadow. Główny indeks .meta pozostaje nienaruszony i spójny z głównym plikiem danych.
obiekt indeksu to storageShadow?
├─ TAK → metaShadow::appendOverride(index, nullBitset) → wpis w .meta.shadow
└─ NIE → modyfikacja głównego indeksu → splitSegment()
onTransmissionGap(duration)
Rejestruje przerwę w transmisji o podanej długości (w jednostkach interwału strumienia). Najpierw zatwierdza bieżący segment (flushCurrentEntry()), następnie dołącza do pliku wpis z isGap=true (Rys. 17).
sequenceDiagram
    participant S as storage
    participant M as metaData
    participant F as plik .meta

    S->>M: onTransmissionGap(5)
    M->>F: flushCurrentEntry() - zapisz [normalny, count=N]
    M->>F: appendEntry(isGap=true, count=5)
    Note over F: plik zawiera teraz marker przerwy
Rys. 17. Sekwencja rejestracji przerwy - onTransmissionGap
Mechanizm bezpieczeństwa: flushCurrentEntry() i nadpisywanie (tail_.dirty)
Klasa storage wywołuje flushCurrentEntry() po udanym fizycznym dopisaniu rekordu, po aktualizacji metadanych przez onRecordAppended(). Rekord pochłonięty przez mechanizm przerwy transmisji oraz odmowa dopisania do źródła tylko do odczytu kończą write() wcześniej. Nadpisanie istniejącego rekordu wywołuje onRecordModified(), które aktualizuje indeks główny albo jego cień, zależnie od rodzaju magazynu.
flushCurrentEntry() zapisuje bieżący wpis indeksu do pliku, ograniczając ilość metadanych pozostających wyłącznie w pamięci procesu. Ten zapis nie obejmuje fsync po każdym rekordzie ani transakcyjnego zatwierdzenia danych wraz z indeksem, więc sam w sobie nie gwarantuje spójności po awarii procesu lub utracie zasilania. Test ut_metaData_usage sprawdza sekwencję dopisania i jawnego flushu; nie symuluje awarii procesu.
Przepisanie indeksu przez MetaIndexStore::rewrite() zwraca Result z błędem Errc::IO i errno, jeśli nie uda się otworzyć lub zapisać pliku tymczasowego albo podmienić .meta. onRecordModified() przekazuje ten błąd przed zmianą stanu indeksu w pamięci; nie zapewnia to transakcji z wcześniejszym zapisem danych. Błąd przepisania przy loadIndex() jest błędem inicjalizacji i odłącza persystencję. Osobne ścieżki appendEntry, overwriteLast i saveHeader nadal nie mają takiej propagacji błędów; port #511 nie daje ogólnej gwarancji wykrycia każdej awarii zapisu metadanych. Regresje odmowy podmiany sprawdza ut_metaData.
Naiwna implementacja dopisywałaby nowy wpis do pliku przy każdym flushu - powodując wzrost pliku proporcjonalny do liczby rekordów, nawet bez zmian wzorca null.
Rozwiązanie: mechanizm lazy overwrite oznaczany flagą tail_.dirty.
flushCurrentEntry() → zapis [wzorzec, count=2] na dysk
onRecordAppended(ten sam wzorzec):
    currentEntry_.count = 2 (przywrócony z dysku)
    tail_.markDirty()        ← następny flush nadpisze, nie doda
    currentEntry_.count++    → count = 3
flushCurrentEntry() → seek na ostatni wpis, overwrite [wzorzec, count=3]
    (rozmiar pliku bez zmian)
Diagram sekwencji dla typowego wzorca storage (append + flush po każdym rekordzie) ilustruje Rys. 18:
%% pdf-height: 55%
sequenceDiagram
    participant S as storage
    participant M as metaData
    participant F as plik .meta

    S->>M: onRecordAppended([F,F])
    S->>M: flushCurrentEntry()
    M->>F: appendEntry([F,F], count=1)

    S->>M: onRecordAppended([F,F])
    S->>M: flushCurrentEntry()
    Note over M: tail_.dirty=true, overwrite last entry
    M->>F: overwrite last entry: [F,F] count=2

    S->>M: onRecordAppended([F,F])
    S->>M: flushCurrentEntry()
    M->>F: overwrite last entry: [F,F] count=3

    S->>M: onRecordAppended([T,F])
    Note over M: inny wzorzec → nowy wpis
    S->>M: flushCurrentEntry()
    M->>F: appendEntry([T,F], count=1)
Rys. 18. Mechanizm lazy overwrite - nadpisywanie ostatniego wpisu .meta
Dzięki temu plik .meta rośnie wyłącznie przy zmianie wzorca null - nie przy każdym rekordzie. Przy ciągłym napływie jednorodnych danych plik ma stały rozmiar niezależnie od liczby rekordów.
Persystencja i odtwarzanie stanu
Po restarcie procesu nowy obiekt metaData wczytuje plik przez loadIndex() (sekwencja na Rys. 19):
- Pomija nagłówek - 8 bajtów zarezerwowanych; nic z nich nie jest interpretowane.
- Wczytuje wszystkie zatwierdzone wpisy z pliku.
- Jeżeli ostatni wpis nie jest gap-em - przenosi go z powrotem do
currentEntry_i usuwa z pliku (umożliwia kontynuację RLE po restarcie bez duplikacji). - Wyznacza
committedRecordCount_jako sumęrecordCountwszystkich niegalowych wpisów pozostałych w pliku.
sequenceDiagram
    participant Proc1 as Pierwsza sesja
    participant F as plik .meta
    participant Proc2 as Druga sesja

    Proc1->>F: zapisuje segmenty [A×500][B×200]
    Note over Proc1: destruktor → flushCurrentEntry()
    Proc1->>F: ostatni segment zatwierdzony

    Proc2->>F: loadIndex()
    F-->>Proc2: odczyt wszystkich segmentów
    Note over Proc2: ostatni segment przeniesiony do currentEntry_
    Note over Proc2: gotowość do kontynuacji RLE
    Proc2->>Proc2: totalRecords() = 700
Rys. 19. Persystencja i odtwarzanie stanu po restarcie
Interfejs zapytań
| Metoda | Opis |
|---|---|
getNullBitset(i) | Zwraca wzorzec null dla rekordu i. Metoda wirtualna: w wariancie storageShadow najpierw sprawdza nadpisania w metaShadow (od końca - ostatnie wygrywa), a dopiero przy braku wpisu sięga do głównego indeksu. |
nullBitsetFor(i) | Jak wyżej, ale dla rekordu spoza zakresu indeksu zwraca wzorzec „nic nie jest null“ bez zgłoszenia błędu. Bezpośrednie getNullBitset(i) wymaga indeksu w zakresie; naruszenie tego warunku jest błędem niezmiennika, nie obsługiwalnym wyjątkiem. Pozwala storage::read() nałożyć metadane null na rekord, który w pliku danych jest, a w indeksie jeszcze go nie ma. Rekordu, którego nie ma w samym pliku danych, ten wzorzec nie dotyczy - storage::read() zgłasza wtedy brak rekordu i sam ustawia wzorzec all-null (→ Odczyt rekordu, którego nie ma). |
isGapBefore(i) | Zwraca true, jeżeli bezpośrednio przed rekordem i w indeksie RLE znajduje się wpis isGap=true. Rekord 0 nigdy nie ma przerwy przed sobą. |
segments() | Zwraca wszystkie segmenty RLE: zatwierdzone (z dysku) oraz bieżący (z pamięci), jeżeli jest niepusty. Nie obejmuje nadpisań z .meta.shadow. Służy do inspekcji i testów. |
totalRecords() | Suma rekordów we wszystkich segmentach (committed + pending). |
isEmpty() | Skrót: totalRecords() == 0. |
rotate(percounter) | Rotuje plik indeksu: przemianowuje bieżący plik .meta na .meta.old<N>, tworzy nowy pusty plik. Wywoływana przez storage::detectStartupState() po wykryciu rotacji pliku danych (plik danych pusty, indeks niepusty). Gdy percounter < 0, plik nie jest przemianowywany - wykonywany jest tylko reset indeksu. |
reset() | Czyści indeks w miejscu: zeruje liczniki, przepisuje plik z samym nagłówkiem bez zmiany jego nazwy. Wywołuje też discardShadow(). Wywoływany przez storage przy czyszczeniu bez zachowania historii (np. po purge()). |
Interfejs cienia indeksu
Metody klasy storageShadow - wariantu indeksu wstrzykiwanego przez makeMetaIndex() dla magazynów utrzymujących plik cienia danych. Bazowy metaData ich nie ma; nie ma też przełącznika trybu, bo o obecności cienia decyduje wybór klasy przy inicjalizacji magazynu.
| Metoda | Opis |
|---|---|
| konstruktor | Wczytuje istniejące nadpisania z pliku .meta.shadow (metaShadow::load()), przywracając stan cienia po restarcie procesu. |
mergeShadow() | Scala nadpisania z cienia do głównego indeksu (aplikuje każde nadpisanie w kolejności zapisu - ostatnie wygrywa), a następnie usuwa plik .meta.shadow. Odpowiednik merge() dla pliku cienia danych. |
discardShadow() | Czyści listę nadpisań w pamięci i usuwa plik .meta.shadow. Wywoływany przy odrzuceniu cienia danych (purge, reset, rotacja). |
metaShadowFilePath(p) | Statyczna: zwraca ścieżkę pliku cienia indeksu odpowiadającą danemu plikowi .meta, bez tworzenia obiektu. Używana przez storage przy porządkowaniu zasobów. |
Przykład użycia - typowy scenariusz produkcyjny
storage.write(rec0)           → onRecordAppended([F,F,F]) + flushCurrentEntry()
storage.write(rec1)           → onRecordAppended([F,F,F]) + flushCurrentEntry()
storage.write(rec2_val_null)  → onRecordAppended([T,F,F]) + flushCurrentEntry()
storage.write(rec3)           → onRecordAppended([F,F,F]) + flushCurrentEntry()

Plik .meta po powyższych operacjach (4 flushe, 2 segmenty):
  [isGap=F, count=2, bitset=[F,F,F]]   ← wpis 0
  [isGap=F, count=1, bitset=[T,F,F]]   ← wpis 1  (rec2)
  [isGap=F, count=1, bitset=[F,F,F]]   ← wpis 2  (rec3, bieżący w pamięci)

getNullBitset(2) → [T,F,F]   (pole 0 rekordu 2 jest null)
isGapBefore(2)  → false
totalRecords()  → 4
Plik cienia (.shadow)
Plik cienia umożliwia modyfikację zarejestrowanych rekordów bez niszczenia danych oryginalnych. Usunięcie pliku .shadow przywraca oryginalny stan danych.
Format wpisu
| Pole | Rozmiar | Opis |
|---|---|---|
position | 8 B (size_t) | indeks rekordu w pliku głównym |
data | R bajtów | nowe wartości rekordu |
Każda modyfikacja dopisuje nowy wpis na koniec pliku cienia. Przy wielu modyfikacjach tego samego rekordu plik może zawierać wiele wpisów dla tej samej pozycji - aktualny jest ostatni.
Priorytety odczytu
Priorytety odczytu to reguła rozstrzygania, z którego źródła system ma zwrócić wartość rekordu, gdy ten sam indeks może występować jednocześnie w pliku głównym i w pliku cienia. W RetractorDB priorytet definiowany jest deterministycznie: najpierw sprawdzany jest .shadow (od końca, aby wybrać najnowszą modyfikację), a dopiero przy braku wpisu wykonywany jest odczyt z pliku głównego. Pojęcie to dotyczy aspektu spójności i wersjonowania odczytu danych po modyfikacjach, a nie samego fizycznego formatu zapisu rekordu w pliku binarnym.
%% pdf-width: 100%
flowchart LR
    Q["Odczyt rekordu na pozycji P"]
    Q --> SH{"Szukaj P w .shadow\n(od końca)"}
    SH -->|znaleziono| RET1["Zwróć dane z .shadow\n(najnowsza modyfikacja)"]
    SH -->|nie znaleziono| MAIN["Odczyt z pliku głównego\npread(fd, pos=P×R)"]
    MAIN --> RET2["Zwróć dane oryginalne"]
Rys. 20. Priorytety odczytu rekordu z pliku cienia
Rys. 20 przedstawia logikę odczytu rekordu: system najpierw sprawdza wpis w .shadow, a dopiero przy jego braku odczytuje rekord z pliku głównego.
Scalanie (merge)
Operacja merge() scala zmiany z pliku cienia do pliku głównego i zeruje plik cienia. Po scaleniu dane oryginalne są bezpowrotnie nadpisane.
sequenceDiagram
    participant App
    participant Shadow as .shadow
    participant Main as plik główny

    App->>Shadow: odczyt wszystkich wpisów (i, data_i)
    loop dla każdego wpisu
        Shadow-->>App: (position=i, data=data_i)
        App->>Main: pwrite(data_i, offset=i×R)
    end
    App->>Shadow: ftruncate(0) - wyczyść plik cienia
Rys. 21. Scalanie pliku cienia z plikiem głównym
Rys. 21 przedstawia przebieg merge(): kolejne wpisy (position, data) z .shadow są zapisywane do pliku głównego, a po zakończeniu plik cienia jest czyszczony.
Przykład: modyfikacja rekordu
# Strumień str1: 2 pola INTEGER (4B każde), recordSize = 8B
# Rekord 2 (oryginał): [100, 200]
# Modyfikacja: pole 0 → 999

# Plik .shadow po modyfikacji:
# offset 0: [position=2 (8B)][999, 200 (8B)]
Odczyt rekordu 2 zwróci [999, 200]. Odczyt rekordu 0 i 1 zwróci dane z pliku głównego (nie ma ich w shadow).
Plik cienia indeksu (.meta.shadow)
Plik .meta.shadow jest odpowiednikiem .shadow na poziomie indeksu null. Rejestruje nadpisania wzorców null dla poszczególnych rekordów bez modyfikowania głównego pliku .meta, zachowując spójność pary: plik główny ↔ .meta oraz plik cienia ↔ .meta.shadow.
Kiedy powstaje
Plik .meta.shadow jest tworzony automatycznie, gdy spełnione są dwa warunki:
- Magazyn jest typu
DEFAULTlubPOSIXSHD- czyli taki, który trzyma modyfikacje rekordów w pliku.shadow(nie w pliku głównym). - W danej sesji wykonana zostanie przynajmniej jedna modyfikacja istniejącego rekordu (
storage::write()na indeks inny niż maksymalny).
Warunek 1 nie jest przełącznikiem trybu, lecz wyborem klasy. Przy inicjalizacji magazynu fabryka makeMetaIndex() (accessorFactory.hpp) pyta akcesor o hasShadow() i zwraca:
| Warunek | Zwracany obiekt | Zachowanie |
|---|---|---|
źródło deklarowane (DECLARE) | metaData z pustą ścieżką | wariant inertny - indeks działa w pamięci, nic nie trafia na dysk |
| akcesor ma plik cienia danych | storageShadow | onRecordModified() kieruje nadpisania do metaShadow (.meta.shadow) |
| pozostałe | metaData | modyfikacje przepisują główny indeks .meta |
storageShadow dziedziczy po metaData i nadpisuje wirtualne onRecordModified(), getNullBitset() oraz reset(); samym plikiem .meta.shadow zarządza jego pole typu metaShadow. Dzięki temu storage nie zawiera żadnego rozgałęzienia na tryb cienia.
Format pliku
Plik .meta.shadow nie ma nagłówka. Jest sekwencją wpisów w tym samym formacie binarnym co wpisy w pliku .meta, z tą różnicą, że pole recordCount przechowuje bezwzględny indeks rekordu (nie liczbę rekordów w serii RLE):
| Pole | Rozmiar | Znaczenie w .meta.shadow |
|---|---|---|
gapFlag | 1 B | zawsze 0 (nadpisania nie są przerwami) |
recordCount | 8 B (size_t) | bezwzględny indeks nadpisywanego rekordu |
bitsetSize | 8 B (size_t) | liczba pól deskryptora (N) |
bitset | ⌈N/8⌉ B | nowy wzorzec null dla tego rekordu |
Każde wywołanie onRecordModified() w trybie cienia dopisuje jeden wpis na koniec pliku. Wiele wpisów dla tej samej pozycji jest dozwolone - obowiązuje ostatni wpis (semantyka „last-write-wins“, zgodna z plikiem .shadow).
Priorytety odczytu
storageShadow::getNullBitset(i) skanuje listę nadpisań od końca. Jeżeli znajdzie wpis dla indeksu i, zwraca jego wzorzec null bez sięgania do głównego indeksu (Rys. 22):
flowchart TD
    Q["getNullBitset(i)"]
    Q --> SM{"obiekt to storageShadow?"}
    SM -->|tak| SCAN{"metaShadow::lookup(i)\n(od końca): wpis dla i?"}
    SCAN -->|znaleziono| RET1["Zwróć nullBitset z nadpisania\n(najnowsze wygrywa)"]
    SCAN -->|nie znaleziono| MAIN["Wyszukaj w głównym indeksie\n(segmenty RLE na dysku)"]
    SM -->|nie| MAIN
    MAIN --> RET2["Zwróć wzorzec z .meta"]
Rys. 22. Priorytety odczytu wzorca null - główny indeks vs. cień indeksu
Cykl życia
Plik .meta.shadow jest zarządzany równolegle z plikiem cienia danych:
Zdarzenie na pliku .shadow | Akcja na .meta.shadow |
|---|---|
| Pierwsza modyfikacja rekordu | Tworzenie pliku; dołączenie pierwszego wpisu |
| Kolejne modyfikacje | Dołączanie kolejnych wpisów |
merge() - scalenie cienia z plikiem głównym | mergeShadow() - nadpisania aplikowane do .meta; plik usuwany |
purge() / reset() - odrzucenie cienia | discardShadow() - plik usuwany bez scalania |
| Restart procesu | konstruktor storageShadow → metaShadow::load() - plik odczytywany; nadpisania przywrócone w pamięci |
| Usunięcie tymczasowego magazynu (destruktor) | Plik .meta.shadow usuwany razem z .meta |
Persystencja po restarcie
Po restarcie procesu nowy obiekt storageShadow przywraca stan cienia już w konstruktorze, przez metaShadow::load() (Rys. 23):
- Odczytuje wszystkie wpisy z
.meta.shadow(brak nagłówka - format bezpośredni). - Ładuje je do listy nadpisań w kolejności zapisu.
getNullBitset()i kolejneonRecordModified()działają tak samo jak przed restartem.
%% pdf-width: 100%
sequenceDiagram
    participant Proc1 as Pierwsza sesja
    participant MS as .meta.shadow
    participant Meta as .meta

    Proc1->>Meta: onRecordAppended([F,F,F]) × 5
    Proc1->>MS: onRecordModified(2, [T,T,T]) → dołącz wpis (index=2)
    Note over Meta: .meta bez zmian [allNull×5]
    Note over MS: .meta.shadow: [(index=2, [T,T,T])]

    Note over Proc1: restart

    participant Proc2 as Druga sesja
    Proc2->>MS: konstruktor storageShadow → metaShadow::load()
    MS-->>Proc2: [(index=2, [T,T,T])]
    Note over Proc2: getNullBitset(2) → [T,T,T]
    Proc2->>Meta: mergeShadow() → applyModificationToMainIndex(2, [T,T,T])
    Proc2->>MS: usuń plik .meta.shadow
Rys. 23. Cień indeksu - odtwarzanie wzorców null po restarcie
Przykład użycia - korekta rekordu z zachowaniem spójności
# 5 rekordów w strumieniu str1, 3 pola FLOAT
# Rekord 2 ma wartość null w polu 0: nullBitset=[T,F,F]
# Operator koryguje pole 0 rekordu 2 → zmiana wzorca na [F,F,F]

# Operacje:
storage.write(rec2_corrected, pos=2)
  → .shadow: dołącz (position=2, data_corrected)
  → storageShadow.onRecordModified(2, [F,F,F])
    → .meta.shadow: dołącz (index=2, [F,F,F])

# Stan plików:
# .meta        - bez zmian: [isGap=F, count=2, [F,F,F]],
# >> [isGap=F, count=1, [T,F,F]], [isGap=F, count=2, [F,F,F]]
# .meta.shadow - nowy wpis: [gapFlag=0, recordCount=2, bitset=[F,F,F]]

# Odczyt:
getNullBitset(2) → [F,F,F]  (z .meta.shadow)
getNullBitset(1) → [F,F,F]  (z .meta)

# Po scaleniu:
storage.merge() → .shadow wchłonięty do pliku głównego
storageShadow.mergeShadow() → .meta przebudowany, .meta.shadow usunięty
# .meta po merge: [isGap=F, count=5, [F,F,F]]  (wszystkie rekordy pełne)
NOTE: Mechanizm
.meta.shadowjest testowany w testach jednostkowychut_metaShadow_usage(format i cykl życia pliku cienia) orazut_storageShadow_usage(integracja zmetaDatai akcesorem).
Relacja pomiędzy plikami
W tej części relacje między plikami są pokazane na dwóch poziomach. Poziom strukturalny opisuje, że plik danych jest nośnikiem rekordów, deskryptor .desc definiuje ich format, plik .meta przechowuje informację o wartościach null i przerwach transmisji, .shadow gromadzi modyfikacje danych bez niszczenia oryginału, a .meta.shadow gromadzi analogicznie nadpisania wzorców null. Poziom operacyjny (Rys. 24) pokazuje przebieg odczytu i zapisu: odczyt najpierw sprawdza .shadow i .meta.shadow, a dopiero przy braku wpisu sięga do pliku głównego i .meta. Operacje append, update i read utrzymują w ten sposób spójność danych i metadanych w całym cyklu życia artefaktu. Scalenie merge() / mergeShadow() nie należy do tego przebiegu: to osobna operacja API, której silnik nie wywołuje samodzielnie (Rys. 21).
%% pdf-width: 100%
graph LR
    UP["update<br/>write(N), N < count"] -->|dopisz| CIEN
    AP["append<br/>write(N), N ≥ count"] -->|dopisz na koniec| GL

    subgraph CIEN["warstwa cienia"]
        direction TB
        S[".shadow<br/>(N·size, data)"]
        MS[".meta.shadow<br/>(N, nullBitset)"]
    end

    subgraph GL["warstwa główna"]
        direction TB
        D["plik główny<br/>data"]
        M[".meta<br/>nullBitset"]
    end

    CIEN ==>|"1. jest wpis N"| RD["read(pos=N)<br/>data + nullBitset"]
    GL -->|"2. brak wpisu N"| RD
Rys. 24. Relacja pomiędzy operacjami zapisu, modyfikacji i odczytu artefaktu (typy DEFAULT i POSIXSHD)
Rys. 24 przedstawia przepływ operacji append, update i read przez warstwę storage oraz ich bezpośredni wpływ na plik danych, .meta, .shadow i .meta.shadow. O rodzaju zapisu decyduje indeks rekordu: N równy lub większy od liczby rekordów to append, mniejszy to update. Wpis w .shadow jest kluczowany przesunięciem w bajtach (N·size, przy retencji liczonym względem segmentu), wpis w .meta.shadow indeksem rekordu N. Rekord złożony wyłącznie z wartości null poza fazą nullfill nie trafia do pliku głównego - zostaje po nim wpis przerwy w .meta. Warstwa cienia istnieje tylko dla typów DEFAULT i POSIXSHD; w pozostałych typach (POSIX, DIRECT, GENERIC, MEMORY) update nadpisuje rekord bezpośrednio w pliku głównym i w .meta.
Punkt wyjścia - plik binarny bez metadanych
Najprostszy możliwy zapis serii czasowej to sekwencja surowych wartości w pliku binarnym: stały rozmiar rekordu, brak nagłówka, brak opisu struktury. Takie podejście ma jedną zaletę - minimalny narzut - i szereg istotnych ograniczeń:
- Interpretacja danych wymaga wiedzy zewnętrznej wobec pliku (nazwy pól, typy, kolejność).
- Brak informacji o przerwach w transmisji - ciągłość danych jest pozorna.
- Każda modyfikacja historycznego rekordu niszczy dane oryginalne nieodwracalnie.
- Zmiana struktury rekordu unieważnia cały plik.
RetractorDB rejestruje dane z czujników działających w czasie rzeczywistym, gdzie przerwy zasilania, zaniki sygnału i konieczność retrospektywnej korekty danych są normalnym zjawiskiem eksploatacyjnym, nie wyjątkiem. Struktura pięciu plików odpowiada bezpośrednio na każde z tych ograniczeń.
Co wnosi każdy plik
Deskryptor (.desc) - samoopisywalność i niezależność od kodu
Plik danych binarnych jest bezużyteczny bez znajomości struktury rekordu. Deskryptor przechowuje tę wiedzę obok danych, co oznacza:
- Dane można odczytać i zinterpretować bez dostępu do kodu źródłowego ani konfiguracji - wystarczy plik
.desc. - Narzędzie
xtrdbmoże analizować dowolny artefakt bez dodatkowych parametrów. - Zmiana struktury strumienia (dodanie pola, zmiana typu) jest jawna i wersjonowalna.
- Pole
TYPEw deskryptorze decyduje o strategii składowania, co pozwala temu samemu silnikowi obsługiwać trwałe artefakty, ulotne efemerydy i zewnętrzne źródła danych bez zmiany logiki zapytań.
Plik metadanych (.meta) - wiarygodność serii czasowej
Seria czasowa z dziurami, traktowana jako ciągła, prowadzi do błędnych obliczeń okien czasowych, błędnych agregacji i fałszywych korelacji. Plik .meta zapewnia:
- Odróżnienie rekordu z wartością zero od rekordu nieobecnego (null) - semantycznie zupełnie różnych stanów.
- Rejestrację przerw w transmisji bez wstawiania fikcyjnych rekordów do pliku danych - plik binarny pozostaje gęsty i adresowalny pozycyjnie.
- Kompresję RLE - typowe serie czasowe mają długie okresy bez null, więc koszt metadanych jest bliski zeru dla danych dobrej jakości.
- Możliwość odtworzenia dokładnego harmonogramu rejestracji, w tym długości przerw, co jest niezbędne przy obliczaniu interwałów w algebrze strumieni.
Plik cienia (.shadow) - niedestruktywna korekta danych
W systemach pomiarowych korekta błędnych próbek po fakcie jest standardową procedurą. Nadpisanie pliku binarnego jest nieodwracalne i usuwa dowód oryginalnego pomiaru. Plik cienia:
- Pozwala skorygować dowolny historyczny rekord bez modyfikacji pliku głównego.
- Zachowuje oryginalny pomiar jako domyślny - usunięcie pliku
.shadoww pełni przywraca stan wyjściowy. - Umożliwia scalenie (
merge) korekt do pliku głównego wtedy, gdy jest to świadoma decyzja operatora, nie skutek uboczny zapisu. - Separuje dane certyfikowane (plik główny) od danych roboczych (plik cienia), co ma znaczenie w zastosowaniach wymagających audytowalności.
Plik cienia indeksu (.meta.shadow) - spójność metadanych przy korekcie
Korekta rekordu w pliku cienia danych musi znaleźć odzwierciedlenie w indeksie null - inaczej getNullBitset() zwróciłoby przestarzały wzorzec z głównego .meta. Plik .meta.shadow:
- Utrzymuje spójność między parami:
plik główny ↔ .metaoraz.shadow ↔ .meta.shadow. - Pozwala
getNullBitset()zwrócić aktualny wzorzec null dla skorygowanego rekordu bez modyfikowania głównego indeksu. - Śledzi cykl życia pliku cienia danych - scalany i usuwany dokładnie razem z
.shadow. - Umożliwia pełne odtworzenie stanu po restarcie: nadpisania załadowane z
.meta.shadowsą natychmiast dostępne bez ponownego skanowania pliku cienia danych.
Mechanizm rotacji plików
Przez rotację plików rozumiemy kontrolowane zamykanie bieżącego zestawu plików danych i metadanych oraz przeniesienie ich do wersji historycznych (.old<N>), tak aby nowa sesja mogła rozpocząć zapis od czystego stanu bez utraty wcześniejszych pomiarów. Stosuje się to po to, aby oddzielić kolejne sesje akwizycji, zachować pełną ścieżkę audytu i ułatwić diagnostykę problemów w czasie. Celem rotacji jest jednocześnie utrzymanie porządku operacyjnego (aktualny zestaw roboczy + archiwum sesji) oraz zapewnienie możliwości odtworzenia i porównania danych historycznych.
NOTE: Opisana funkcjonalność ma pokrycie w testach:
rotation_test,retentionopisanych w załączniku pt. Testy Integracyjne. Zgodność wartości i bitówNULLw archiwach kolejnych sesji sprawdzają dodatkowoit_rotation_nullorazut_rdb.
Domyślne zachowanie (bez dyrektywy ROTATION)
Bez dyrektywy ROTATION w skrypcie RQL, xretractor przy każdym starcie usuwa pliki artefaktów (dane binarne, .desc, .meta) i zaczyna rejestrację od nowa.
Rotacja i usuwanie nie dotyczą efemerydów (DECLARE). Nie znaczy to, że efemeryda nie ma żadnego pliku: jej źródło danych (plik tekstowy, urządzenie) jest zewnętrzne wobec systemu i nietykalne, a obok niego powstaje deskryptor .desc opisujący schemat odczytu - storage::attachDescriptor() zapisuje go dla każdego strumienia, także deklarowanego. Efemeryda nie dostaje natomiast indeksu .meta: fabryka makeMetaIndex() wstrzykuje dla źródeł deklarowanych wariant inertny (metaData z pustą ścieżką pliku), który utrzymuje wzorce null w pamięci i nie wykonuje żadnego I/O. Jest to więc brak persystencji metadanych, nie brak samego obiektu indeksu.
Dyrektywa ROTATION i licznik sesji
Dyrektywa ROTATION włącza tryb zachowania historii. Przyjmuje ścieżkę do pliku przechowującego trwały licznik sesji:
ROTATION 'rdb_counter'
Fabryka PersistentCounter::create() wczytuje wartość N z pliku i zapisuje N+1, rezerwując numer następnej sesji przed zwróceniem gotowego obiektu i rozpoczęciem archiwizacji. getCount() nadal zwraca N, używane w przyrostkach bieżącej sesji. Brak pliku oznacza pierwsze użycie i numer 0; istniejący plik pusty, nieczytelny lub niezawierający poprawnej nieujemnej liczby zatrzymuje start. Awaria procesu może zużyć numer bez utworzenia kompletu archiwów, dlatego luki w numeracji są dopuszczalne. Wartość licznika nie dowodzi zakończenia poprzedniej rotacji.
Przed startem, dostarczeniem planu do działającej usługi i przy xqry --reset licznik jest odczytywany bez rezerwacji numeru. Potwierdzony brak pliku jest poprawny; odczytana wadliwa zawartość (np. pusty plik, -1 lub tekst) jest odmową planu. Błąd sprawdzenia, otwarcia albo odczytu, w tym katalog zamiast pliku licznika, jest błędem środowiska. Start i dostarczenie rozróżniają je kodami EPROTO i EIO (na Linuksie 71 i 5). Przy resecie obie przyczyny dają Rejected: przed zmianą planu; dotychczasowy plan nadal działa. Tryb -c nie czyta licznika.
W jednostce systemd odmowa planu przy starcie opróżnia plik zapytań usługi, natomiast błąd środowiska pozostawia go do ponownego uruchomienia po naprawie. Poza jednostką plik operatora pozostaje nietknięty. Licznika nie wolno zastępować zgadywaną wartością: jego świadome usunięcie zaczyna rotację od 0 i może nadpisać istniejące archiwa .old<N>.
Zapis licznika przechodzi przez plik tymczasowy: jego treść jest synchronizowana przez fsync, a następnie rename zastępuje plik docelowy. Błąd przed zakończeniem tej podmiany wraca z fabryki jako Result z kategorią Errc::IO; xretractor zatrzymuje start kodem EIO, bez opróżnienia planu usługi. Tak samo traktowany jest błąd odczytu lub wadliwa zawartość wykryta dopiero przy tworzeniu obiektu, po wcześniejszej kontroli. Po podmianie silnik próbuje wykonać fsync katalogu; błąd tej operacji jest raportowany na poziomie ERROR, lecz nie cofa rezerwacji ani nie zatrzymuje startu. Test ut_persistentCounter::PersistentCounterTest.construction_reserves_next_value sprawdza wartość zapisaną jeszcze za życia obiektu; klasy odmowy sprawdzają ut_persistentCounter i it_env_error_exit-run.
Przepływ sterowania w procesie rotacji
Przy poprawnym zamknięciu sesji N plik danych, indeks metadanych i istniejące pliki cienia otrzymują ten sam przyrostek .oldN. Diagram przedstawia kolejność archiwizacji magazynu dyskowego; magazyny MEMORY i źródła DECLARE nie uczestniczą w tej rotacji.
%% pdf-width: 100%
sequenceDiagram
    participant RQL as xretractor
    participant D as plik danych
    participant M as plik .meta
    participant Old as pliki .oldN

    Note over RQL: start sesji N, percounter = N
    Note over RQL: PersistentCounter zapisuje N+1 przed archiwizacją
    RQL->>D: otwarcie magazynu
    RQL->>M: przygotowanie indeksu
    Note over RQL: praca - zapis rekordów
    RQL->>D: dopisuje rekordy
    RQL->>M: aktualizuje indeks RLE
    Note over RQL: poprawne zamknięcie sesji
    RQL->>Old: archiwizacja .meta.shadow, jeśli istnieje
    RQL->>M: flushCurrentEntry()
    RQL->>Old: rename .meta na .meta.oldN
    RQL->>Old: destruktor akcesora - dane i cień pod .oldN
Rys. 25. Sekwencja rotacji plików - start i stop sesji
storage::~storage() wywołuje metaData::rotate(N, false): zapisuje oczekujący wpis RLE, archiwizuje indeks i odłącza go od pliku, bez tworzenia nowego roboczego .meta. Wariant storageShadow wcześniej archiwizuje istniejący .meta.shadow. Następnie destruktor akcesora rotuje dane oraz ich cień. Pliki z tym samym numerem odpowiadają tej samej sesji i pozwalają odtworzyć jej wartości oraz bity NULL.
Jeżeli przy starcie dane są puste, ale pozostał niepusty indeks po starszej wersji silnika, detectStartupState() resetuje osierocony indeks. Nie nadaje mu numeru bieżącej sesji. Dzieje się to także przy wyłączonej detekcji przerw. Archiwizacja przy zamknięciu nie jest transakcją obejmującą całą rodzinę plików; przerwanie procesu w trakcie przemianowań może pozostawić zestaw niekompletny.
Błędy rotacji i trwałość archiwów
Przemianowania danych, cienia danych, metadanych i cienia metadanych korzystają z rotateStorageFile. Po udanym rename silnik wykonuje fsync katalogu zawierającego plik; jeśli katalogi źródłowy i docelowy są różne, próbuje zsynchronizować oba. Błąd sprawdzenia ścieżki, przemianowania, otwarcia katalogu, fsync lub zamknięcia deskryptora jest raportowany na poziomie ERROR, także w Release, ze ścieżką i przyczyną. Nadpisanie istniejącego archiwum również pozostawia komunikat ERROR, ale nie jest blokowane: poprzednia treść zostaje utracona.
Synchronizacja katalogu utrwala wpisy nazw plików. Nie zastępuje fsync treści archiwizowanego pliku i nie zapewnia transakcji obejmującej cały zestaw danych oraz metadanych. Jeśli przemianowanie się udało, a późniejsza synchronizacja katalogu zawiodła, silnik nie cofa przemianowania. Po awarii należy sprawdzić kompletność archiwów i diagnostykę rotacji, niezależnie od wartości licznika.
Nieudana rotacja metadanych nie resetuje niezarchiwizowanego indeksu. Przy reopen=true, czyli przygotowaniu do dalszego zapisu, zwraca Result z błędem Errc::IO zamiast utworzyć pozornie poprawny pusty indeks. Zamykanie magazynu używa reopen=false: odłącza persystencję i zwraca sukces, a diagnostyka rotacji pozostaje w logu. Jeżeli cień metadanych pozostał pod aktywną nazwą po nieudanej rotacji, główny indeks również pozostaje pod aktywną nazwą; jeśli cień został przemianowany, a zawiodła tylko synchronizacja katalogu, główny indeks może zostać zarchiwizowany. Błędy w destruktorach nie zmieniają same przez się kodu wyjścia procesu, więc poprawny kod zakończenia nie potwierdza kompletnej rotacji. Kolejność operacji, diagnostykę i ścieżki błędów sprawdza ut_storageRotation.
Co trafia do plików .old<N>
| Plik | Kiedy powstaje |
|---|---|
<name>.oldN | Zamknięcie sesji N - akcesor przemianowuje plik danych |
<name>.shadow.oldN | Zamknięcie sesji N - akcesor z cieniem przemianowuje istniejący plik cienia danych |
<name>.meta.oldN | Zamknięcie sesji N - indeks zapisuje oczekujący wpis i przemianowuje plik metadanych |
<name>.meta.shadow.oldN | Zamknięcie sesji N - storageShadow archiwizuje istniejący cień metadanych |
Sekcja ROTATED FILES narzędzia xtrdb -s grupuje pliki według numeru przyrostka. Dla archiwów utworzonych po poprawce #322 para .oldN i .meta.oldN należy do tej samej sesji. Starsze archiwa nie są automatycznie przenumerowywane: mogą zachowywać dawną rozbieżność o jedną sesję i wymagają sprawdzenia pochodzenia przed analizą.
Przykład sekwencji trzech sesji
Po trzech zakończonych sesjach (0, 1, 2) i po rozpoczęciu zapisu w czwartej (3), przykładowy zestaw bez plików cienia wygląda tak:
pomiar.old0         - dane z sesji 0
pomiar.meta.old0    - metadane z sesji 0
pomiar.old1         - dane z sesji 1
pomiar.meta.old1    - metadane z sesji 1
pomiar.old2         - dane z sesji 2
pomiar.meta.old2    - metadane z sesji 2
pomiar             - dane bieżące (sesja 3)
pomiar.meta        - metadane bieżące (sesja 3)
xtrdb -s pomiar grupuje archiwa w grupach [0], [1] i [2]. Grupa [3] powstanie dopiero przy zamknięciu bieżącej sesji. Przykład pokazuje nazwy i ich znaczenie, bez zakładania stałych rozmiarów plików.
Otwieranie pliku rotowanego w xtrdb
Pliki rotowane można analizować poleceniem open w trybie interaktywnym xtrdb. Polecenie open automatycznie wyciąga nazwę bazową (usuwa .old<N>) i szuka deskryptora <nazwa_bazowa>.desc:
$ xtrdb
. open pomiar.old1
ok
. print
...
Narzędzie inspekcji: xtrdb -s
Polecenie xtrdb -s <ścieżka> wyświetla kompletny obraz stanu składowania artefaktu - bez otwierania procesu xretractor, bez wchodzenia w tryb interaktywny. Wystarczy wskazać ścieżkę bazową (bez rozszerzenia), a narzędzie samo znajdzie powiązane pliki: .desc, dane binarne, .meta, .shadow, segmenty cykliczne i pliki rotowane.
NOTE: Opisana funkcjonalność ma pokrycie w teście:
issue153_storagemap_meta_casesopisanym w załączniku pt. Testy Integracyjne.
Cel i zastosowanie
| Sytuacja | Co daje xtrdb -s |
|---|---|
| Diagnoza po awarii | Widać od razu, czy plik danych jest spójny z metadanymi - różne liczby rekordów sygnalizują problem |
| Weryfikacja retencji | Sekcja DATA TOTAL pokazuje podział na segmenty i aktualny stopień wypełnienia bufora cyklicznego |
| Kontrola modyfikacji | Sekcja SHADOW ujawnia liczbę niezatwierdzonych zmian - Updates: N to liczba wpisów w .shadow; w normalnej pracy to stan docelowy, bo silnik nie wywołuje merge() samodzielnie |
| Analiza jakości danych | Pasek META z symbolami =, -, ~, X pokazuje wzorzec null i przerwy bez parsowania pliku binarnego |
| Audyt historii rotacji | Sekcja ROTATED FILES wymienia stare wersje pliku po kolejnych rotacjach |
Polecenie jest tylko do odczytu - nie modyfikuje żadnego pliku. Można je uruchamiać również gdy xretractor nie działa.
Co pokazuje mapa
Cały raport otoczony jest ramką z znaków pseudograficznych. Górna część to trzyelementowa mapa poglądowa:
┌──────────────────────────────────────────────────────────────┐
│   Storage map: <nazwa>                                       │
├──────────────────────────────────────────────────────────────┤
│ [shadow]   │ [binary data] │ [meta index]                    │
├────────────┼───────────────┼─────────────────────────────────┤
│ ...        │ ...           │ ...                             │
├────────────┴───────────────┴─────────────────────────────────┤
│   SEKCJA  ...                                                │
└──────────────────────────────────────────────────────────────┘
Każdy wiersz mapy odpowiada jednemu segmentowi RLE lub segmentowi danych:
| Kolumna | Zawartość |
|---|---|
[shadow] | Dla artefaktu bez retencji: liczba niezapisanych modyfikacji (N updates). Dla retencji segmentowej: etykieta segmentu sN z liczbą modyfikacji. |
[binary data] | Zakres indeksów rekordów w pliku binarnym (begin-end) lub etykieta segmentu sN begin-end. Wiersze z przerwą w transmisji (gap) mają puste pole. |
[meta index] | Opis segmentu RLE z pliku .meta: liczba rekordów i wzorzec null w formie [====]. |
Poniżej mapy następują kolejne sekcje:
| Sekcja | Opis |
|---|---|
DESCRIPTOR | Ścieżka i rozmiar pliku .desc, lista pól z typami i rozmiarami, rozmiar rekordu w bajtach. |
DATA | Liczba rekordów, ścieżka do pliku danych. Przy retencji (RETENTION): podział na segmenty, polityka (liczba segmentów i pojemność), maksymalny dopuszczalny rozmiar bufora, lista plików _segment_*. |
META | Liczba segmentów RLE i rekordów w indeksie, graficzny pasek obrazujący wzorzec null w czasie. |
SHADOW | Ścieżka i rozmiar pliku cienia oraz liczba niezatwierdzonych modyfikacji. |
ROTATED FILES | Pliki z poprzednich rotacji (.old1, .old2, …) wraz z rozmiarami. |
Legenda paska META
[====] - dane bez wartości null
[----] - częściowe null (przynajmniej jedno pole ma wartość null)
[~~~~] - wszystkie pola mają wartość null (nullfill)
[XXXX] - przerwa w transmisji (gap)
Przykład 1 - artefakt prosty
Strumień pomiar z dwoma polami, 100 rekordów, bez modyfikacji, bez przerw:
{
  INTEGER  ts
  FLOAT    value
  TYPE     DEFAULT
}
$ xtrdb -s pomiar
┌──────────────────────────────────────────────────────────────┐
│   Storage map: pomiar                                        │
├──────────────────────────────────────────────────────────────┤
│ [shadow]   │ [binary data] │ [meta index]                    │
├────────────┼───────────────┼─────────────────────────────────┤
│            │ 0-100         │ [====] 100 records, no nulls    │
├────────────┴───────────────┴─────────────────────────────────┤
│   DESCRIPTOR  pomiar.desc                               43 B │
│   INTEGER  ts                                            4 B │
│   FLOAT  value                                           4 B │
│   Record size:                                           8 B │
├──────────────────────────────────────────────────────────────┤
│   DATA        pomiar                                   800 B │
│   Records: 100                                               │
├──────────────────────────────────────────────────────────────┤
│   META        pomiar.meta                               26 B │
│   Segments: 1   Records: 100                                 │
│   [==========================100===========================] │
│   Legend: [====] data  [----] partial null                   │
│           [~~~~] nullfill  [XXXX] gap                        │
├──────────────────────────────────────────────────────────────┤
│   SHADOW      pomiar.shadow (missing)                    0 B │
└──────────────────────────────────────────────────────────────┘
Interpretacja: jeden segment RLE, brak przerw, brak null, plik cienia nieobecny. Plik binarny ma dokładnie 100 × 8 = 800 bajtów.
Przykład 2 - artefakt z przerwą w transmisji i modyfikacją
Strumień czujnik z trzema polami. Po 50 rekordach nastąpiła przerwa (10 jednostek interwału), następnie napłynęło 30 rekordów z częściowymi brakami w polu pressure. Dwa rekordy zostały później zmodyfikowane (plik cienia obecny):
{
  INTEGER  ts
  FLOAT    temp
  FLOAT    pressure
  TYPE     DEFAULT
}
$ xtrdb -s czujnik
┌──────────────────────────────────────────────────────────────┐
│   Storage map: czujnik                                       │
├──────────────────────────────────────────────────────────────┤
│ [shadow]   │ [binary data] │ [meta index]                    │
├────────────┼───────────────┼─────────────────────────────────┤
│            │ 0-50          │ [====] 50 records, no nulls     │
│            │               │ [XXXX] 10 records, gap          │
│ 2 updates  │ 50-80         │ [----] 30 records, some nulls   │
├────────────┴───────────────┴─────────────────────────────────┤
│   DESCRIPTOR  czujnik.desc                              52 B │
│   INTEGER  ts                                            4 B │
│   FLOAT  temp                                            4 B │
│   FLOAT  pressure                                        4 B │
│   Record size:                                          12 B │
├──────────────────────────────────────────────────────────────┤
│   DATA        czujnik                                  960 B │
│   Records: 80                                                │
├──────────────────────────────────────────────────────────────┤
│   META        czujnik.meta                              60 B │
│   Segments: 3   Records: 80                                  │
│   [===========50===========][XXgap:10XX][-------30---------] │
│   Legend: [====] data  [----] partial null                   │
│           [~~~~] nullfill  [XXXX] gap                        │
├──────────────────────────────────────────────────────────────┤
│   SHADOW      czujnik.shadow                            26 B │
│   Updates: 2                                                 │
└──────────────────────────────────────────────────────────────┘
Interpretacja: plik binarny zawiera 80 rekordów (gap nie zajmuje miejsca w pliku danych), przerwa jest zakodowana wyłącznie w .meta. Kolumna [binary data] pokazuje pusty zakres dla segmentu gapowego - danych binarnych nie ma. Pole pressure w rekordach 50–79 ma wartości null w niektórych polach ([----]).
Przykład 3 - artefakt z retencją segmentową
Strumień bufor z retencją cykliczną: maksymalnie 10 segmentów po 100 rekordów (łącznie 1000 rekordów). Aktualnie zapisano 280 rekordów w trzech segmentach:
{
  DOUBLE   value
  TYPE     DEFAULT
  RETENTION 1000 100
}
$ xtrdb -s bufor
┌──────────────────────────────────────────────────────────────┐
│   Storage map: bufor                                         │
├──────────────────────────────────────────────────────────────┤
│ [shadow]   │ [binary data] │ [meta index]                    │
├────────────┼───────────────┼─────────────────────────────────┤
│ s0         │ s0 0-100      │ [====] 100 records, no nulls    │
│ s1         │ s1 100-200    │ [====] 100 records, no nulls    │
│ s2         │ s2 200-280    │ [====] 80 records, no nulls     │
├────────────┴───────────────┴─────────────────────────────────┤
│   DESCRIPTOR  bufor.desc                                48 B │
│   DOUBLE  value                                          8 B │
│   Record size:                                           8 B │
├──────────────────────────────────────────────────────────────┤
│   DATA TOTAL  rec=280 src=0 seg=280                   2240 B │
│   Records: 280                                               │
│   Source: bufor   Segments: bufor_segment_*                  │
│   Segmented data (RETENTION): 3                              │
│   Policy: segments=10 capacity=100                           │
│   Retention cap records: 1000                                │
│   Retention cap bytes: 8000                                  │
│   Total records: 280                                         │
│     current=0  segments=280                                  │
│   Total bytes: 2240                                          │
│     current=0  segments=2240                                 │
│     [0] bufor_segment_0 rec:100 range:0-100                  │
│     [1] bufor_segment_1 rec:100 range:100-200                │
│     [2] bufor_segment_2 rec:80 range:200-280                 │
├──────────────────────────────────────────────────────────────┤
│   META        bufor.meta                                26 B │
│   Segments: 1   Records: 280                                 │
│   [=========================280===========================]  │
│   Legend: [====] data  [----] partial null                   │
│           [~~~~] nullfill  [XXXX] gap                        │
├──────────────────────────────────────────────────────────────┤
│   SHADOW      bufor.shadow (missing)                     0 B │
└──────────────────────────────────────────────────────────────┘
Interpretacja: kolumna [binary data] pokazuje każdy segment z etykietą sN i zakresem indeksów globalnych. Sekcja DATA TOTAL zawiera pełne zestawienie: src=0 (brak rekordów poza segmentami), seg=280 (wszystkie rekordy w segmentach). Przy wypełnieniu bufora (10 segmentów × 100 = 1000 rekordów) najstarszy segment zostanie usunięty, a nowy dopisany.
Podsumowanie: uzasadnienie przyjętej struktury
Rozdział zbiera wnioski z wszystkich części dokumentacji formatu zapisu danych i wyjaśnia, dlaczego przyjęta struktura plików jest minimalna i wystarczająca dla systemu rejestracji serii czasowych działającego w czasie rzeczywistym.
Zestaw plików i typy akcesorów
Każdy artefakt lub substrat składa się z maksymalnie pięciu plików - plik danych binarnych, deskryptor .desc, indeks .meta, plik cienia danych .shadow i plik cienia indeksu .meta.shadow. Dwa ostatnie tworzą parę: cień danych zachowuje oryginalną zarejestrowaną treść, a cień indeksu - odpowiadające jej wzorce null, dzięki czemu korekta rekordu nie rozspójnia danych z metadanymi. Pole TYPE w deskryptorze wybiera implementację FileInterface: DEFAULT (dane + cień + retencja), MEMORY (wyłącznie RAM, efemerydy), BINFILE / TEXTSOURCE / DEVICE (zewnętrzne źródła tylko do odczytu) i warianty pośrednie. Wybór akcesora następuje raz przy inicjalizacji storage - logika zapytań RQL nie zna szczegółów składowania.
Pliki artefaktu
Deskryptor (.desc) definiuje schemat rekordu w gramatyce ANTLR4: nazwy pól, typy (BYTE, INTEGER, FLOAT, DOUBLE, RATIONAL, STRING), rozmiary tablic, politykę retencji (RETENTION, RETMEMORY) i typ akcesora (TYPE). Rozmiar rekordu R to suma bajtów wszystkich pól danych - pola metadeskryptora nie zajmują miejsca w rekordzie. Deskryptor przy danych oznacza samoopisywalność: narzędzie xtrdb lub dowolny kod może zinterpretować artefakt bez dostępu do kodu źródłowego.
Plik danych binarnych to płaska sekwencja rekordów stałej długości R bez nagłówka. Rekord i leży zawsze na offsecie i × R. Operacja append dopisuje na koniec; operacja update - przy obecnym .shadow - trafia do pliku cienia, nie nadpisuje pliku głównego.
Plik metadanych (.meta) przechowuje kompresowany RLE indeks wartości null i przerw w transmisji. Każdy wpis RLE opisuje ciąg kolejnych rekordów z identycznym wzorcem null: flagę isGap, liczbę rekordów recordCount, rozmiar bitset i sam bitset. Przerwa w transmisji (gap) istnieje wyłącznie w .meta - plik binarny jej nie rejestruje i pozostaje gęsty. Klasą zarządzającą jest rdb::metaData: buforuje bieżący segment w currentEntry_, zapisuje segment na dysk tylko przy zmianie wzorca, a stan DiskTailState (leniwe nadpisanie ostatniego wpisu na dysku) zapewnia, że rozmiar pliku nie rośnie przy ciągłym napływie jednorodnych danych. Po restarcie loadIndex() odtwarza stan i przenosi ostatni niegapowy segment z powrotem do pamięci, umożliwiając kontynuację RLE. Samo I/O pliku realizuje MetaIndexStore, a wykrywanie przerw - GapDetector.
Plik cienia (.shadow) gromadzi modyfikacje rekordów jako sekwencję wpisów (position, data). Odczyt rekordu sprawdza .shadow od końca (najnowsza modyfikacja wygrywa), przy braku wpisu czyta z pliku głównego. Usunięcie .shadow w pełni przywraca stan wyjściowy. Operacja merge() przepisuje poprawki do pliku głównego i zeruje plik cienia; jest dostępna wyłącznie przez API - ani silnik, ani xtrdb nie wywołują jej samodzielnie, więc w normalnej pracy poprawki pozostają w .shadow.
Plik cienia indeksu (.meta.shadow) jest odpowiednikiem .shadow na poziomie wzorców null. Powstaje dla magazynów utrzymujących cień danych: fabryka makeMetaIndex() wstrzykuje wtedy do storage obiekt storageShadow zamiast bazowego metaData, a ten kieruje aktualizacje do pola typu metaShadow. Bez tego pliku korekta rekordu zmieniałaby jego wzorzec null w .meta mimo że oryginalna treść nadal leży nietknięta w pliku głównym - para „dane ↔ metadane“ rozjechałaby się przy pierwszym merge() lub odrzuceniu cienia.
Mechanizm rotacji
Dyrektywa ROTATION 'rdb_counter' włącza tryb zachowania historii sesji. PersistentCounter przechowuje monotonicznie rosnący numer sesji N. Rotacja jest procesem rozłożonym w czasie: przy starcie sesji N funkcja detectStartupState() wykrywa niezgodność (plik danych pusty, .meta niepusty) i przemianowuje .meta na .meta.oldN; przy zamknięciu sesji destruktor posixBinaryFile przemianowuje plik danych na .oldN i plik cienia na .shadow.oldN. Konsekwencją tej kolejności jest przesunięcie o 1: .meta.oldN zawiera metadane sesji N−1, a .oldN - dane sesji N. Bez dyrektywy ROTATION pliki artefaktów są usuwane przy każdym starcie.
Narzędzie inspekcji xtrdb -s
Polecenie xtrdb -s <ścieżka> jest jedynym narzędziem do inspekcji stanu składowania bez uruchamiania xretractor. Raport składa się z mapy poglądowej (kolumny: shadow, binary data, meta index) i sekcji szczegółowych: DESCRIPTOR, DATA (lub DATA TOTAL przy retencji segmentowej), META z paskiem RLE, SHADOW z liczbą niezatwierdzonych modyfikacji oraz ROTATED FILES z historią rotacji. Pasek META używa czterech symboli: = (dane bez null), - (częściowe null), ~ (nullfill), X (gap). Narzędzie jest tylko do odczytu i działa gdy proces xretractor nie działa.
Porównanie podejść
| Właściwość | Surowy plik binarny | Struktura RetractorDB |
|---|---|---|
| Samoopisywalność | brak - wymaga zewnętrznej dokumentacji | tak - deskryptor .desc przy danych |
| Obsługa przerw w transmisji | brak - przerwy niewidoczne lub fikcyjne rekordy | tak - .meta rejestruje przerwy bez rozszerzania pliku danych |
| Wartości null per pole | brak - zero = null nierozróżnialne | tak - bitset null w .meta |
| Korekta danych historycznych | destruktywna | niedestruktywna - .shadow |
| Przywrócenie oryginału po korekcie | niemożliwe | tak - usunięcie .shadow |
| Wielokrotność strategii składowania | brak | tak - pole TYPE w deskryptorze |
| Koszt przy danych bez przerw i null | - | minimalny: .meta ≈ 17 B nagłówek + 1 wpis RLE |
Kompilacja i budowa planu
Proces kompilacji odbywa się przed każdym uruchomieniem procesu xretractor, o ile podano plik z sekwencją poleceń i zapytań. Argument ten jest wymagany w trybie -c (tylko kompilacja) - bez niego nie ma czego kompilować; w trybie przetwarzania jego pominięcie uruchamia tryb bezczynny, w którym etap kompilacji jest w całości pomijany. W oparciu o przepływ przedstawiony na Rys. 14 przygotowałem opis procesu Rys. 26 realizujący proces kompilacji w trybie rozwojowym. Samą kompilację można wywołać niezależnie od działających instancji. W trybie wykonania ponowne użycie tej samej nazwy instancji jest odrzucane, ale inna nazwa uruchamia osobny plan, o ile magistrala nie wykryje kolizji jego strumieni, plików magazynu lub licznika rotacji.
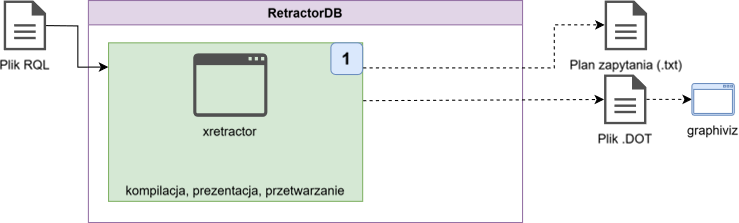
Rys. 26. Proces kompilacji
Jako przykładowy plik przeznaczony do kompilacji przyjmiemy plik query.rql o następującej zawartości:
DECLARE a INTEGER STREAM core0, 0.1 BINFILE 'datafile1.dat'

SELECT str1[0]+1 STREAM str1 FROM core0>2
Jest to bardzo prosty przykład pliku zawierającego dwie dyrektywy. Pierwsza deklaruje istnieje efemerydu w postaci źródła danych binarnych zawierającego 4-bajtowe liczby typu INTEGER. Dane z tego pliku będą czytane z szybkością 10 razy na sekundę. A nazwa tego obiektu to core0.
Drugie polecenie tworzy artefakt o nazwie str1 pobierający przesunięte w czasie od dwa odczyty czyli 0.2 sekundy dane efemeryczne. W trakcie tworzenia kolejnych elementów strumienia wynikowego dochodzi do przetwarzania danych odczytanych z core0 i do każdej odczytanej wartości dodawana jest wartość 1.
Aby przeprowadzić kompilację tego pliku należy wywołać następujące polecenie:
$ xretractor -c query.rql
Na ekranie wyświetli się następująca odpowiedź systemu:
core0(1/10)	datafile1.dat
	a: INTEGER
str1(1/10)	origin=2
	:- PUSH_STREAM(core0)
	:- STREAM_TIMEMOVE(2)
	str1_0: INTEGER
		PUSH_ID(str1[0])
		PUSH_VAL(1)
		ADD
Pominięcie parametru -c powoduje kompilację i próbę uruchomienia planu. Brak pliku źródłowego datafile1.dat zatrzymuje start błędem środowiska K4, z kodem EIO (5 na Linuksie) oraz nazwą strumienia, ścieżką i przyczyną w komunikacie. Samo -c nie wymaga obecności danych wejściowych. Start wymaga także istniejącego katalogu magazynu i poprawnych zachowanych deskryptorów; kontrole i kody odmowy opisuje xretractor.
Oprócz przeglądu tekstowego możemy obejrzeć również pliki kompilacji w postaci graficznej. Do tego celu należy wywołać następujący ciąg poleceń:
$ xretractor -c -d -f -t -s query.rql > out.dot && dot -Tsvg out.dot -o out.svg
Zakładając że w środowisku uruchomieniowym masz zainstalowany program dot z pakietu graphivz wygenerujesz tym poleceniem plik graficzny przedstawiający odpowiedź systemu w postaci grafu.
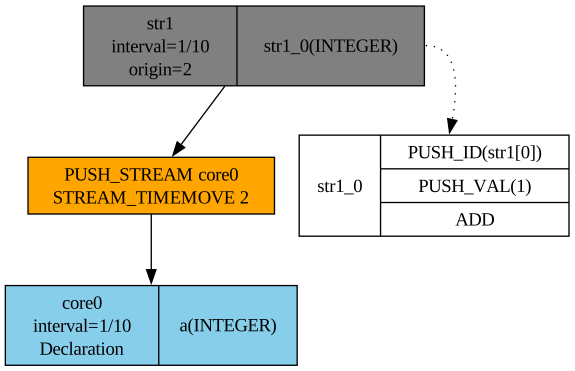
Rys. 27. Graficzna reprezentacja planu zapytania
System RetractorDB potrafi wygenerować rysunek jako odpowiedź na jeden ze zleconych ciągów przetwarzania danych. Prezentacja graficzna jest najbardziej odpowiednia w przypadku tworzenia i przedstawiania grafów przetwarzania danych. Niestety czytelność ucierpi w przypadku bardzo skomplikowanych schematów.
Na Rys. 27 widać trywialny plan realizacji zapytania jaki powstał w wyniku kompilacji dwulinijkowego pliku query.rql. U samej góry widać obiekt str1 tworzący artefakty z częstotliwością 10 rekordów na sekundę. Informacja o szybkości tworzenia artefaktów nie występuje w zapytaniu, jest wyznaczana w oparciu wyrażenie algebraiczne z klauzuli FROM w zapytaniu SELECT. Widać też w jaki sposób wytwarzane są kolejne rekordy strumienia str1. Tutaj mamy do czynienia z typowym algorytmem przetwarzania danych na stosie. Najpierw na stos odkładana jest wartość efemeryczna powstałego z wyrażenia algebraicznego a następnie umieszczana jest na stosie wartość 1. Polecenie ADD zdejmuje obie wartości ze stosu pozostawiając na stosie wynik dodawania. To co zostało na stosie – czyli wynik dodawania umieszczane jest w polu tworzonego rekordu.
Z drugiej strony widać operacje na strumieniach. Operacje na strumieniach realizowane są w innej domenie. Tam występuje przetwarzanie obiektów dwu lub jednowartościowych. Operacjom poddawane są albo dwa strumienie albo tylko jeden z argumentem. Klasyczny stos w przypadku Algebraicznych operacji strumieniowych nie ma zastosowania. Dla uproszczenia zapis przypomina trochę operacje na stosie. Widzimy w załączonym przykładzie że operacje na danych bieżących realizujemy poprzez przesunięcie danych w czasie o 2. Celowo nie mówię że to 2 sekundy – tutaj 2 oznacza wartość relatywną względem szybkości napływu. W przypadku szybkości napływu 10 próbek na sekundę – wartość 2 oznacza przesunięcie w czasie o 0.2 sekundy.
Skomplikowane wyrażenia algebraiczne w których biorą udział co najmniej dwa operatory strumieniowe powodują powstanie wspominanych w poprzednich rozdziałach substratów. Każde zapytanie, które zawiera wyrażenia algebraiczne w klauzuli from z więcej niż jednym operatorem są rozbijane na operacje dwuargumentowe, zależne od siebie. Lista argumentów substratu to domyślnie pełne rozwinięcie schematu.
Dostępne flagi xretractor
W trybie kompilacji (-c) i w trybie wykonania dostępne są różne zestawy flag. Poniżej flagi trybu kompilacji używane przy generowaniu grafów:
| Flaga | Pełna nazwa | Znaczenie |
|---|---|---|
-c | --onlycompile | tylko kompilacja - nie uruchamia przetwarzania |
-d | --dot | generuj wyjście w formacie DOT (graphviz) |
-f | --fields | pokaż pola strumieni w grafie DOT |
-t | --tags | pokaż programy poszczególnych pól (-f) |
-s | --streamprogs | pokaż programy strumieni w grafie DOT |
-u | --rules | pokaż reguły RULE w grafie DOT |
-p | --transparent | przezroczyste tło grafu DOT |
-i | --hideruleprog | ukryj program warunku reguły (z -u) |
-m | --csv | wyjście w formacie CSV |
Flagi trybu wykonania (bez -c):
| Flaga | Pełna nazwa | Znaczenie |
|---|---|---|
-m N | --llimitqry N | uruchom N cykli przetwarzania, potem zakończ |
-k | --noanykey | nie czekaj na klawisz - tryb daemon/skrypt |
-t | --realtime | tryb czasu rzeczywistego (SCHED_FIFO, mlockall) |
-x | --xqrywait | czekaj na obsłużenie pierwszego polecenia xqry przed startem |
-s | --status | sprawdź czy instancja xretractor już działa |
-v | --verbose | wyświetl parametry strumieni przy starcie |
-j | --service | tryb usługowy - dziennik na stderr (journald) |
-g F | --config F | plik konfiguracyjny TOML zamiast wyszukiwania |
-b | --build-info | wypisz konfigurację optymalizatora i zakończ |
ℹ️ Info
Parametr
-m Nliczy iteracje pętli głównej, nie sekundy. Dla strumieni z interwałem 0.1 s (10 Hz),-m 10oznacza ~1 sekundę przetwarzania.
⚠️ Ostrzeżenie
Przy odbiorze wyników ograniczonego przebiegu
-m Nprzezxqrydodaj-x(--xqrywait). Bez tej flagi serwer może przetworzyć cały budżet, zanim klient zdąży się podłączyć. Bramka opada po obsłużeniu pierwszego polecenia:xqry --selectrejestruje wtedy subskrypcję przed rozpoczęciem obliczeń. Także--dirlub--helloinnego klienta zwalnia bramkę, więc nie jest ona barierą gotowości wszystkich odbiorców. Przy analizie artefaktów po zakończeniu procesu-xnie jest potrzebne i bez komendy klienta wstrzyma przebieg.
Pełna lista wszystkich opcji z opisem każdej z nich - w tym opcja --realtime wymagająca uprawnień systemowych - znajduje się w Załączniku A.
Przetwarzanie i dystrybucja danych
W przypadku rozpoczęcia procesu przetwarzania danych analizując przedstawiony na Rys. 14 można wydzielić następujący schemat przepływu - Rys. 28:

Rys. 28. Schemat przepływu sterowania w procesie przetwarzania
Do przeprowadzania procesu przetwarzania potrzebne będzie przygotowanie danych i zbudowanie ciągu przetwarzającego dane. W ramach tego ciągu na wejściu użyjemy przygotowanego pliku z planem realizacji zapytania, przygotujemy plik binarny z danymi. Zbudujemy proces przetwarzający dane i prezentujący wyniki.
Źródłowy plik danych query.rql zmienimy na następujący:
DECLARE a INTEGER STREAM core0, 0.1 TEXTFILE 'datafile1.txt'
DECLARE a BYTE STREAM core1, 0.2 DEVICE '/dev/urandom'

SELECT str1[0], str1[0] + str1[1]/20 STREAM str1 FROM core0 + core1
W tym przykładzie deklarujemy istnienie pliku tekstowego zawierającego dane tekstowe. Proponuję wypełnić plik datafile1.txt następującą zawartością:
$ seq 20 28 > datafile1.txt
20
21
22
23
24
25
26
27
28
Plik będzie zawierać kolejne liczby od 20 do 28.
Rzut okna na plan realizacji zapytania przedstawi obraz na Rys. 29:
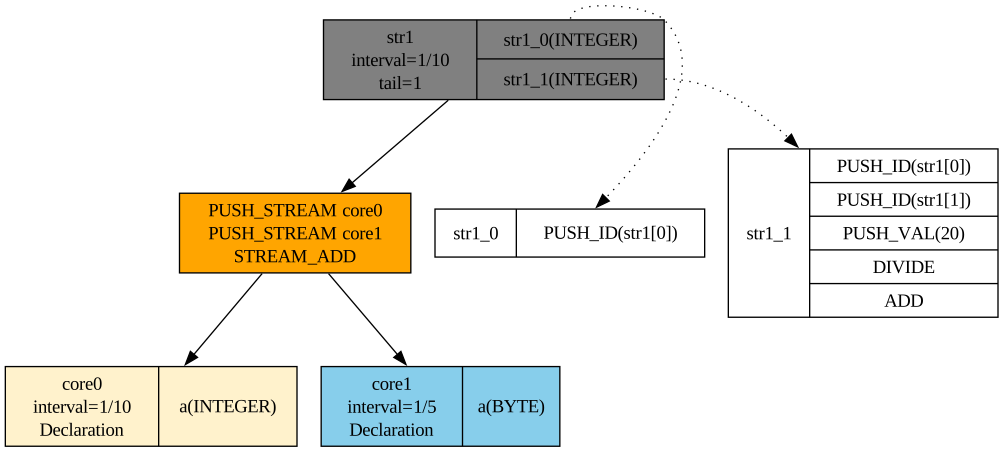
Rys. 29. Graficzna reprezentacja planu realizacji zapytania 2
Jeśli przygotowaliśmy plik z danymi możemy uruchomić proces kompilacji i przetwarzania danych. Realizujemy to wydając następujące polecenie:
$ xretractor query.rql
I tu pojawia się istotna właściwość opracowanego systemu. System powinien rozpocząć natychmiast realizację procesu. Dowolny klawisz naciśnięty w terminalu przerwie ten proces.
Proponuję uruchomić drugie okno terminala i tam kontynuować sesję. W drugim oknie terminala możemy wydać następujące polecenie:
$ xqry -d
name  | duration | size | count | location      | cap
------+----------+------+-------+---------------+----
str1  | 1/10     | 6912 | 864   |               | 0
core0 | 1/10     | -1   | 49    | datafile1.txt | 1
core1 | 1/5      | -1   | 25    | /dev/urandom  | 1
Powinno się pojawić coś podobnego. Oczywiście liczniki danych przy str1 powinny się różnić. Logicznym jest że za każdym odczytem otrzymamy większe wartości dotyczące rozmiaru zgromadzonego strumienia str1.
Jeśli chcemy na ekranie zobaczyć co tam się właśnie dzieje wewnątrz procesu przetwarzania danych proponuję wydać poniższe polecenie i po kilku wierszach na ekranie nacisnąć dowolny klawisz aby przerwać ten proces:
$ xqry -s str1
20 26
21 33
22 34
23 27
24 28
25 35
26 36
27 28
Pierwsza kolumna zawiera sekwencję liczb – taką jaką wpisaliśmy do pliku datafile1.txt. Druga kolumna zawiera efekt przetwarzania. Dodawana jest wartość pobrana z generatora liczb pseudolosowych podzielona przez 20 – druga kolumna opływa dane poniżej kolumny pierwszej.
Jak można to zobaczyć w formie graficznej? Proponuję wydać następujące polecenie:
$ xqry -s str1 -p 50,50 | gnuplot
Na ekranie pojawi się następujące okno z płynącymi na bieżąco danymi:
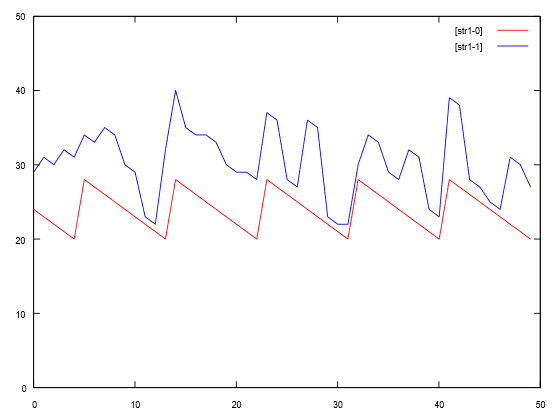
Rys. 30. Zrzut zawartości okna gnuplot przedstawiający dane napływające
Na Rys. 30 widzimy to co dane przedstawiały w postaci numerycznej. Kształt piły to pierwsza kolumna, nieregularny kształt opływający kształt piły to druga kolumna. Rysunek przedstawia dane statyczne – w oknie jednak dane te napływają i rysunek jest aktualizowany na bieżąco.
Typowym pomysłem na wysłanie danych poza system na którym funkcjonuje xretractor i xqry jest użycie polecenia:
$ xqry -s str1 | nc -l 8888
na drugim komputerze trzeba napisać:
$ nc nazwa_serwera_lub_jego_ip 8888
ℹ️ Info
Flaga
-pw netcat (składnia BSD) nie jest obsługiwana przez GNU netcat dostępny na współczesnych systemach Ubuntu/Debian. Poprawna składnia tonc -l 8888(bez-p).
Transmisja danych odbędzie się przez sieć.
Jeśli chcemy zakończyć proces xretractor za pomocą polecenia xqry możemy wydać następujące polecenie:
$ xqry -k
Po wydaniu tego polecenia proces xretractor zakończy swoje działanie i przerwie przetwarzane planów realizacji zapytań.
Zapis procesu prezentowany na ekranie (Rys. 31) przedstawia się następująco:
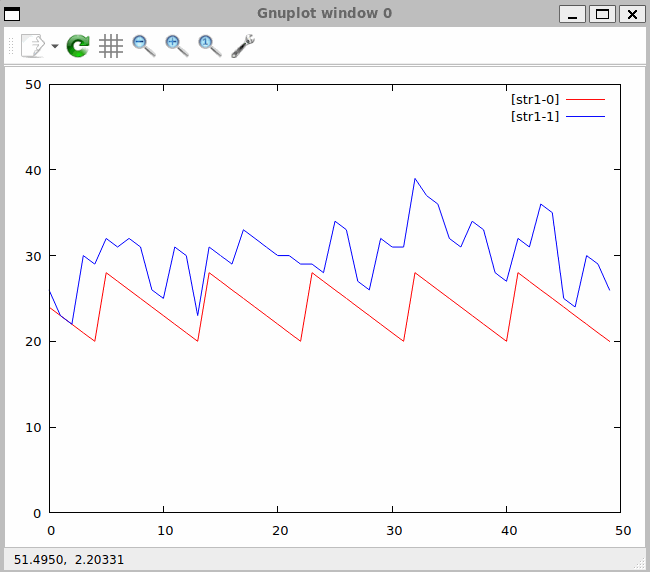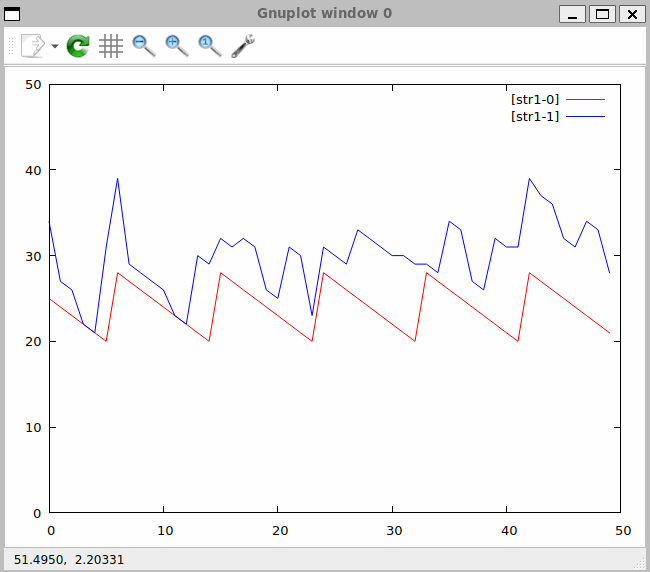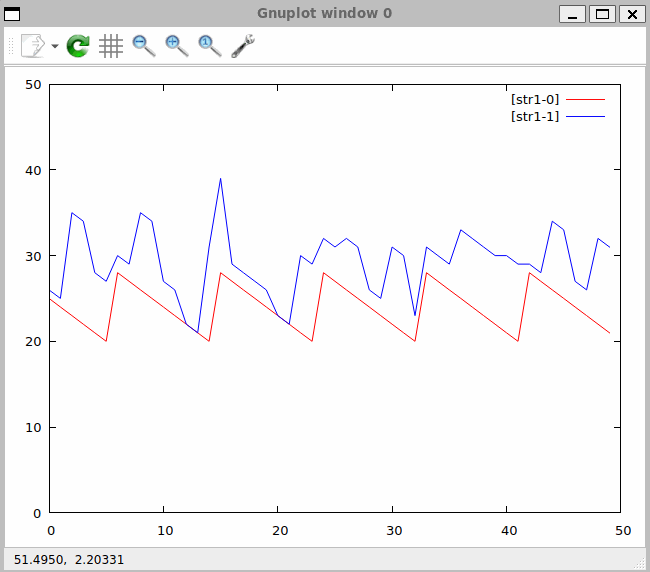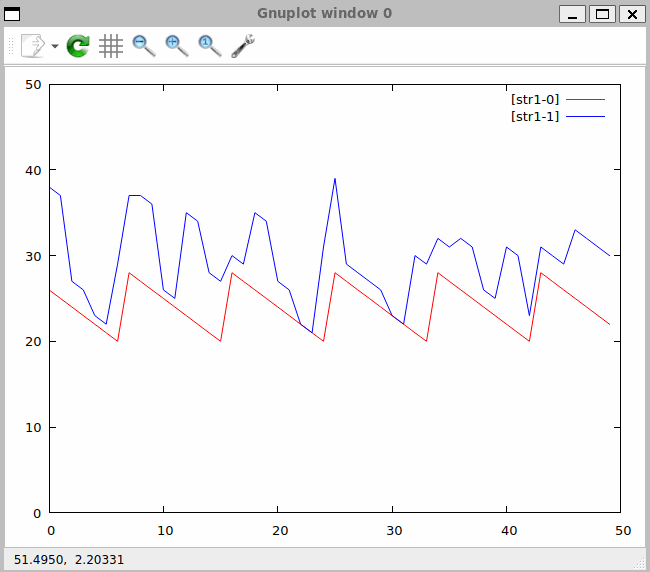
Rys. 31. Zapis procesu przetwarzania danych w czasie rzeczywistym
Analiza artefaktów
Analizując szerzej potencjalne ścieżki danych na Rys. 14 ostatnią nieopisaną ścieżką jest ścieżka w której bierze udział narzędzie xtrdb.
W trakcie tworzenia systemu potrzebowałem narzędzia umożliwiającego dostęp do artefaktów w celu przeprowadzenia testów integracyjnych. W celu weryfikacji poprawności musiałem porównać wyniki przetwarzania na różnych etapach. Na Rys. 32 przedstawiono kompletny przepływ danych uwzględniający rolę narzędzia xtrdb.

Rys. 32. Przepływ danych w analizie artefaktów
W celu przedstawienia procesu analizy artefaktów konieczne jest uwzględnienie całego ciągu przetwarzania. Użyjemy tego samego zapytania co poprzednio. Uruchomimy jednak nasz proces przetwarzania danych w trochę inny sposób.
$ xretractor -m 10 query.rql
Tak wywołany proces przetwarzania zapytań zakończy swoją pracę po 10 cyklach przetwarzania. Parametr -m określa liczbę iteracji pętli głównej, nie liczbę sekund - czas działania zależy od interwału strumieni źródłowych. Dla strumieni z interwałem 0.1 s (10 Hz) oznacza to ~1 sekundę działania. Po zakończeniu działania i przejrzeniu katalogu w którym realizowaliśmy zapytanie powinniśmy zobaczyć następujące pliki:
$ ls -al
total 32
drwxr-xr-x  2 michal michal 4096 Oct  4 18:01 .
drwxr-xr-x 10 michal michal 4096 Oct  4 17:59 ..
-rw-r--r--  1 michal michal   51 Oct  4 18:01 core0.desc
-rw-r--r--  1 michal michal   43 Oct  4 18:01 core1.desc
-rw-r--r--  1 michal michal   27 Oct  4 17:59 datafile1.txt
-rw-r--r--  1 michal michal  180 Oct  4 18:00 query.rql
-rw-r--r--  1 michal michal   72 Oct  4 18:01 str1
-rw-r--r--  1 michal michal   34 Oct  4 18:01 str1.desc
Jak widać powstały trzy pliki .desc i jeden plik z artefaktami. Jeśli zajrzymy do pliku str1 to zobaczymy bardzo skromną zawartość:
$ hexdump str1
0000000 0014 0000 0015 0000 0015 0000 0016 0000
0000010 0016 0000 0017 0000 0017 0000 0018 0000
0000020 0018 0000 0019 0000 0019 0000 001a 0000
0000030 001a 0000 001b 0000 001b 0000 001c 0000
0000040 001c 0000 001d 0000
0000048
Wraz z plikiem artefaktu powstają pliki metadanych. Ich zawartość informuje o strukturze pliku.
$ cat str1.desc
{       INTEGER str1_0
        INTEGER str1_1
}
O wiele ciekawsze są opisy plików efemerydów. Pliki opisu danych efemerycznych wskazują na pliki w systemie Linux.
$ cat core0.desc
{       INTEGER a
        REF "datafile1.txt"
        TYPE TEXTSOURCE
}
$ cat core1.desc
{       BYTE a
        REF "/dev/urandom"
        TYPE DEVICE
}
Pliki opisu metadanych są tworzone automatycznie w momencie zarejestrowania w systemie RetractorDB obiektu. Należy pamiętać aby usunąć te deskryptory w przypadku zmodyfikowania pliku query.rql
Po uruchomieniu programu xtrdb w terminalu narzędzie wyświetli znak zachęty w postaci kropki (.). Znak ten to wyłącznie prompt - nie jest częścią polecenia. Można od razu rozpocząć komunikację z tym narzędziem. Przykład sesji:
$ xtrdb
.open str1
ok
.desc
{       INTEGER str1_0
        INTEGER str1_1
}
.list 1
{ str1_0:20 str1_1:21 }
.quit
Praca z tym narzędziem przypomina pracę z klasyczną, starą bazą danych dbase. Nie mamy tu jednak maszyny stanów, pętli czy warunków. Tylko odczyt i modyfikacje plików binarnych opisanych metadanymi.
Głównym celem tego narzędzia było wsparcie przy tworzeniu skryptów testowych. RetractorDB jest deterministyczny. W systemie nie występuje zjawisko wyścigu – dane, które trafią na wejście – zawsze powinny dać te same wyniki na wyjściu. Chyba że zmieszamy wyniki z danymi przypadkowymi jak w przedstawionym przykładzie.
NOTE: Opisana funkcjonalność ma pokrycie w testach:
issue113_meta_xtrdb,issue113_meta,issue113_null_txtsrc,Pattern5opisanych w załączniku pt. Testy Integracyjne.
Bardzo użyteczną funkcją w tym narzędziu jest funkcja list oraz rlist. Listująca początkowe elementy pliku lub końcowe elementy pliku - uwzględniając strukturę opisaną w metadanych.
.list 4
{ str1_0:20 str1_1:21 }
{ str1_0:21 str1_1:22 }
{ str1_0:22 str1_1:23 }
{ str1_0:23 str1_1:24 }
.rlist 4
{ str1_0:28 str1_1:29 }
{ str1_0:27 str1_1:28 }
{ str1_0:26 str1_1:27 }
{ str1_0:25 str1_1:26 }
Zachęcam do eksperymentów i przejrzenia źródeł tego narzędzia. Jest to jeden z mniej skomplikowanych a bardzo użytecznych elementów systemu RetractorDB.
Inspekcja metadanych null/gap
Każdy artefakt ma skojarzony plik indeksu .meta opisany szczegółowo w rozdziale dotyczącym formatu zapisu. Zawartość tego pliku można obejrzeć bezpośrednio w xtrdb poleceniem meta:
.open str1
ok
.meta
record 0: count=9 gap=false nullBitset=00
Wpis gap=false oznacza brak przerwy w danych, nullBitset informuje które pola zawierają wartości null (po jednym bicie na pole). Dane bez żadnych braków tworzą jeden wpis count=N gdzie N to łączna liczba rekordów.
Podsumowanie
W podsumowaniu należy wskazać na przekazy w rozdziale zakres wiedzy. Tutaj chciałem przedstawić jak poszczególne elementy systemu możemy uruchamiać, jak wyglądają ciągi poleceń w oparciu o które budujemy dalsze funkcjonalności z wykorzystaniem systemu RetractorDB.
Starałem się zredukować ilość potencjalnych poleceń do minimum. Na chwile obecną efektywnie zredukowałem zbiór do 3 poleceń. Wydaje mi się tak zaprojektowany system będzie maksymalnie użyteczny i w miarę efektywny. Osobną kwestią jest komplikacja. Samo tłumaczenie procesu przetwarzania, nowej algebry i dlaczego znak plus nie oznacza plus – jest problematyczne. Mam jednak nadzieję że po przeskoczeniu pewnej bariery poznania – reszta będzie oczywista. Podjęte decyzje były efektem przemyśleń, prób i błędów. Chcę podkreślić że zwyczajnie po ludzku nie znalazłem lepszej metody.
Kompilacja zapytań
Uważny czytelnik zauważy zapewne, że w przedstawionych w poprzednim rozdziale skompilowanych planach realizacji zapytań pewne wartości nie odpowiadają temu, co zostało napisane w zapytaniu.
Kompilator prowadząc proces budowania planu zapytania prowadzi proces autonomicznie. Wydaje się czasem, że prosząc o jedno - dostaje się coś innego – na pierwszy rzut oka jest to zachowanie zupełnie nieoczywiste. I jako użytkownik nie mam zasadniczo na to wpływu. Co ciekawe efekt zapytania odpowiada temu o co prosiłem w zapytaniu. Być może poprawny tytuł tego rozdziału powinien brzmieć: Dlaczego kompilator robi po swojemu i do tego wie lepiej?
W tym rozdziale chcę wyjaśnić, jak rozwiązałem problemy syntaktyczne, które napotkałem w trakcie tworzenia języka zapytań.
Wejście i wyjście kompilatora
Plik .rql
Wejście kompilatora - tekst w języku RQL zawierający instrukcje DECLARE, SELECT i RULE oraz dyrektywy konfiguracyjne (np. :STORAGE). Parser ANTLR4 czyta plik instrukcja po instrukcji.
Kolejność DECLARE i SELECT w pliku nie ma znaczenia: zapytanie może odwoływać się do strumienia zdefiniowanego niżej, bo zależności między strumieniami rozwiązuje dopiero kompilator. Wyjątkiem jest RULE - parser przypina regułę do strumienia już wczytanego, więc reguła musi stać po definicji swojego strumienia; w przeciwnym razie parser zgłasza błąd Rule '…' refers to stream '…', but no such stream is defined. Odwołanie do strumienia, którego w pliku nie ma wcale, daje kontrolowaną odmowę, np. Check result:Stream 'dst' reads from 'absent', which is not defined in the plan. xretractor -c kończy się wtedy kodem 71 na Linuksie.
Parser ANTLR4 → qTree
Parser buduje wewnętrzną reprezentację qTree - std::vector<query> - dopisując po jednym elemencie dla każdej instrukcji DECLARE, SELECT i dyrektywy konfiguracyjnej, w kolejności z pliku i bez sortowania. Element SELECT niesie schemat pól z programami stosowymi oraz program klauzuli FROM wskazujący strumienie źródłowe. Interwał czasowy (delta) jest na tym etapie znany tylko dla deklaracji DECLARE; dla zapytań SELECT wyznacza go kompilator. Szablon generatora STREAM nazwa[N] jest jeszcze jednym elementem, a reguła RULE nie tworzy własnego elementu - trafia na listę reguł swojego strumienia.
Kolejność wektora zmienia się w trakcie kompilacji: rozwiązanie interwałów sortuje go według delty, a porządek topologiczny (producent przed konsumentem) przywraca dopiero ostatni etap.
23 etapy kompilacji
qTree przechodzi przez łańcuch przekształceń: od rozbicia wyrażeń FROM na operacje dwuargumentowe, przez wyznaczenie delt i offsetów bajtowych, aż po weryfikację semantyczną i obliczenie rozmiarów buforów. Każdy etap zakłada sukces poprzedniego.
Plan wykonania → dataModel
Na wyjściu kompilacji każde zapytanie w qTree ma wyznaczone: schemat pól z typami i offsetami, deltę, rozmiary buforów oraz gotową sekwencję instrukcji. Ten plan przejmuje dataModel i realizuje go cyklicznie w czasie rzeczywistym.
Flaga -c zatrzymuje xretractor po tym kroku i drukuje plan na standardowe wyjście - bez uruchamiania przetwarzania.
Przegląd poruszonych w rozdziale tematów
Rozdział zbudowany jest zgodnie z kolejnością etapów kompilatora - od opisu struktury danych i łańcucha etapów, przez poszczególne przekształcenia, aż po obsługę błędów.
-
Opisuje cały łańcuch etapów funkcji
compiler::compile(). Kompilacja to nie jeden krok - to uporządkowana sekwencja dwudziestu trzech etapów wewnętrznej reprezentacjiqTree, od rozwinięcia generatorów i sprowadzenia wyrażeń FROM do postaci dwuargumentowej, przez wyznaczanie interwałów, kontrolę nazw substratów, uproszczenia wyrażeń i lokalizację pól, aż po weryfikację semantyczną, alokację buforów i końcowe sortowanie topologiczne. Każdy etap zakłada sukces poprzedniego, a błąd na dowolnym etapie zatrzymuje kompilację. -
Opisuje strukturę DAG powstającego w trakcie kompilacji - fundament, na którym opierają się wszystkie etapy. Korzeniami są deklaracje efemerydów (źródła zewnętrzne), wewnątrz grafu leżą substraty pośrednie, a liśćmi są artefakty. Flaga
-dgeneruje wyjście w formacie DOT, któregraphvizzamienia w wizualny graf zależności. KolejnośćDECLAREiSELECTw pliku.rqlnie ma znaczenia - graf zależności buduje kompilator; tylkoRULEmusi stać po definicji strumienia, do którego się odnosi. -
Wyjaśnia etap
extractIntermediateStreams- pierwszy krok po rozwinięciu generatorów. Gdy wyrażenie FROM zawiera więcej niż dwa argumenty (np.(core0#core1)+core2,core0+core1+core2), kompilator rozbija je na operacje dwuargumentowe i tworzy nazwane substraty. Późniejszy etapdeduplicateSubstratswykrywa, gdy substrat jest strukturalnie identyczny z zapytaniem użytkownika, i zastępuje odwołania - unikając powielania obliczeń. -
Wyjaśnia etap
expandSchemaWildcards. Symbol*w klauzuli SELECT zostaje zastąpiony pełną listą pól wynikających ze schematu strumienia źródłowego - w tym polami pochodzącymi z operacji sumy strumieni. Przykład pokazuje, jak typy pól decydują o tym, które pole trafia na które miejsce w schemacie wynikowym. -
Opisuje etap
resolveStreamIntervals. Kompilator wyznacza deltę każdego strumienia wynikowego z równań algebry strumieniowej: dla operatora+delta to minimum wejść, dla#- średnia harmoniczna, dla@(step, window)- pochodna rozmiaru okna. Algorytm działa iteracyjnie - każda runda rozwiązuje co najmniej jeden strumień, aż wszystkie delty są znane. -
Opisuje mechanizm wbudowany w etap
resolveStreamIntervals. Jeśli liczba nierozwiązanych strumieni przestaje maleć, żaden strumień nie może uzyskać delty - znak, że graf zależności zawiera cykl. Kompilacja kończy się błędem"Circular dependency in stream definitions". Rozdział zawiera przykład cyklicznego zapytania i sposób jego naprawy. -
Opisuje etapy
resolveFieldReferencesilocalizeFieldOffsets. Po sumie+do pola wynikowego można odwołać się zarówno przez indeks w schemacie sumarycznym (str1[1]), jak i przez nazwę strumienia źródłowego z lokalnym indeksem (core1[0]). Po przeplocie#składowe dzielą jeden schemat, dlatego nazwane odwołania do składowych są odrzucane; należy użyć nazwy strumienia wynikowego albo rozplotu&/%. -
Opisuje etap
expandIndexWildcards- cukier syntaktyczny do równoległych operacji na parach pól. Symbol_w indeksie powoduje powielenie formuły dla wszystkich zgodnych slotów, które wskazany strumień wnosi do rekordu całej klauzuliFROM. Dlategosrc[_] * coef[_]przyFROM src@(1,5)+coefgeneruje pięć iloczynów, mimo że samsrcjest jednopolowy. Zastosowanie: budowa zapytań filtrów sygnałowych. -
Definiuje reguły promocji typów obowiązujące przez cały łańcuch kompilacji. Wynik działania
BYTE * INTEGERma typINTEGER- kompilator wyznacza typ pola wyjściowego statycznie, zanim dane zostaną przetworzone. Opisano też kompletną hierarchię typów obsługiwanych przez RetractorDB. -
Zbiera w jednym miejscu narzędzia diagnostyczne: flaga
-cdo inspekcji planu, pipeline-c -d -f -sdo wizualizacji grafu przezgraphviz, tablicę znaczeń instrukcji planu (PUSH_ID, PUSH_STREAM, STREAM_ADD, …) oraz katalog typowych błędów kompilacji z ich przyczynami i sposobem naprawy.
Przebiegi kompilacji
Kompilacja zapytań w RetractorDB przebiega w wielu etapach. Każdy etap transformuje wewnętrzną reprezentację zapytań - drzewo qTree - i przekazuje wynik do następnego. Kolejność jest ściśle ustalona: każdy etap zakłada, że poprzedni zakończył się sukcesem.
qTree to std::vector<query> - centralna struktura danych kompilatora i executora. Każdy element wektora odpowiada jednemu zapytaniu (SELECT lub DECLARE) i przechowuje jego schemat pól, sekwencję instrukcji stosu, interwał czasowy, ogon startowy oraz referencje do strumieni źródłowych. Nie każdy etap utrzymuje kolejność wektora: rozwiązanie interwałów sortuje go według rInterval. Dlatego kompilacja kończy się bezwarunkowym sortowaniem topologicznym, które gwarantuje, że podczas wykonania producent poprzedza konsumenta.
Przykład śledzący
Przez cały rozdział śledzimy jedno zapytanie - query.rql - przez kolejne etapy:
DECLARE a BYTE, b INTEGER STREAM core0, 0.1 TEXTFILE 'sensor_a.txt'
DECLARE c INTEGER, d FLOAT STREAM core1, 0.2 TEXTFILE 'sensor_b.txt'
DECLARE e INTEGER STREAM core2, 0.3 TEXTFILE 'sensor_c.txt'

SELECT *                    STREAM merged FROM core0 + core1
SELECT merged[0], merged[2] STREAM result FROM merged
Po przejściu przez wszystkie etapy xretractor -c query.rql drukuje:
core0(1/10)	sensor_a.txt
	a: BYTE
	b: INTEGER
core1(1/5)	sensor_b.txt
	c: INTEGER
	d: FLOAT
merged(1/10)	tail=1
	:- PUSH_STREAM(core0)
	:- PUSH_STREAM(core1)
	:- STREAM_ADD
	core0_0: BYTE
		PUSH_ID(merged[0])
	core0_1: INTEGER
		PUSH_ID(merged[1])
	core1_2: INTEGER
		PUSH_ID(merged[2])
	core1_3: FLOAT
		PUSH_ID(merged[3])
result(1/10)	tail=1
	:- PUSH_STREAM(merged)
	result_0: BYTE
		PUSH_ID(result[0])
	result_1: INTEGER
		PUSH_ID(result[2])
core2(3/10)	sensor_c.txt
	e: INTEGER
Plan jest wydrukowany w końcowym porządku topologicznym: deklaracje core0 i core1 poprzedzają swojego konsumenta merged, a ten - zapytanie result. Nieużywana deklaracja core2 trafia na koniec. tail=1 to ogon startowy wyznaczony przez computeStartupLatency. Odwołania PUSH_ID wskazują pozycje w rekordzie wejściowym zapytania, zapisane pod jego własną nazwą: result[2] to trzecie pole rekordu merged, czyli core1.c.
Lista pól result odwołuje się wyłącznie do strumienia z własnej klauzuli FROM. Zapis core1[0] w tym miejscu kończy się błędem kompilacji Stream 'result' refers to 'core1', which is not in its FROM clause: core1 jest źródłem merged, a nie result - patrz Aliasowanie.
Podrozdziały o substratach i symbolu _ używają rozszerzonych wariantów tego samego zestawu deklaracji. Jak interpretować każdy element tego planu - patrz Debugowanie kompilacji.
Łańcuch etapów
Kolejność przebiegów i kontroli definiuje funkcja compiler::compile():
checkFunctionCalls- nazwy i arność funkcji skalarnychcheckStreamReducerFieldRefs- reduktor strumieniowy poza klauzuląFROMexpandStreamGenerators- rozwinięcie rodzin strumieninazwa[N]snapshotNamedSourceRefs- migawka odwołań zapisanych przez użytkownikaextractIntermediateStreams- wyrażeniaFROMdwuargumentowe, substratyvalidateSubstratNameUniqueness- pierwsza kontrola nazw przed sortowaniemexpandSchemaWildcards- rozwinięcie*oraz[_]resolveStreamIntervals- interwały strumieni, wykrywanie pętlifactorMatchedHashTimeMoves- wyniesienie wspólnego przesunięcia przed przeplotdeduplicateSubstrats- eliminacja powtórzonych substratówvalidateSubstratNameUniqueness- jednoznaczność nazw substratówresolveFieldReferences- odwołania do pól jako indeksy płaskieresolveWindowAggregates- grupy agregatów okna rekordowegoinferFieldShapes- typ, długość i krotność każdego polacheckRuleConditionShapes- obliczalność warunkówRULEsimplifyFieldExpressions- uproszczenie programów pól i regułshareEquivalentSelectComputations- współdzielenie równoważnychSELECTlocalizeFieldOffsets- przesunięcia pól w buforze wejściowymcomputeLogicalOrigin- początek logiczny strumieniacomputeStartupLatency- ogon startowycomputeRequiredCapacities- wymagana historia buforówvalidateConstraints- kontrola semantyczna planuapplyCapacitiesToStreams- zastosowanie pojemnościcheckHistoryMemory- budżet historii w RAMapplyDiskRetention- domyślna retencja plikowa i dostępność historiitopologicalSort- końcowy porządek producent–konsument
Etapy factorMatchedHashTimeMoves, deduplicateSubstrats, simplifyFieldExpressions i shareEquivalentSelectComputations są optymalizacjami, które przełączniki RDB_OPT_* mogą wyłączyć. Wyłączenie nie zmienia wartości wyniku; może najwyżej wydłużyć ogon startowy (patrz factorMatchedHashTimeMoves). Pozostałe etapy wykonują się zawsze.
checkFunctionCalls
Sprawdza nazwy i arność funkcji skalarnych względem jednej tabeli rqlFunctions.hpp. Dopasowanie ignoruje wielkość liter, a do tokena trafia postać kanoniczna nazwy. Nieznana funkcja lub niedozwolona szerokość kończy kompilację komunikatem Check result: jeszcze przed rozwinięciem generatorów, więc jeden błąd szablonu nie jest powielany N razy.
checkStreamReducerFieldRefs
Odrzuca reduktor strumieniowy (MIN, MAX, AVG, SUMC bez szerokości okna) użyty w programie pola SELECT albo w warunku RULE. Gramatyka dopuszcza go w wyrażeniu skalarnym, ale tam żaden mechanizm wykonawczy go nie obliczy: zapytanie SELECT avg STREAM o FROM AVG(src) przechodziło kompilację i nie emitowało potem ani jednego rekordu. Miejscem reduktora strumieniowego jest klauzula FROM; działające SELECT * FROM AVG(src) tej kontroli nie podlega. Etap stoi obok checkFunctionCalls z tego samego powodu - przed rozwinięciem generatorów.
expandStreamGenerators
Rozwija każdy szablon SELECT ... STREAM nazwa[N] ... na N zwykłych zapytań o nazwach nazwa$0…nazwa$(N-1) i podstawia numer instancji pod $ w polach, wartościach oraz odwołaniach klauzuli FROM. Jest pierwszym przebiegiem przepisującym plan (poprzedzają go tylko kontrole checkFunctionCalls i checkStreamReducerFieldRefs): po nim pozostała część kompilatora otrzymuje plan nieodróżnialny od ręcznie rozpisanych zapytań. Składnię i ograniczenia opisuje Polecenie SELECT.
Przed kopiowaniem szablonu sprawdza też liczbę strumieni po rozwinięciu: najwyżej 148. Pozostałe granice opisuje Granice wymiarów planu.
snapshotNamedSourceRefs
Zapamiętuje referencje źródłowe zapisane przez użytkownika przed tworzeniem substratów. Późniejsza lokalizacja pól używa tej migawki, aby odróżnić legalne tokeny syntetyczne od odwołań do składowej przeplotu #, której tożsamości wynik już nie zachowuje.
extractIntermediateStreams
Sprowadza każde wyrażenie FROM do postaci co najwyżej dwuargumentowej. Złożone wyrażenia jak (core0#core1)+core2 oraz zapisy łańcuchowe bez nawiasów (core0+core1+core2, core0#core1#core2) wymagają pośrednich strumieni. Każde zapytanie jest redukowane do punktu stałego, więc etap obsługuje również sąsiadujące podwyrażenia jednoargumentowe, np. (core0>2)#(core1>1). Etap tworzy automatycznie substraty - patrz Substraty.
expandSchemaWildcards
Rozwija symbol * w klauzuli SELECT oraz indeks [_]. Gwiazdkę zastępuje listą pól wynikających ze schematu strumienia źródłowego. Formułę z x[_] powiela zgodnie z liczbą slotów, które x wnosi do rekordu całej klauzuli FROM, a nie według własnej szerokości strumienia x. Dzięki temu jednopolowy x pod oknem x@(1,5) daje pięć elementów. Jeżeli wkład wskazanej nazwy nie tworzy w FROM spójnego bloku pól, kompilacja kończy się błędem zamiast przyjąć przypadkową szerokość.
Na tym etapie schematy pochodne rozwijają liczbowy wpis T[N] do N pól skalarnych. Deskryptor deklaracji nadal zachowuje jeden wpis tablicowy, a układ bajtów i kolejność płaskich slotów nie zmieniają się. STRING[N] pozostaje jednym polem tekstowym. Dzięki temu operatory pochodne, reduktory, AGSE i payload używają tej samej jednostki indeksowania. Patrz Rozwijanie symbolu * i Przetwarzanie symbolu _.
resolveStreamIntervals (← tu wykrywane są pętle)
Wyznacza interwał czasowy (delta) każdego strumienia na podstawie operatorów algebraicznych i interwałów strumieni wejściowych. Algorytm iteracyjny - w każdej rundzie rozwiązuje tyle strumieni, ile jest możliwe. Agregat okna rekordowego w liście SELECT nie zmienia interwału i wymaga pojedynczego odwołania do strumienia w FROM; złożona klauzula jest tutaj odrzucana. Etap wykrywa cykliczne zależności zatrzymując się, gdy liczba nierozwiązanych strumieni przestaje maleć - patrz Rozwiązywanie interwałów i Wykrywanie pętli.
factorMatchedHashTimeMoves
Rozpoznaje dopasowane przesunięcia argumentów przeplotu. Gdy i·ΔA=k·ΔB, przepisuje (A>i)#(B>k) do (A#B)>(i+k), redukując dwa substraty przesunięcia do jednego substratu przeplotu. Przypadki niedopasowane oraz substraty współdzielone z innymi konsumentami pozostają bez zmian - patrz Substraty.
Przesunięcie przenosi milczenie do początku logicznego, a nie wstawia rekordy prefiksu. Równość fizycznych przesunięć sprawia, że obie strony reguły mają ten sam emitowany ciąg i ten sam początek logiczny. Ogony równe nie są: strona sfaktoryzowana czyta treść wprost z przeplotu, więc jest gotowa nie później, a zwykle wcześniej niż strona czytająca składowe po ich własnym przesunięciu. Reguła jest zatem optymalizacją opóźnienia, nie przepisaniem neutralnym - zakres twierdzenia R1 i kontrprzykład: Formalne podstawy i dowody.
deduplicateSubstrats
Optymalizacja: jeśli dwa zapytania korzystają z tej samej operacji pośredniej (np. core0#core1), etap wskazuje drugie zapytanie na substrat utworzony przez pierwsze. Unika powielania obliczeń - patrz przykład w Substraty.
validateSubstratNameUniqueness
Sprawdza, czy dwa substraty o tej samej nazwie opisują ten sam program. Kontrola działa po extractIntermediateStreams, przed pierwszym sortowaniem topologicznym w expandSchemaWildcards, i ponownie po deduplikacji. Podkreślenia w zwykłych nazwach również mogą powodować kolizję: A_B + C i A + B_C tworzą nazwę STREAM_ADD_A_B_C. Nazwy dłuższe niż 200 bajtów są stabilnie skracane przez composeStreamName(), a ten sam warunek chroni także przed kolizją skrótu. Różne programy dają odmowę kompilacji z komunikatem Substrate name '...' denotes two different programs; identyczne duplikaty są dozwolone, także przy wyłączonej deduplikacji. Kontrola nie zależy od przełączników optymalizatora. W ad hoc i resecie odmowa wraca do klienta, a serwer nadal działa. Zachowanie sprawdzają ut_compiler i it_plan_error_e4-run.
resolveFieldReferences
Przekształca odwołania do pól ze schematów źródłowych na indeksy płaskie w schemacie wynikowym. Obsługuje aliasowanie po sumie - core0[0] zamienia na str1[0] itp. - oraz zapamiętuje, do którego źródła została rozwiązana goła nazwa pola. Nazwane odwołania zapisane przez użytkownika są śledzone osobno, aby późniejszy przebieg nie pomylił ich z tokenami syntetyzowanymi przez kompilator. Goła nazwa liczbowej tablicy jest odrzucana: a nie znaczy a[0]; trzeba podać element. Patrz Aliasowanie.
resolveWindowAggregates
Wyodrębnia program argumentu każdego agregatu okna - MIN, MAX, AVG albo SUMC(wyrażenie : W) - z listy SELECT do tabeli query::windowGroups. Sprawdza dodatnią szerokość, typ liczbowy, jedno źródło historii, obecność odwołania do pola oraz zakazy zagnieżdżania i użycia w RULE. Identyczne trójki źródło–wyrażenie–szerokość współdzielą grupę i jedno przejście po historii. Token agregatu staje się bezargumentowym operandem wskazującym obliczony wynik grupy.
inferFieldShapes
Jedyny etap ustalający publiczny kształt pola SELECT: typ, długość i krotność. Kształt wynika z całego programu pola - przebieg odtwarza arytmetykę wykonawczą na stosie typów, łącznie z promocją BYTE, jawnymi konwersjami w środku wyrażenia, wynikiem agregatu okna oraz szerokością STRING. Etap zastąpił wcześniejsze reguły lokalne (propagateCopiedFieldShapes, inferStringFieldTypes), które rozstrzygały kształt tylko w wybranych przypadkach - patrz Równanie typów w górę.
Przebieg działa do punktu stałego, bo drzewo jest jeszcze posortowane według interwału i konsument może stać przed producentem. Obejmuje wyłącznie węzły kopiujące schemat operandu; reduktory i okno @ zachowują schemat zbudowany przez swój operator, a deklaracje DECLARE pozostają nietknięte. Etap poprzedza upraszczanie wyrażeń: po zwinięciu stałych szerokość pola zależałaby od przełącznika optymalizacji.
checkRuleConditionShapes
Stosuje do warunków RULE tę samą kontrolę obliczalności, którą inferFieldShapes stosuje do pól. Warunek reguły wykonuje ten sam ewaluator wyrażeń, więc bez tego etapu niepoprawny warunek omijałby kontrolę i dawał po cichu złą wartość. Przebieg niczego nie zapisuje w planie - jedynie odrzuca warunki, których nie da się obliczyć.
simplifyFieldExpressions
Upraszcza programy pól SELECT, argumenty agregatów okna rekordowego oraz warunki RULE po rozwiązaniu referencji, ale przed współdzieleniem równoważnych obliczeń. Przebieg zwija wyrażenia stałe, łączy bezpieczne ogony stałych w arytmetyce całkowitej oraz w konkatenacji STRING oraz usuwa zgodne typowo elementy neutralne (E+0, E-0, E*1, E/1). Przy osobnym przełączniku aggressive_expr_optimization=ON zapisuje powtórzone dokładne czynniki jako potęgę, np. E*E*E jako E^3; domyślnie ta reguła jest wyłączona.
Przebieg zachowuje semantykę wartości NULL i promocję typów. Dlatego nie upraszcza E*0, nie reasocjuje FLOAT ani DOUBLE i pozostawia bez zmian programy, których typu lub działania nie potrafi bezpiecznie ustalić. Redukcja powtórzonego czynnika dotyczy tylko typów o dokładnym mnożeniu (BYTE, INTEGER, UINT, RATIONAL); dla FLOAT i DOUBLE pojedyncze mnożenie nie jest zastępowane wywołaniem pow.
Reasocjacja ogona (reguła B) wymaga ścisłej równości wartości, włącznie z NULL, przy włączonej i wyłączonej optymalizacji. Dla bazy INTEGER, UINT lub BYTE i stałych INTEGER strażnik wyznacza przedziały wartości bazy, dla których wynik pośredni i wynik po przepisaniu mieszczą się w reprezentacji. Przepisanie jest dozwolone tylko wtedy, gdy dziedzina określoności wyniku po przepisaniu zawiera się w dziedzinie wyniku pośredniego. Dla BYTE strażnik przyjmuje cały zakres INTEGER, ponieważ złożona baza, np. b+b, już daje INTEGER. Pozostawia więc m.in. (i+1)-1 przy INT_MAX, i*-1*-1 przy INT_MIN oraz u*-2*-3 i u+5-3 nad UINT w formie krokowej, zachowując przepełnienie pośrednie jako NULL.
Dla RATIONAL oraz pozostałych nieudowodnionych promocji reguła B odmawia reasocjacji; nie ogranicza to zwijania wyrażeń stałych ani usuwania zgodnych typowo elementów neutralnych. Konkatenacja STRING pozostaje dozwolona. Regresja it_expr_corpus-value obejmuje granice INTEGER/UINT, promocję BYTE, przepełnienie RATIONAL i kontrolę u+3-5; sprawdza wartości i deskryptory także przy all-off.
shareEquivalentSelectComputations
Wykrywa jawne zapytania SELECT o równoważnych programach pól i drzewach FROM zawierających STREAM_ADD. Porządkuje tylko dwoje dzieci pojedynczego węzła STREAM_ADD, bez zmiany grupowania całego drzewa. Dla każdej klasy równoważności tworzy jeden substrat STREAM_SELECT_*, a publiczne zapytania pozostawia jako lekkie projekcje zachowujące własne nazwy, deskryptory, reguły i storage. Przebieg wykonuje się przed lokalizacją offsetów - patrz Substraty.
localizeFieldOffsets
Przelicza odwołania do pól (b[x], c[y]) na pozycje w spłaszczonym rekordzie wejściowym zapytania, zapisywane pod jego własną nazwą (result[z]). Dla sumy + offset wynika z liczby pól wcześniejszych składowych. Dla przeplotu # oba argumenty dzielą te same pozycje wspólnego schematu; tożsamość składowej nie jest już dostępna przez jej nazwę.
Pozycję da się wyznaczyć tylko dla strumieni z klauzuli FROM i dla źródeł osiąganych przez substraty wygenerowane przez kompilator. Odwołanie do źródła strumienia pośredniego, który jest zapytaniem użytkownika - np. core1[0] przy FROM merged - kończy kompilację błędem Stream '…' refers to '…', which is not in its FROM clause. Taki strumień ma własny interwał i bufor, więc pozycji jego źródeł w rekordzie wejściowym konsumenta nie ma czym wyznaczyć.
Na tym etapie kompilator odrzuca napisane przez użytkownika A[0], A.pole, A[_], A.* i gołe nazwy pól, jeżeli wskazują składową osiąganą przez #. Kontrola obejmuje także warunki RULE oraz źródła ukryte w automatycznych substratach. Legalne pozostają odwołania przez nazwę strumienia wynikowego, niekwalifikowane * oraz jawne odzyskanie składowej przez & lub %.
computeLogicalOrigin
Oblicza query::logicalOrigin, czyli indeks pierwszego rekordu, który w ogóle istnieje. Różnica wobec ogona jest jakościowa: ogon mówi „jeszcze nie teraz“, origin mówi „ten rekord nie ma definicji“. Źródłem początku logicznego jest okno @(k,L) stemplowane końcem przedziału - jego wczesne rekordy sięgałyby przed początek źródła - agregat okna rekordowego, który dodaje W-1, oraz przesunięcie >N, którego rekord n niesie rekord n-N. Pozostałe operatory origin wyłącznie przenoszą, tym samym odwzorowaniem indeksu, którym czytają dane.
Dla @ i >N postać jest zamknięta; dla +, #, -, Theta i ~Theta przebieg szuka najmniejszego indeksu osiągającego próg składowej, połowiąc po niemalejącym odwzorowaniu. Listing planu pokazuje wartość jako origin=.
computeStartupLatency
Oblicza query::startupLatency, czyli liczbę początkowych slotów własnego interwału strumienia, w których istniejący wynik nie jest jeszcze gotowy. Źródła mają ogon 0; >N daje max(0, W_src − N), bo czyta rekord starszy od bieżącego; przeplot uwzględnia ogony obu wejść i fazę rzeczywiście wybieranej składowej; suma bierze maksimum granic dostępności obu wejść. Różnica oraz oba rozploty używają dokładnych granic fazowych - lewy rozplot nie dodaje bezwarunkowo jednego slotu. AGSE używa granicy wynikającej z najnowszego pola okna, a redukcje i agregaty okna rekordowego nie dodają własnego ogona. Listing planu pokazuje wartość jako tail=; runtime nie emituje podczas ogona żadnego rekordu. Liczba slotów milczenia wynosi origin + tail.
Ten przebieg biegnie po computeLogicalOrigin i przed obliczeniem pojemności: ogon zależy od tego, które sloty są rekordami, a wymagana historia - od chwili pierwszej emisji konsumenta.
computeRequiredCapacities
Oblicza wymagane pojemności buforów dla każdego strumienia na podstawie odległości między czołem producenta a indeksem czytanym przez konsumenta. Dla przesunięcia >N odległość wsteczna wynosi W_out-W_src+N, więc podstawowa pojemność to W_out-W_src+N+1. Jeśli źródłem jest deklaracja, dochodzą dwa rekordy wyprzedzenia: rekord uzbrojony przy otwarciu storage i zerowy prefetch. Wynik jest ograniczany od dołu do jednego rekordu. Pojemność historii jest wymaganiem wykonawczym, a nie prefiksem wyniku.
Agregat okna rekordowego wymaga zachowania co najmniej W kolejnych rekordów wskazanego źródła. Pojemność uwzględnia także jego początek logiczny, ogon i różnicę interwałów tak samo jak pozostałe odczyty historii; nie jest dobierana wyłącznie jako lokalne W.
validateConstraints
Weryfikuje poprawność semantyczną skompilowanego planu: zgodność typów i płaskich szerokości, rozmiary okien, dostępność źródeł danych oraz ograniczenia operatorów. Przeplot # wymaga równych płaskich schematów, niezależnie od tego, czy wejście zapisano jako T[N], czy jako N pól skalarnych.
applyCapacitiesToStreams
Aplikuje obliczone pojemności do obiektów strumieni. Magazyn MEMORY zachowuje większą z wartości RETENTION n i potrzeby planu; dla źródeł zadeklarowanych pojemność wynika z potrzeb konsumentów.
Dla przeplotu kompilator redukuje stosunek \(\Delta_a/\Delta_b=p/q\) do względnie pierwszych dodatnich \(p,q\) i przegląda jeden pełny okres fazowy \(p+q\). Dla każdego slotu \(i\) tego okresu ustala, którą składową wybiera przeplot i pod jakim indeksem \(j(i)\), po czym bierze maksimum wymaganego opóźnienia:
\[ W_{\#} =\max_{0\le i<p+q}\left( \left\lceil\frac{\bigl(j(i)+1+W_{s(i)}\bigr)\Delta_{s(i)}}{\Delta_c}\right\rceil -1-i \right) \]
Wynik przeglądu jest dokładny - ani nie zaniża, ani nie zawyża granicy przyczynowej. Rachunek prowadzony jest w arytmetyce 64-bitowej, bo iloczyn \((j+1+W)\cdot\text{licznik}\cdot\text{mianownik}\) przekracza zakres int już dla umiarkowanych interwałów. Powyżej progu kHashPhaseScanLimit funkcja HashStartupLatency() (SOperations.hpp) stosuje bezpieczną granicę bez przeglądu faz:
\[ W_{\#,\mathrm{fallback}} =\max\left( \left\lceil\frac{W_a\Delta_a}{\Delta_c}\right\rceil, \left\lceil\frac{W_b\Delta_b}{\Delta_c}\right\rceil +\left\lceil\frac{p+q-1}{p}\right\rceil \right) \]
Pierwsze dwa składniki przeliczają ogony wejść na sloty wyjścia; dla zerowego ogona wkład wynosi zero. Składnik \(\lceil(p+q-1)/p\rceil\) opisuje tylko fazę i sam nie wystarcza przy niezerowych ogonach wejść. Cała granica jest zachowawcza: nie zwalnia rekordu przed gotowością zależności, ale nie obiecuje nadmiaru dokładnie jednego slotu. Regresja ut_soperations::xSOperations.hash_startup_latency_above_scan_limit_stays_safe porównuje ją z niezależnym przeglądem także dla niezerowych ogonów.
Regresje obejmują między innymi stosunki \(3/5\), \(3/2\), \(7/11\) i \(160/147\), w tym okresowe rekordy w całości NULL w nieprzepisanej lewej stronie tożsamości R1; wzór operatorowy pilnuje test ut_h10aGate.
checkHistoryMemory
Sumuje koszt historii źródeł DECLARE i pierścieni MEMORY, po ustaleniu ich pojemności. Jeśli przekracza [limits] history_memory_mib, zwraca błąd z liczbą bajtów i strumieniem o największym udziale. Magazyny plikowe nie wchodzą do tej sumy.
applyDiskRetention
Stosuje [storage] default_retention do strumieni DEFAULT i DIRECT bez jawnej retencji, także substratów. Dla ograniczonej liczby segmentów sprawdza, czy historia potrzebna planowi mieści się w najkrótszym stanie po rotacji: (segmenty - 1) * pojemność + 1 rekordów. Jeśli nie, odmawia kompilacji ze wskazaniem strumienia, retencji i potrzebnej głębokości. segmenty = 0 oznacza historię bez ograniczenia i nie podlega tej kontroli.
topologicalSort
Bezwarunkowo przywraca końcowy porządek producent–konsument. Jest to część poprawności wykonania, nie kosmetyka prezentacji planu: interwał wyniku # jest mniejszy od interwałów wejść, więc wcześniejsze sortowanie po interwale może przesunąć konsumenta przed producentów.
Przebiegi przepisujące plan są dodatkowo otoczone kontrolą verifyUserFieldNamesPreserved(). Optymalizacja może zmieniać i usuwać substraty wewnętrzne, ale nie może zmienić nazw pól żadnego publicznego strumienia, ponieważ trafiają one do obserwowalnego deskryptora .desc.
Etapy kontrolne i przepisujące zwracają "OK" lub komunikat błędu - wówczas kompilacja się zatrzymuje. Wyniku tego rodzaju nie zwracają snapshotNamedSourceRefs, computeRequiredCapacities (zwraca mapę pojemności) ani topologicalSort. Odwołanie do nieistniejącego strumienia wykrywa checkStreamReferences przed przepisywaniem planu; przyczyna wraca jako status kompilacji. xretractor -c wypisuje ją w Check result: i kończy się kodem 71 na Linuksie. Błędy wewnętrzne kompilatora są oznaczane osobnym prefiksem i nie są przedstawiane jako odmowa planu użytkownika.
Granice wymiarów planu
RetractorDB odrzuca plan, którego wymiary przekraczają bezpieczny zakres parsera, deskryptora lub pamięci historii. Kontrole działają przy zwykłym starcie, w xretractor -c, dla zapytań ad hoc i przy xqry --reset. W tym ostatnim przypadku odmowa nowego planu pozostawia działający plan bez zmian. Liczby graniczne są wspólne dla parserów RQL i DESC oraz kompilatora w src/include/rdb/sizeLimits.hpp.
Warstwa 1: pojedynczy literal
| Wymiar | Dopuszczalna wartość | Dotyczy |
|---|---|---|
| Długość pola | 1..65536 | TYP[N], STRING[N], to_string(x : N); parser DESC stosuje tę samą granicę pól. |
| Zasięg historii | do 65536 | Krok i wartość bezwzględna szerokości @(step, window), szerokość okna rekordowego, przesunięcie >N i granice DUMP -L TO R. Krok i szerokości muszą być dodatnie; przesunięcie i granice DUMP mogą być zerem. |
DUMP ... RETENTION | 0..256 | Liczba jednocześnie pamiętanych zadań zrzutu; 0 oznacza brak retencji zadań. |
| Rozmiar generatora | 1..148 | STREAM nazwa[N]; po rozwinięciu generatorów cały plan może mieć najwyżej 148 strumieni. |
Pojemność RETENTION magazynu musi być dodatnia. W dwuczłonowej postaci liczba segmentów może wynosić 0, co oznacza brak limitu segmentów na dysku. Literał poza zakresem typu liczbowego jest błędem parsera, a przekroczenie powyższej granicy daje komunikat w rodzaju AGSE step 65537 exceeds the limit 65536. to_string(x : 0) daje to_string width 0 must be greater than zero; nie tworzy pola o zerowej szerokości.
Warstwa 2: wymiary po rozwinięciu planu
| Kontrola kompilatora | Granica | Dlaczego jest osobna |
|---|---|---|
| Każde pole wynikowe, także pochodne | 65536 elementów lub bajtów napisu | Konkatenacja może przekroczyć granicę, mimo że każdy literal mieścił się w niej osobno. |
| Rekord wyjściowy strumienia | 1 MiB (1048576 bajtów) | Suma rozmiarów pól po ustaleniu schematu. |
| Rekord wejściowy strumienia | 1 MiB (1048576 bajtów) | Okno AGSE, suma lub przeplot mogą zbudować wejście większe od rekordu wynikowego. |
| Suma płaskich elementów rekordów w planie | 2^18 (262144) | Ogranicza koszt rozbudowy deskryptorów i wykonania, także przy wielu małych polach. |
| Początek logiczny i ogon startowy | INT_MAX (2147483647) slotów każdy | Wyniki obliczeń kompilatora muszą mieścić się w reprezentacji int używanej przez plan. |
Kontrola liczby 148 strumieni po rozwinięciu dotyczy planu z generatorem i następuje przed kopiowaniem jego instancji. Plan bez generatora może przejść ten etap, lecz limit slotu magistrali jest sprawdzany przy rejestracji lub wymianie planu. Rozmiary rekordów i pól są sprawdzane przed budową potencjalnie dużych deskryptorów.
Kompilator podaje strumień oraz przekroczony wymiar, np. Stream 'x' reads an input record of 1048577 bytes; the limit is 1048576, Plan needs 262145 record elements; the limit is 262144 (reached at stream 'x'), Stream 'x' has a logical origin of ... slots; the limit is 2147483647 lub analogiczny komunikat o startup latency.
Budżet historii w RAM
[limits] history_memory_mib w retractor.toml ustala łączny budżet historii planu, domyślnie 1024 MiB. Kompilator sumuje dla każdego źródła DECLARE i każdego magazynu MEMORY iloczyn liczby przechowywanych rekordów oraz rozmiaru rekordu powiększonego o narzut rdb::payload. Pojemność źródła wynika z potrzeb konsumentów, a pierścień MEMORY ma większą z wartości RETENTION n i potrzeby planu. Historia magazynów plikowych nie wchodzi do tego budżetu.
Przekroczenie budżetu kończy kompilację komunikatem Plan keeps ... bytes of stream history in memory; the budget [limits] history_memory_mib = ... allows ..., który wskazuje także strumień o największym udziale. Wartość konfiguracyjna musi być dodatnia; 0 lub liczba ujemna powoduje ostrzeżenie i użycie domyślnych 1024 MiB. Budżet nie jest limitem pamięci całego procesu ani rozmiaru kolejek IPC. Konfigurację opisuje xretractor, a zasady retencji - Typy STORAGE.
Budowa drzewa zależności
Drzewo zależności to plan realizacji zapytań w postaci grafu skierowanego. Jest to struktura danych, która budowana jest w trakcie kompilacji oraz modyfikowana w trakcie dodawania zapytań AdHoc. Korzeniami tego grafu są deklaracje efemerydów. Wszelkiej postaci deklaracje tworzące obiekty zewnętrzne – tzw. Źródła danych. Wewnątrz grafu występują artefakty i substraty. Na końcu łańcucha przetwarzania znajdują się artefakty – jako wyniki końcowe łańcucha.
Taka konstrukcja to graf skierowany. Graf, który posiada wiele korzeni i wiele wierzchołków końcowych. Wewnątrz grafu znajdują się węzły łączące. Każdy węzeł znajduje się na drodze od korzenia do wierzchołka końcowego. Najlepiej to zwizualizuje przykład.
Na początku rozważmy następujące trywialne zapytanie:
DECLARE a UINT STREAM core0, 0.1 TEXTFILE 'datafile1.txt'
SELECT str1[0] STREAM str1 FROM core0
Graf, w którym uwypuklone zostaną dependencje pomiędzy poszczególnymi obiektami uzyskamy w następujący sposób (Rys. 33):
$ xretractor -c query5.rql -d > out.dot && dot -Tsvg out.dot -o out.svg
Pełny opis flag -d -f -s i interpretacja wyjścia - patrz Debugowanie kompilacji.
Rys. 33. Dependencja efemeryd-artefakt
Skomplikujmy trochę ten graf dodając dwie deklaracje efemerydów i dodatkowy artefakt.
DECLARE a UINT STREAM core0, 0.1 TEXTFILE 'datafile1.txt'
DECLARE a UINT STREAM core1, 0.1 TEXTFILE 'datafile2.txt'
SELECT str1[0] STREAM str1 FROM core0
SELECT str2[0] STREAM str2 FROM core0 + core1
Graf zależności dla powyższego zestawu zapytań prezentuje się następująco (Rys. 34):
Rys. 34. Dependencja efemerydy-artefakty
Zbudujmy dodatkowy węzeł zależny od artefaktów. Najprościej dodać następujące zapytanie na końcu:
SELECT str3[0] STREAM str3 FROM str1#str2
Graf zmieni swoją postać:
Rys. 35. Dependencja efemerydy-artefakty-artefakty
Jak widać na Rys. 35 strumień str3 nie jest zależny bezpośrednio od danych dostarczanych przez strumienie core0 i core1. Zapytania tworzą graf zależności a kolejności ich wywoływania jest uporządkowana. Wartość interwału w strumieniach rośnie w kierunku korzeni. Wzrost w kierunku korzenia wynika z równań wyznaczających interwały opracowanej algebry.
Proszę zwrócić uwagę, że zapytania w pliku rql przetwarzane są sekwencyjnie. Próba odwołania się w zapytaniu do obiektu, który nie jest jeszcze zdefiniowany, skończy się błędem kompilacji.
W przypadku dołączenia do drzewa zależności następującego zapytania wytworzymy dodatkowy substrat.
SELECT str4[0] STREAM str4 FROM (core1+core0)>2
Tak dołączone zapytanie spowoduje modyfikację drzewa zależności w sposób przedstawiony na Rys. 36.
Rys. 36. Dependencja z substratem
Substrat został oznaczony innym kolorem oraz oznaczeniem Auto znajdującym się obok interwału czasowego.
Graf zależności musi być acyklicznym grafem skierowanym (DAG). Próba zdefiniowania strumienia odwołującego się do własnych wyników tworzy cykl i kończy się błędem kompilacji. Mechanizm wykrywania opisany jest w rozdziale Wykrywanie pętli w kompilacji.
NOTE: Opisana funkcjonalność ma pokrycie w teście:
subqueryopisanym w załączniku pt. Testy Integracyjne.
Substraty
O substratach, efemerydach i artefaktach wspomniałem w rozdziale dotyczącym architektury systemu. W tym przypadku przedstawię przykład.
Na początek chciałbym zwrócić uwagę na pewną własność wprowadzonych wyrażeń algebraicznych. W praktyce możemy zapisać dowolne wyrażenie, skompilować i przedstawić wzór na operacje na poszczególnych elementach serii czasowych umożliwiających uzyskanie pożądanego wyniku.
W praktyce w systemie realizuję wyłącznie operacje jedno lub dwuargumentowe. Przykładem operacji jednoargumentowych to przesunięcie w czasie lub operacja Agse. Tam argumentem jest tylko jeden strumień danych. Reszta operacji to operacje na dwóch strumieniach danych. W trakcie kompilacji wszystkie wyrażenia algebraiczne rozbijane są na takie, które mają dwa argumenty.
Parser akceptuje zarówno formę z nawiasami, jak i łańcuchy bez nawiasów, np. s1+s2+s3, s1#s2#s3 oraz s1+s2+s3+s4. Taki zapis jest następnie redukowany do sekwencji operacji dwuargumentowych z automatycznymi substratami pośrednimi.
Przykład używa kanonicznych deklaracji z całego rozdziału - trzy strumienie o różnych typach i interwałach:
DECLARE a BYTE, b INTEGER STREAM core0, 0.1 TEXTFILE 'sensor_a.txt'
DECLARE c INTEGER, d FLOAT STREAM core1, 0.2 TEXTFILE 'sensor_b.txt'
DECLARE e INTEGER STREAM core2, 0.3 TEXTFILE 'sensor_c.txt'

SELECT merged[0] STREAM merged FROM (core0 # core1) + core2
Kompilacja:
$ xretractor -c query.rql
core0(1/10)	sensor_a.txt
	a: BYTE
	b: INTEGER
core1(1/5)	sensor_b.txt
	c: INTEGER
	d: FLOAT
STREAM_HASH_core0_core1(1/15)	tail=2
	:- PUSH_STREAM(core0)
	:- PUSH_STREAM(core1)
	:- STREAM_HASH
	a: INTEGER
		PUSH_ID(STREAM_HASH_core0_core1[0])
	b: FLOAT
		PUSH_ID(STREAM_HASH_core0_core1[1])
core2(3/10)	sensor_c.txt
	e: INTEGER
merged(1/15)	tail=4
	:- PUSH_STREAM(STREAM_HASH_core0_core1)
	:- PUSH_STREAM(core2)
	:- STREAM_ADD
	merged_0: INTEGER
		PUSH_ID(merged[0])
Pojawił się niezapowiedziany strumień STREAM_HASH_core0_core1 - to właśnie substrat. Kompilator rozbił (core0 # core1) + core2 na dwie operacje dwuargumentowe i wstawił pośredni strumień. Delta substratu: Δ = (1/10 · 1/5) / (1/10 + 1/5) = 1/15.
Co się stanie po dołączeniu zapytania:
SELECT merged2[0] STREAM merged2 FROM (core0 # core1) > 2
Pełny plan po dołączeniu zapytania pokazuje niżej, że dochodzi jeden blok merged2, korzystający z już utworzonego substratu STREAM_HASH_core0_core1:
core0(1/10)	sensor_a.txt
	a: BYTE
	b: INTEGER
core1(1/5)	sensor_b.txt
	c: INTEGER
	d: FLOAT
STREAM_HASH_core0_core1(1/15)	tail=2
	:- PUSH_STREAM(core0)
	:- PUSH_STREAM(core1)
	:- STREAM_HASH
	a: INTEGER
		PUSH_ID(STREAM_HASH_core0_core1[0])
	b: FLOAT
		PUSH_ID(STREAM_HASH_core0_core1[1])
core2(3/10)	sensor_c.txt
	e: INTEGER
merged(1/15)	tail=4
	:- PUSH_STREAM(STREAM_HASH_core0_core1)
	:- PUSH_STREAM(core2)
	:- STREAM_ADD
	merged_0: INTEGER
		PUSH_ID(merged[0])
merged2(1/15)	origin=2
	:- PUSH_STREAM(STREAM_HASH_core0_core1)
	:- STREAM_TIMEMOVE(2)
	merged2_0: INTEGER
		PUSH_ID(merged2[0])
Zastanawiasz się pewnie dlaczego tylko jedno a nie ponownie dwa? Odpowiedź to optymalizacja. Korzystamy z pośrednich wyników poprzedniego. To jedna z nieoczekiwanych korzyści zastosowania RetractorDB.
Dyrektywa SUBSTRAT wybiera profil magazynu wyników pośrednich. Przyjmuje nazwę w apostrofach: memory, default, direct, posix, posixshd albo generic, bez względu na wielkość liter. device i textsource są rodzajami źródeł tylko do odczytu, więc parser odrzuca je jako profile substratów. Domyślny profil default zapisuje wyniki pośrednie na dysku; bez retencji ich historia rośnie bez ograniczenia. SUBSTRAT 'memory' utrzymuje w RAM tylko historię potrzebną planowi. Właściwości i zastosowania wszystkich obsługiwanych profili opisuje rozdział Typy STORAGE.
Dodanie zapytania o tych samych operacjach, ale innej nazwie może spowodować deduplikację substratów. Jeśli program, delta i schemat są równoważne, kompilator przepnie odwołania PUSH_STREAM na istniejący strumień i usunie duplikat.
NOTE: Opisana funkcjonalność ma pokrycie w testach:
issue96_no_substrat_reduction,issue96_substrat_referenceopisanych w załączniku pt. Testy Integracyjne.
Redukcja substratów
Kompilator realizuje optymalizację zwaną redukcją substratów (funkcja deduplicateSubstrats). Polega ona na tym, że jeśli użytkownik zdefiniował zapytanie strukturalnie identyczne z wygenerowanym substratem, substrat jest usuwany z planu, a jego odwołania zastępowane są nazwą zapytania użytkownika.
Warunki redukcji
Redukcja substratu do zapytania użytkownika następuje wtedy i tylko wtedy, gdy spełnione są jednocześnie trzy warunki:
- Ten sam kształt schematu - liczba pól oraz ich typy, rozmiary w bajtach i liczności są identyczne. Nazwy pól nie są porównywane.
- Ta sama delta - częstotliwość próbkowania strumieni jest taka sama.
- Te same operacje przetwarzania - sekwencja instrukcji
PUSH_STREAM/STREAM_TIMEMOVE/STREAM_HASHitp. jest identyczna.
Przykład redukcji
Rozważmy zapytanie z kanonicznymi deklaracjami:
DECLARE a BYTE, b INTEGER   STREAM core0, 0.1 TEXTFILE 'sensor_a.txt'
DECLARE c INTEGER, d FLOAT  STREAM core1, 0.2 TEXTFILE 'sensor_b.txt'

SELECT merged[0]  STREAM merged  FROM (core0 > 2) + core1
SELECT shifted[0] STREAM shifted FROM core0 > 2
Bez redukcji kompilator wygenerowałby trzy strumienie: substrat STREAM_TIMEMOVE_2_core0, merged i shifted. Substrat i shifted mają identyczną strukturę - ten sam strumień źródłowy core0 i tę samą operację >2. Po redukcji substrat jest usuwany, a odwołanie PUSH_STREAM(STREAM_TIMEMOVE_2_core0) w merged zostaje zastąpione przez PUSH_STREAM(shifted):
core0(1/10)	sensor_a.txt
	a: BYTE
	b: INTEGER
STREAM_TIMEMOVE_2_core0(1/10)	origin=2
	:- PUSH_STREAM(core0)
	:- STREAM_TIMEMOVE(2)
	a: BYTE
		PUSH_ID(STREAM_TIMEMOVE_2_core0[0])
	b: INTEGER
		PUSH_ID(STREAM_TIMEMOVE_2_core0[1])
core1(1/5)	sensor_b.txt
	c: INTEGER
	d: FLOAT
merged(1/10)	tail=1	origin=2
	:- PUSH_STREAM(STREAM_TIMEMOVE_2_core0)
	:- PUSH_STREAM(core1)
	:- STREAM_ADD
	merged_0: BYTE
		PUSH_ID(merged[0])
shifted(1/10)	origin=2
	:- PUSH_STREAM(core0)
	:- STREAM_TIMEMOVE(2)
	shifted_0: BYTE
		PUSH_ID(shifted[0])
Ważne ograniczenie: tylko substraty są redukowane
Redukcja dotyczy wyłącznie substratów wygenerowanych przez kompilator (isSubstrat = true). Zapytania zdefiniowane jawnie przez użytkownika nigdy nie są redukowane, nawet jeśli dwa z nich mają identyczną strukturę.
Przykład - dwa zapytania użytkownika o tej samej operacji:
DECLARE a BYTE, b INTEGER   STREAM core0, 0.1 TEXTFILE 'sensor_a.txt'

SELECT shifted1[0] STREAM shifted1 FROM core0 > 2
SELECT shifted2[0] STREAM shifted2 FROM core0 > 2
Wynik kompilacji zachowa oba strumienie bez żadnej redukcji:
shifted1(1/10)
        :- PUSH_STREAM(core0)
        :- STREAM_TIMEMOVE(2)
        shifted1_0: BYTE
                PUSH_ID(shifted1[0])
shifted2(1/10)
        :- PUSH_STREAM(core0)
        :- STREAM_TIMEMOVE(2)
        shifted2_0: BYTE
                PUSH_ID(shifted2[0])
core0(1/10)     sensor_a.txt
        a: BYTE
        b: INTEGER
Semantyczna decyzja jest tu celowa: użytkownik zadeklarował dwa odrębne strumienie wynikowe i oba mają prawo istnieć niezależnie w planie wykonania. Przebieg deduplicateSubstrats() nie usuwa żadnego z nich. Kompilator może natomiast współdzielić ich wewnętrzne obliczenie, pozostawiając oba publiczne strumienie - opisuje to następny podrozdział.
Współdzielenie równoważnych obliczeń SELECT
Przebieg shareEquivalentSelectComputations() wykrywa jawne zapytania SELECT, które wykonują ten sam program pól nad równoważnymi drzewami FROM zawierającymi STREAM_ADD. Zamiast wykonywać kosztowny program osobno dla każdego zapytania, kompilator tworzy jeden substrat STREAM_SELECT_*. Publiczne strumienie pozostają w planie jako lekkie projekcje tego substratu.
Przykład:
SELECT a[_] * b[_] STREAM c1 FROM a+b
SELECT a[_] * b[_] STREAM c2 FROM b+a
Po rozwiązaniu referencji oba programy pól pobierają te same wartości z a i b, mimo że operator strumieniowy + buduje wejście w innej kolejności. Plan zawiera jedno wspólne obliczenie, przykładowo STREAM_SELECT_c1, oraz dwa publiczne strumienie c1 i c2 wskazujące na jego pola.
Warunki równoważności
Dwa zapytania mogą współdzielić obliczenie tylko wtedy, gdy:
- mają ten sam interwał wynikowy;
- mają tę samą liczbę i kolejność pól wynikowych;
- odpowiadające pola mają ten sam typ, rozmiar i liczność;
- po rozwiązaniu referencji i rozwinięciu
[_]programy pól pobierają te same pola źródłowe oraz wykonują te same operacje w tej samej kolejności; - drzewa
FROMsą równoważne z zachowaniem ich grupowania.
Podpis drzewa porządkuje kanonicznie dwoje dzieci każdego pojedynczego węzła STREAM_ADD, dlatego a+b może być równoważne b+a. Nie spłaszcza jednak drzewa i nie korzysta z łączności operatora. Jest to istotne dla trzech źródeł o różnych interwałach:
SELECT p[_] * q[_] + r[_] STREAM x1 FROM (p+q)+r
SELECT p[_] * q[_] + r[_] STREAM x2 FROM (q+p)+r
SELECT p[_] * q[_] + r[_] STREAM x3 FROM (r+q)+p
Zapytania x1 i x2 mogą współdzielić obliczenie, ponieważ zamieniają tylko dzieci tego samego wewnętrznego węzła. Zapytanie x3 ma inne grupowanie i inny substrat pośredni; jego rytm uruchomienia może być inny, dlatego pozostaje niezależne.
Kolejność wejścia jest również widoczna dla pełnego skanu i kolejności projekcji. Następujących par nie wolno scalać:
SELECT *          STREAM d1 FROM a+b
SELECT *          STREAM d2 FROM b+a
SELECT a[0], b[1] STREAM n1 FROM a+b
SELECT b[1], a[0] STREAM n2 FROM b+a
Zachowanie publicznego kontraktu
Optymalizacja współdzieli wyłącznie wewnętrzne obliczenie. Każdy jawny strumień zachowuje własną nazwę, schemat i deskryptor, reguły, retencję, politykę storage oraz artefakty. Automatyczne nazwy pól mogą zatem nadal różnić się między c1 i c2, mimo że ich dane są identyczne. Nie jest to pełny alias: żaden publiczny strumień nie znika z planu, IPC ani storage.
Po utworzeniu wspólnego STREAM_SELECT_* kompilator usuwa osierocone substraty do punktu stałego. Podczas importu ad-hoc analiza jest ograniczona do nowych identyfikatorów, aby ponowna kompilacja nie przepisała strumieni już utworzonych w aktywnym planie.
Przebieg działa po resolveFieldReferences() i expandIndexWildcards(), ale przed localizeFieldOffsets(). Dzięki temu podpis pola porównuje tożsamość źródła i jego indeks, a nie lokalny offset zależny od kolejności argumentów a+b lub b+a.
Test select_cse_commutative_add sprawdza kształt planu oraz wykonanie. Obejmuje równoważne projekcje indeksowane i jawne listy pól, wartości NULL i ich metadane, osobne deskryptory publiczne, SELECT *, zmianę kolejności pól oraz dodatni i ujemny przypadek trzech źródeł. Test porównuje bajtowo dane równoważnych par i potwierdza różnicę wyników dla kontrprzykładów - patrz Testy Integracyjne.
Eliminacja duplikatów substratów
Gdy kilka zapytań korzysta z tej samej operacji strumieniowej – np. core0 + core1 – faza ekstrakcji substratów (extractIntermediateStreams) tworzy dla każdego z nich osobny substrat. Bez kolejnej fazy naprawczej w grafie powstawałyby równoległe, identyczne węzły pośrednie obliczające dokładnie tę samą wartość.
Kiedy substrat jest tworzony
Substrat generowany jest dla każdego zapytania, którego program zawiera więcej niż jeden operator strumieniowy. Dotyczy to operatorów: STREAM_ADD, STREAM_SUBTRACT, STREAM_HASH, STREAM_DEHASH_DIV, STREAM_DEHASH_MOD, STREAM_TIMEMOVE, STREAM_AGSE. Warunek sprawdza funkcja query::isReductionRequired().
Nowo powstałemu substratowi nadawana jest nazwa zbudowana z symbolu operacji, jej parametru oraz nazw operandów, np. STREAM_ADD_core1_core0, STREAM_TIMEMOVE_2_core0 albo STREAM_AGSE_1_10_core0 (funkcja composeStreamName w compiler.cpp). Parametr jest częścią tożsamości: dwa różne okna nad tym samym źródłem nie mogą otrzymać tej samej nazwy. Znaki niedozwolone w identyfikatorze są kodowane, np. liczba ujemna używa N, a kreska ułamkowa _.
Czytelna nazwa rośnie wraz ze złożonością klauzuli FROM i jest jednocześnie nazwą pliku substratu. Po przekroczeniu 200 bajtów kompilator zachowuje nazwę operatora, a resztę zastępuje stabilnym, 16-znakowym skrótem FNV-1a, np. STREAM_ADD_x92741c15f69ba93f. Dzięki temu szerokie wyrażenie nie przekracza systemowego NAME_MAX; ta sama struktura planu zawsze dostaje tę samą nazwę, a inna kolejność operandów daje inny skrót. validateSubstratNameUniqueness() odrzuca nazwę oznaczającą dwa różne programy, zarówno przy kolizji skrótu, jak i zwykłych nazw z podkreśleniami, np. A_B + C oraz A + B_C. Pierwsza kontrola odbywa się przed sortowaniem po nazwach, aby drugi program nie zniknął z planu; identyczne duplikaty są dozwolone. Kolejność opisują Przebiegi kompilacji.
W programie zapytania macierzystego token operatora zastępowany jest tokenem PUSH_STREAM wskazującym na substrat.
Prawo wynoszenia wspólnego przesunięcia czasu przed przeplot
ℹ️ Info Polska nazwa jest świadomie opisowa i nie stanowi dosłownego tłumaczenia angielskiego terminu matched interleave-shift factorization, pozostawionego w angielskiej wersji dokumentacji.
Po wyodrębnieniu substratów i rozwiązaniu ich interwałów kompilator stosuje regułę algebraiczną:
\[ (A > i) \mathbin{\#} (B > k) \longrightarrow (A \mathbin{\#} B) > (i+k), \qquad i\Delta_{a}=k\Delta_{b} \]
Warunek \(i\Delta_{a}=k\Delta_{b}\) oznacza, że oba argumenty przeplotu są przesunięte o ten sam czas fizyczny. Bez tego warunku przekształcenie nie jest równoważne i kompilator pozostawia pierwotny plan.
Niech zredukowany stosunek \(\Delta_a/\Delta_b\) będzie równy \(p/q\). Ogon przeplotu chroni wszystkie fazy okresu \(p+q\), bo kompilator przegląda ten okres slot po slocie i bierze maksimum wymaganego opóźnienia - wzór i uzasadnienie w rozdziale Formalne podstawy i dowody.
Przesunięcie jest opóźnieniem realizacji przyczynowej: przesuwa początek logiczny O o N, a swój ogon ustawia na \(\max(0,W_S-N)\) - nie zmienia ciągu rekordów i nie wstawia prefiksu. Dla \(\Delta_c=\Delta_a\Delta_b/(\Delta_a+\Delta_b)\) warunek dopasowania daje dokładnie:
\[ \frac{i\Delta_a}{\Delta_c} =\frac{k\Delta_b}{\Delta_c} =i+k \]
Dlatego przesunięcie każdego wejścia odpowiada tej samej liczbie i+k slotów wyjścia i początek logiczny obu stron jest identyczny. Ogony identyczne nie są. Strona sfaktoryzowana czyta treść wprost z przeplotu, a strona niesfaktoryzowana - dopiero po własnym przesunięciu składowych, więc czeka dłużej:
\[ W_{\mathrm{RHS}}=\max\left(0,;W_{\varphi(A,B)}-(i+k)\right)\le W_{\mathrm{LHS}} \]
Reguła zachowuje więc emitowany ciąg, interwał i origin=, a tail= może zmniejszyć. Jest optymalizacją opóźnienia, nie przepisaniem neutralnym; pełny dowód i kontrprzykład: Formalne podstawy i dowody.
Przed optymalizacją plan zawiera dwa substraty:
STREAM_TIMEMOVE_i_A = A > i
STREAM_TIMEMOVE_k_B = B > k
result = STREAM_TIMEMOVE_i_A # STREAM_TIMEMOVE_k_B
Po optymalizacji pozostaje jeden:
STREAM_HASH_A_B = A # B
result = STREAM_HASH_A_B > (i + k)
Przebieg factorMatchedHashTimeMoves() nie usuwa jawnych strumieni użytkownika ani substratów używanych przez innych konsumentów. Wykonuje się przed deduplikacją, dzięki czemu ujawniony substrat A # B może zostać następnie współdzielony z innym równoważnym planem.
Test issue202_hash_shift_e2e wykonuje obie strony tożsamości na niezależnych kopiach plikowych źródeł danych. Obie strony są tu sfaktoryzowane do tej samej postaci, więc porównanie jest pełne: bajtowo artefakty matched i CC, ich metadane z pominięciem zarezerwowanego nagłówka, pełna sekwencja wobec wzorca wyprowadzonego z okresu przeplotu B,A,A oraz równość deklaracji (origin=3 przy zerowym ogonie - \(\tau_3\) nad przeplotem o ogonie 2 pochłania go w całości). Żadna strona nie emituje rekordów zastępczych. Osobno computeRequiredCapacities() przydziela źródłu deklarowanemu N+1+2 rekordów historii: N+1 na sam zakres odczytu oraz dwa na wyprzedzenie czoła deklaracji, którego adresowanie indeksem logicznym nie skraca.
Test r1_identity_nulls sprawdza tę samą tożsamość dla stosunku \(\Delta_a/\Delta_b=3/2\), który wymaga maksimum fazowego \(H_{a,b}=2\), chociaż pierwsza faza wymaga tylko jednego slotu. Porównuje przepisany plan, zablokowaną przed przepisaniem lewą stronę i jawną prawą stronę. Plan przepisany i jawna prawa strona są równe w pełni. Lewa strona zablokowana przed przepisaniem ma ten sam początek logiczny i tę samą treść, ale ogon ściśle większy - porównanie obejmuje wspólny prefiks payloadu i mapy NULL, a osobna asercja wymaga, żeby strona sfaktoryzowana była ściśle dłuższa. Niepusty, okresowy rekord w całości NULL chroni przed ukryciem błędnego ogona przez brak danych. Testy jednostkowe kompilatora obejmują również stosunki \(3/5\), \(7/11\) i \(160/147\).
Algorytm deduplikacji
Po ekstrakcji substratów i wyznaczeniu interwałów czasowych kompilator uruchamia krok deduplicateSubstrats(). Algorytm działa iteracyjnie – pętla while(changed) powtarza przeszukiwanie aż do momentu, gdy żadna para duplikatów nie zostanie już znaleziona.
W każdym przebiegu dla każdej pary substratów (it, it2) sprawdzane są kolejno pięć warunków równoważności:
- Interwał czasowy –
it->rInterval == it2->rInterval - Długość programu – liczba tokenów w
lProgrammusi być identyczna - Długość schematu – liczba pól w
lSchemamusi być identyczna - Zawartość programu – każdy token porównywany jest według typu polecenia (
getCommandID()) i wartości parametru (getVT()) - Zawartość schematu – każde pole porównywane jest według typu (
rtype), rozmiaru w bajtach (rlen) i liczności (rarray)
Jeśli wszystkie warunki są spełnione, substrat it uznawany jest za duplikat substratu it2. Kompilator przechodzi przez cały coreInstance i we wszystkich tokenach PUSH_STREAM odnoszących się do starej nazwy (it->id) podstawia nową nazwę (it2->id). Następnie duplikat jest usuwany z listy zapytań (coreInstance.erase(it)), a pętla startuje od początku.
Miejsce w potoku kompilacji
Deduplikacja następuje po ustaleniu interwałów i wyniesieniu wspólnych przesunięć czasu, przed drugą kontrolą nazw substratów. Kolejność w compiler::compile() jest następująca:
checkFunctionCalls- nazwy i arność funkcji skalarnychcheckStreamReducerFieldRefs- reduktor strumieniowy poza klauzuląFROMexpandStreamGenerators- rozwinięcie rodzin strumienisnapshotNamedSourceRefs- migawka odwołań użytkownikaextractIntermediateStreams- wyodrębnienie substratówvalidateSubstratNameUniqueness- pierwsza kontrola przed sortowaniemexpandSchemaWildcards- rozwinięcie*oraz[_]resolveStreamIntervals- obliczenie interwałów czasowychfactorMatchedHashTimeMoves- prawo wynoszenia wspólnego przesunięcia czasu przed przeplotdeduplicateSubstrats- eliminacja duplikatów ← ten krokvalidateSubstratNameUniqueness- kontrola jednoznaczności nazwresolveFieldReferences- rozwiązanie referencji do pólresolveWindowAggregates- grupy agregatów okna rekordowegoinferFieldShapes- kształt pól wynikowychcheckRuleConditionShapes- obliczalność warunków regułsimplifyFieldExpressions- uproszczenie programów pól i regułshareEquivalentSelectComputations- współdzielenie równoważnych obliczeń SELECTlocalizeFieldOffsets- wyznaczenie przesunięć pólcomputeLogicalOrigin- wyznaczenie początku logicznegocomputeStartupLatency- obliczenie ogonów startowychcomputeRequiredCapacities- obliczenie wymaganej historiivalidateConstraints- kontrola ograniczeń operatorówapplyCapacitiesToStreams- zastosowanie pojemnościtopologicalSort- końcowy porządek producent–konsument
Wyniesienie wspólnego przesunięcia czasu przed przeplot i deduplikacja muszą nastąpić po rozwiązaniu interwałów, ponieważ obie operacje je porównują. Deduplikacja następuje po przepisaniu algebraicznym, aby mogła scalać ujawnione przez nie substraty przeplotu.
Współdzielenie obliczeń SELECT następuje dopiero po rozwiązaniu referencji i rozwinięciu [_], ponieważ porównuje gotowe programy pól. Musi jednak poprzedzać lokalizację offsetów, aby równoważne źródła nie wyglądały na różne wyłącznie z powodu kolejności w lokalnym buforze wejściowym.
Każdy przebieg przepisujący (factorMatchedHashTimeMoves, deduplicateSubstrats, shareEquivalentSelectComputations) jest otoczony kontrolą verifyUserFieldNamesPreserved(). Nazwy pól publicznych strumieni są częścią deskryptora .desc i nie mogą zmienić się wskutek optymalizacji. Ogon jest liczony dopiero dla ostatecznego planu. Końcowe sortowanie topologiczne jest bezwarunkowe, ponieważ wcześniejsze sortowanie po interwale może umieścić szybszego konsumenta # przed jego producentami.
Efekt w grafie zależności
Rozważmy zapytania:
DECLARE a UINT STREAM core0, 0.1 TEXTFILE 'datafile1.txt'
DECLARE a UINT STREAM core1, 0.1 TEXTFILE 'datafile2.txt'
SELECT str4[0] STREAM str4 FROM (core0+core1)>2
SELECT str5[0] STREAM str5 FROM (core0+core1)>3
Oba zapytania wymagają uprzedniego obliczenia sumy core0+core1.
Faza extractIntermediateStreams tworzy osobny substrat dla każdego zapytania, co daje dwa identyczne węzły pośrednie w grafie (Rys. 37):

Rys. 37. Graf przed deduplikacją - dwa identyczne substraty sumy core0+core1
Po uruchomieniu deduplicateSubstrats() jeden z duplikatów jest usuwany, a wszystkie odwołania PUSH_STREAM przepinane są do ocalałego węzła. W grafie pozostaje jeden wspólny substrat (Rys. 38):

Rys. 38. Graf po deduplikacji - jeden wspólny substrat, wygenerowany poleceniem: xretractor dedup.rql -c -d
Graf po deduplikacji to dokładnie to, co zwraca xretractor -c -d - kompilator zawsze prezentuje wynik po wszystkich fazach optymalizacji.
Wchłonięcie substratu przez jawny strumień
Pętla wewnętrzna w deduplicateSubstrats() nie sprawdza flagi isSubstrat dla kandydata it2 - sprawdzenie to istnieje tylko w pętli zewnętrznej. Oznacza to, że substrat automatyczny może zostać wchłonięty nie tylko przez inny substrat, ale przez dowolny strumień o identycznym programie i schemacie - w tym przez strumień zdefiniowany jawnie przez użytkownika.
Rozważmy zapytanie zawierające wyłącznie złożone wyrażenie:
DECLARE a UINT STREAM core0, 0.1 TEXTFILE 'datafile1.txt'
DECLARE a UINT STREAM core1, 0.1 TEXTFILE 'datafile2.txt'
SELECT str4[0] STREAM str4 FROM (core0+core1)>2
extractIntermediateStreams wyodrębnia tutaj substrat STREAM_ADD_core0_core1 dla wyrażenia core0+core1. Artefakt str4 zależy od niego (Rys. 39):

Rys. 39. Graf z automatycznym substratem STREAM_ADD_core0_core1
Gdy użytkownik doda jawną deklarację strumienia będącego dokładnie tą samą sumą:
SELECT * STREAM mysum FROM core0+core1
substrat STREAM_ADD_core0_core1 spełnia wszystkie warunki równoważności względem mysum - identyczny interwał, identyczny program tokenów, identyczny schemat pól. Faza deduplicateSubstrats() usuwa substrat i przepina wszystkie odwołania PUSH_STREAM na mysum. Substrat znika z grafu w zupełności (Rys. 40):

Rys. 40. Graf po dodaniu SELECT * STREAM mysum FROM core0+core1 - substrat zastąpiony przez jawny strumień
Efekt uboczny: mysum staje się węzłem wspólnym - obsługuje zarówno własnych konsumentów, jak i tych, którzy wcześniej korzystali z automatycznego substratu. Użytkownik zyskuje przy tym jawną nazwę dla wyników pośrednich i może odpytywać je przez xqry.
Aktualizacja schematu po wchłonięciu
Samo przepięcie tokenów PUSH_STREAM to za mało. Każdy strumień przechowuje w lSchema sekwencję instrukcji opisujących, jak zbudować wartość wyjściową każdego pola - w tym tokeny PUSH_ID(nazwa_strumienia, N), które mówią: „weź N-te pole z bufora wejściowego o nazwie nazwa_strumienia“. Gdy substrat zostaje wchłonięty, te tokeny wciąż odnoszą się do starej, usuniętej nazwy substratu. Krok localizeFieldOffsets() buduje mapę offsetów ze źródeł klauzuli FROM - tokenów PUSH_STREAM w programie oraz źródeł schowanych za substratami kompilatora - i według niej zamienia każdy PUSH_ID(źródło, N) na pozycję we własnym buforze wejściowym. Nazwa, której w mapie nie ma, przerywa kompilację błędem krytycznym, bo jej pozycji nie da się wyznaczyć.
Scenariusz błędu przy niezerowym offsecie
Rozważmy zapytanie:
DECLARE a INTEGER STREAM s1, 1 BINFILE 'data1.dat'
DECLARE b INTEGER STREAM s2, 1 BINFILE 'data2.dat'
DECLARE c INTEGER STREAM s3, 1 BINFILE 'data3.dat'

SELECT * STREAM mysum  FROM s1+s2
SELECT * STREAM merged FROM s3+(s1+s2)
Kompilator tworzy substrat STREAM_ADD_s1_s2. Strumień merged ma dwa źródła: s3 (offset 0) i substrat STREAM_ADD_s1_s2 (offset 1, bo s3 zajmuje pozycję 0). Dla pól pochodzących z substratu funkcja buildOutputSchema zapisuje w merged.lSchema tokeny:
PUSH_ID(STREAM_ADD_s1_s2, 0)   ← pole STREAM_ADD_s1_s2_1 (a z s1)
PUSH_ID(STREAM_ADD_s1_s2, 1)   ← pole STREAM_ADD_s1_s2_2 (b z s2)
Po wchłonięciu deduplicateSubstrats() przepina PUSH_STREAM z STREAM_ADD_s1_s2 na mysum. Bez aktualizacji lSchema tokeny PUSH_ID nosiłyby jednak starą nazwę, której localizeFieldOffsets() nie znajdzie w mapie offsetów. Dziś kończy się to błędem krytycznym kompilacji. Do 2026-09-14 brakujący klucz dostawał po cichu offset 0, czyli pozycję s3 - pola z mysum były wtedy odczytywane z offsetu 0 zamiast z offsetu 1, a kompilator o tym nie informował.
Poprawka: aktualizacja lSchema w deduplicateSubstrats
Aby uniknąć tej rozbieżności, deduplicateSubstrats() po zaktualizowaniu tokenów PUSH_STREAM wykonuje dodatkowy przebieg przez lSchema wszystkich zapytań i przepisuje:
- tokeny
PUSH_ID(stara_nazwa, N)naPUSH_ID(nowa_nazwa, N)- to przypadek pól zbuildOutputSchemadlaSTREAM_ADD, - tokeny
PUSH_ID2("stara_nazwa[N]")naPUSH_ID2("nowa_nazwa[N]")- to przypadek symbolicznych nazw tworzonych przezbuildOutputSchemadlaSTREAM_TIMEMOVE,STREAM_HASH,STREAM_SUBTRACT.
Po poprawce wyjście kompilatora (xretractor -c) dla strumienia merged z powyższego przykładu wygląda poprawnie:
merged(1/1)
        :- PUSH_STREAM(s3)
        :- PUSH_STREAM(mysum)
        :- STREAM_ADD
        s3_0: INTEGER
                PUSH_ID(merged[0])
        STREAM_ADD_s1_s2_1: INTEGER
                PUSH_ID(merged[1])
        STREAM_ADD_s1_s2_2: INTEGER
                PUSH_ID(merged[2])
Pola pochodzące z mysum zaczynają się od offsetu 1 (merged[1], merged[2]), co odpowiada faktycznej pozycji mysum w buforze merged - po polu s3_0 ze strumienia s3 na pozycji 0. Pola zachowują nazwę wchłoniętego substratu: nazwy pól strumieni użytkownika trafiają do deskryptora .desc, więc ustala się je przed optymalizacjami, a kontrola verifyUserFieldNamesPreserved() pilnuje, by deduplikacja ich nie zmieniła.
Kaskadowe wchłonięcie
NOTE: Opisana funkcjonalność ma pokrycie w testach:
issue167_dedup_cascaded,issue167_dedup_field_names,issue167_dedup_nonzero_offset,issue167_dedup_positive,issue167_triargopisanych w załączniku pt. Testy Integracyjne.
deduplicateSubstrats() działa iteracyjnie (while(changed)), co pozwala na wielokrokowe wchłonięcia. W przykładzie:
SELECT * STREAM mysum   FROM s1+s2
SELECT * STREAM shifted FROM (s1+s2)>1
SELECT * STREAM merged  FROM s3+((s1+s2)>1)
w pierwszej rundzie mysum wchłania STREAM_ADD_s1_s2 i przepisuje jego nazwy - również w schemacie pośredniego substratu STREAM_TIMEMOVE_1_STREAM_ADD_s1_s2. Dzięki temu w drugiej rundzie shifted może wchłonąć ten substrat (warunek programowy jest teraz spełniony, bo oba wskazują na mysum). Po dwóch rundach w planie nie pozostaje żaden substrat automatyczny, a merged korzysta bezpośrednio z s3 i shifted.
Rozwijanie symbolu *
Każdy, który pisał w języku SQL poznał magiczny znak * w tym języku. Wywołanie polecenia SELECT z tym argumentem rozwinie listę argumentów w oparciu o schematy tabel powstałych w wyniku złączeń relacyjnych. Coś podobnego chciałem osiągnąć w języku RQL.
Przykład używa kanonicznych deklaracji z całego rozdziału:
DECLARE a BYTE, b INTEGER STREAM core0, 0.1 TEXTFILE 'sensor_a.txt'
DECLARE c INTEGER, d FLOAT STREAM core1, 0.2 TEXTFILE 'sensor_b.txt'

SELECT *         STREAM merged FROM core0 + core1
SELECT merged[2] STREAM result FROM merged
Skompilujmy i zobaczmy efekt:
$ xretractor -c query.rql
core0(1/10)	sensor_a.txt
	a: BYTE
	b: INTEGER
core1(1/5)	sensor_b.txt
	c: INTEGER
	d: FLOAT
merged(1/10)	tail=1
	:- PUSH_STREAM(core0)
	:- PUSH_STREAM(core1)
	:- STREAM_ADD
	core0_0: BYTE
		PUSH_ID(merged[0])
	core0_1: INTEGER
		PUSH_ID(merged[1])
	core1_2: INTEGER
		PUSH_ID(merged[2])
	core1_3: FLOAT
		PUSH_ID(merged[3])
result(1/10)	tail=1
	:- PUSH_STREAM(merged)
	result_0: INTEGER
		PUSH_ID(result[2])
Symbol * zamienił się w cztery pola: core0_0, core0_1, core1_2, core1_3. Konwencja nazewnictwa: nazwa strumienia źródłowego + absolutna pozycja w schemacie wynikowym. Typy pól decydują o kolejności - core0 wnosi BYTE i INTEGER na pozycje 0 i 1, core1 wnosi INTEGER i FLOAT na pozycje 2 i 3. Odwołując się przez merged[2] w zapytaniu result dostajemy pole typu INTEGER - trzecie w kolejności, pierwsze z core1.
NOTE: Opisana funkcjonalność ma pokrycie w teście:
Pattern3opisanym w załączniku pt. Testy Integracyjne.
Rozwiązywanie interwałów
Każdy strumień w RetractorDB ma przypisany interwał czasowy - delta (Δ). Interwał określa, jak często produkowane są nowe wartości. Dla strumieni deklarowanych (DECLARE) interwał podaje użytkownik. Dla strumieni wynikowych (SELECT) interwał wyznacza kompilator z równań algebry strumieni.
Przykłady w tym rozdziale używają kanonicznych deklaracji z całego rozdziału: core0 (Δ=1/10), core1 (Δ=1/5), core2 (Δ=3/10).
Algorytm
Etap resolveStreamIntervals działa iteracyjnie. Interwały deklarowanych źródeł są już znane i dodatnie, a nierozwiązany interwał strumienia wynikowego ma wewnętrzną wartość zero. Istnienie wszystkich źródeł jest sprawdzane przed tym etapem.
pętla:
    unresolvedCount = 0
    resolvedThisPass = 0
    posortuj qTree po rosnącym interwale
    dla każdego zapytania poza deklaracjami i dyrektywami:
        jeśli którykolwiek interwał źródłowy jest nierozwiązany:
            unresolvedCount++
            przejdź do następnego zapytania
        wyznacz deltę wynikową z równania operatora
        jeśli interwał tego zapytania był nierozwiązany:
            resolvedThisPass++
        zapisz wyznaczoną deltę
    jeśli unresolvedCount == 0: koniec (sukces)
    jeśli resolvedThisPass == 0: błąd (cykl w grafie)
Wywołanie qTree::sort() porządkuje węzły według interwału, a nie topologicznie. Producent nie musi więc poprzedzać konsumenta. Interwał wyznaczony wcześniej w tej samej rundzie jest od razu dostępny dla kolejnych zapytań.
W poprawnym grafie acyklicznym każda runda z nierozwiązanymi węzłami rozwiązuje co najmniej jeden z nich: wśród tych węzłów istnieje taki, którego wszystkie źródła są już rozwiązane. Znane interwały pozostają znane, więc liczba nierozwiązanych węzłów maleje. Jeśli po rundzie nadal istnieją nierozwiązane węzły, ale resolvedThisPass == 0, występuje cykl - patrz Wykrywanie pętli. Niepoprawny argument operatora lub wynik poza zakresem reprezentacji powoduje osobną odmowę kompilacji.
Równania operatorów
Suma strumieni (+, STREAM_ADD)
SELECT ... STREAM c FROM a + b
\[\Delta_c = \min(\Delta_a, \Delta_b)\]
Strumień wynikowy produkuje wartości tak często, jak szybszy ze strumieni wejściowych.
Przykład: core0(Δ=1/10) + core1(Δ=1/5) → str1(Δ=1/10)
Synchronizacja strumieni (#, STREAM_HASH)
SELECT ... STREAM c FROM a # b
\[\Delta_c = \frac{\Delta_a \cdot \Delta_b}{\Delta_a + \Delta_b}\]
Operator # przeplata rekordy wejściowe. Częstość wyniku jest sumą częstości wejść, co daje powyższy interwał. Plan określa kolejność wyboru wejścia; oba źródła nie muszą emitować jednocześnie.
Przykład: core0(Δ=1/10) # core1(Δ=1/5) → str1(Δ=1/15)
Różnica strumienia (- r, STREAM_SUBTRACT)
SELECT ... STREAM c FROM a - r
\[\Delta_c = r,\qquad r \geq \Delta_a > 0\]
Argument r jest docelowym interwałem, a nie wielkością odejmowaną od interwału źródła. Operator wybiera rekordy źródła w tym takcie. Równy interwał zachowuje takt źródła, większy daje wolniejszy wynik, a mniejszy jest odrzucany podczas walidacji ograniczeń planu.
Przesunięcie w czasie (>n, STREAM_TIMEMOVE)
SELECT ... STREAM c FROM a > n
\[\Delta_c = \Delta_a\]
Przesunięcie nie zmienia częstotliwości ani ciągu emitowanych rekordów, zmienia natomiast indeks, pod którym ten ciąg się pojawia: rekord m niesie treść rekordu m-n. Jest przyczynowym opóźnieniem, ale jego nośnikiem jest początek logiczny, a nie ogon - rekordy o indeksie mniejszym od n nie mają definicji. Własny ogon operatora jest nieujemny: wynosi max(0, W_src - n), bo rekord m-n jest starszy od bieżącego i tym bardziej dostępny. Listing planu pokazuje obie wielkości jako origin= i tail=; sloty milczenia to ich suma i runtime nic w nich nie emituje.
Historia źródła wymaga n+1 rekordów na sam zakres odczytu, a dla źródła deklarowanego dodatkowo dwóch na wyprzedzenie czoła (rekord uzbrojony przy otwarciu storage i zerowy prefetch), którego adresowanie indeksem logicznym nie skraca.
Reduktory strumieniowe (MAX, MIN, AVG, SUMC)
\[\Delta_c = \Delta_a\]
Reduktory działają na całym wyrażeniu strumieniowym, np. AVG(a@(1,10)). Redukują wartości w rekordzie lub oknie, ale interwał strumienia wyjściowego pozostaje taki sam jak źródłowego. Postać przyrostkowa .max, .min, .avg, .sumc jest zgodna wstecz, lecz wygaszana.
Algorytm AGSE (@(step, window), STREAM_AGSE)
SELECT ... STREAM c FROM a @ (step, window)
\[\Delta_c = \frac{\Delta_a \cdot \text{step}}{F_{a}}\]
AGSE (Algorytm Generowania Serii Epizodów) generuje okna przesuwne. F_a oznacza liczbę płaskich wartości w rekordzie źródła, wyznaczoną przez descriptorStorage().flatElementCount(). Krok jest liczony po tych wartościach, więc interwał wynikowy zależy od kroku i szerokości rekordu wejściowego. Rozmiar okna wyjściowego określa liczbę wartości w oknie.
Operatory de-hash (STREAM_DEHASH_DIV, STREAM_DEHASH_MOD)
Jeśli c = a # b, operator & wyznacza interwał składowej a na podstawie interwału przeplotu c i argumentu oznaczającego interwał drugiej składowej b. Odwrócenie równania przeplotu daje:
\[\Delta_a = \frac{\Delta_c \cdot \Delta_b}{\Delta_b - \Delta_c},\qquad 0 < \Delta_c < \Delta_b\]
Warunek dziedziny wynika z dodatniości interwałów: przeplot ma większą częstość niż każda ze składowych. Dla operatora % role a i b zamieniają się.
Implementacja używa ogólnie wzoru z wartością bezwzględną:
\[\Delta_a = \frac{\Delta_c \cdot \Delta_b}{\left|\Delta_c - \Delta_b\right|}\]
Kompilator odrzuca równe interwały oraz wynik szybszy od źródła, czyli Delta_a < Delta_c. Może przyjąć również argument spoza dziedziny odwracania przeplotu. Na przykład dla Delta_c = 3/2 i Delta_b = 1 wyznacza Delta_a = 3, ale przeplot interwałów 3 i 1 ma interwał 3/4, a nie 3/2. Wartość bezwzględna nie czyni więc tego wzoru odwrotnością # poza podaną dziedziną.
Walidacja interwałów
Interwał źródła DECLARE musi być dodatni. Kompilator sprawdza to także dla planu zbudowanego bez parsera. Argumenty interwałowe &, % i - są sprawdzane podczas kompilacji; dla rozplotu & i % argument równy interwałowi źródła jest dodatkowo odrzucany przed dzieleniem przez zero w powyższym wzorze. Dotyczy to także interwału źródła wyliczonego z innego wyrażenia. W Pythonie taka odmowa jest CompileError, po którym można poprawić plan i ponowić kompilację.
Rachunek operatorów używa szerszych liczb całkowitych i sprawdza, czy wynik mieści się w reprezentacji interwału. Wynik spoza zakresu jest odmową planu. Wewnętrzne zero oznaczające jeszcze nierozwiązany węzeł oraz zerowy interwał dyrektywy nie oznaczają dopuszczenia źródła z zerowym krokiem. Po zakończonej kompilacji interwały strumieni są dodatnie; runtime korzysta z tego niezmiennika zamiast ponawiać te same kontrole w każdym rekordzie. Regresje ut_compiler obejmują niedodatnie interwały, rozplot równych interwałów i ponowną kompilację poprawnego planu z dyrektywami.
Dlaczego iteracja?
W zapytaniu z wieloma strumieniami wynikowymi jeden strumień może zależeć od drugiego:
DECLARE a INTEGER STREAM core0, 0.1 BINFILE 'data.dat'
SELECT str1[0] STREAM str1 FROM core0
SELECT str2[0] STREAM str2 FROM str1
Oba strumienie wynikowe mają interwał 1/10. Jeśli w danej rundzie str1 zostanie odwiedzony przed str2, oba interwały mogą zostać wyznaczone w tej samej rundzie. Jeśli kolejność będzie odwrotna, str2 poczeka do następnej rundy, ponieważ przy jego odwiedzeniu interwał str1 nie był jeszcze znany.
Iteracja uniezależnia wynik od kolejności odwiedzania węzłów po sortowaniu według interwału. Kolejność zapisania zapytań w pliku nie narzuca kolejności ich rozwiązywania. Gdyby ten etap przetwarzał graf w rzeczywistym porządku topologicznym, cały poprawny łańcuch zależności można byłoby rozwiązać w jednym przejściu.
Wykrywanie pętli w kompilacji
Graf zależności zapytań musi być acyklicznym grafem skierowanym (DAG). Jeśli zapytanie odwołuje się - bezpośrednio lub pośrednio - do własnych wyników, powstaje cykl. Kompilator wykrywa taką sytuację i kończy kompilację z błędem.
NOTE: Opisana funkcjonalność ma pokrycie w teście:
issue95_loopInCompileopisanym w załączniku pt. Testy Integracyjne.
Przykład pętli
DECLARE a BYTE, b INTEGER STREAM core0, 0.1 TEXTFILE 'sensor_a.txt'
DECLARE c INTEGER, d FLOAT STREAM core1, 0.2 TEXTFILE 'sensor_b.txt'

SELECT merged[0]*10, merged[2]+10 STREAM merged FROM core0 + core1
SELECT *                          STREAM agg    FROM MAX(merged)
SELECT *                          STREAM broken FROM merged + broken
Ostatnie zapytanie definiuje broken jako wynik operacji merged + broken - strumień zależy od samego siebie. Graf zależności zawiera cykl (Rys. 41):
%% pdf-width: 85%
graph LR
    core0 --> merged
    core1 --> merged
    merged --> agg
    merged --> broken
    broken -->|cykl| broken
    style broken fill:#f66,color:#fff
Rys. 41. Cykl w grafie zależności zapytań
Efekt kompilacji
Próba kompilacji takiego pliku kończy się błędem:
$ xretractor brokenQuery.rql -c 2>out.txt
$ echo $?
71
$ cat out.txt
Input file:brokenQuery.rql
Check result:Circular dependency in stream definitions
Komunikat "Circular dependency in stream definitions" pojawia się, gdy etap resolveStreamIntervals pozostawi nierozwiązane strumienie i w całej rundzie nie rozwiąże żadnego nowego. Powyższy kod wyjścia 71 dotyczy Linuksa. Jak uruchomić kompilację i czytać komunikaty błędów - patrz Debugowanie kompilacji.
Mechanizm wykrywania
Etap resolveStreamIntervals w każdej rundzie zlicza strumienie oczekujące na interwał źródła (unresolvedCount) oraz strumienie, które właśnie uzyskały pierwszy znany interwał (resolvedThisPass). Gdy unresolvedCount == 0, etap kończy się sukcesem. W przeciwnym razie sprawdza:
if (resolvedThisPass == 0) {
  SPDLOG_ERROR("Circular dependency: stream interval resolution stalled with {} unresolved streams", unresolvedCount);
  return {"Circular dependency in stream definitions"};
}
Przed tym etapem kompilator sprawdza istnienie źródeł i dodatniość interwałów deklaracji. Znany interwał pozostaje znany. Jeśli nierozwiązana część grafu jest acykliczna, istnieje w niej węzeł, którego wszystkie źródła są już rozwiązane, więc w danej rundzie zostanie rozwiązany co najmniej jeden nowy strumień. Brak takiego postępu przy niepustej części nierozwiązanej oznacza cykl. Niezależne od cyklu strumienie mogą zostać rozwiązane wcześniej.
Sortowanie w tym etapie odbywa się według interwału, a nie topologicznie. Dlatego poprawny plan może wymagać kilku rund, ale nie może utknąć bez postępu. Szczegóły i przykład kolejności odwiedzin opisuje Rozwiązywanie interwałów.
Starszy zapis porównujący unresolvedCount >= prevUnresolved także wykrywa brak postępu, jeśli każdy nierozwiązany węzeł jest prawidłowo zliczany, a rozwiązane węzły pozostają rozwiązane. Aktualna implementacja sprawdza bezpośrednio liczbę nowo rozwiązanych strumieni.
Jak naprawić
Usunąć odwołanie strumienia do samego siebie lub do strumienia, który od niego zależy. W powyższym przykładzie zapytanie:
SELECT * STREAM broken FROM merged + broken
należy zastąpić odwołaniem do strumienia, który istnieje niezależnie od broken:
SELECT * STREAM broken FROM merged + core0
Aliasowanie
W przypadku, w którym złączymy dwa strumienie danych operatorem sumy. Pojawi się nowy schemat danych. Do kolejnych wartości tego schematu możemy odwoływać się poprzez nazwę strumienia danych indeksowanych kolejno względem początku schematu.
Możemy jednak użyć też nazw z jakich strumień powstał. Na wartość wskazywać będzie nazwa strumienia wynikowego indeksowana względem początku schematu, jak również nazwa strumienia źródłowego przesunięta względem pozycji złączenia.
Przykład używa kanonicznych deklaracji z całego rozdziału:
DECLARE a BYTE, b INTEGER STREAM core0, 0.1 TEXTFILE 'sensor_a.txt'
DECLARE c INTEGER, d FLOAT STREAM core1, 0.2 TEXTFILE 'sensor_b.txt'

SELECT merged[0], merged[2], core0[0], core1[0] STREAM merged FROM core0 + core1
Po kompilacji otrzymamy:
$ xretractor -c query.rql
core0(1/10)	sensor_a.txt
	a: BYTE
	b: INTEGER
core1(1/5)	sensor_b.txt
	c: INTEGER
	d: FLOAT
merged(1/10)	tail=1
	:- PUSH_STREAM(core0)
	:- PUSH_STREAM(core1)
	:- STREAM_ADD
	merged_0: BYTE
		PUSH_ID(merged[0])
	merged_1: INTEGER
		PUSH_ID(merged[2])
	merged_2: BYTE
		PUSH_ID(merged[0])
	merged_3: INTEGER
		PUSH_ID(merged[2])
merged[0] i core0[0] oba trafiają na PUSH_ID(merged[0]) - to to samo pole. Natomiast core1[0] - pierwsze pole schematu core1 - trafia na PUSH_ID(merged[2]), nie merged[0]. Kompilator przetłumaczył lokalny indeks core1[0] na absolutną pozycję w schemacie złączonym: core0 zajmuje pozycje 0 i 1, więc core1 zaczyna się na pozycji 2.
Odwołanie spoza klauzuli FROM
Alias źródłowy działa tylko wtedy, gdy suma stoi bezpośrednio w klauzuli FROM zapytania. Jeżeli suma została nazwana osobnym zapytaniem, lista pól konsumenta widzi wyłącznie ten nazwany strumień:
SELECT *                   STREAM merged FROM core0 + core1
SELECT merged[0], core1[0] STREAM result FROM merged
Kompilacja kończy się błędem:
Check result:Stream 'result' refers to 'core1', which is not in its FROM clause. A field list reads only the streams named in FROM: refer to the field by its position in the record of a stream in FROM, or move the reference to a query whose FROM names 'core1'.
merged jest zapytaniem użytkownika z własnym interwałem i buforem, więc kompilator nie wyznacza pozycji jego źródeł w rekordzie result. Poprawny zapis wskazuje pole przez pozycję w rekordzie merged - core1 zaczyna się tam od pozycji 2:
SELECT merged[0], merged[2] STREAM result FROM merged
Ograniczenie nie dotyczy substratów tworzonych automatycznie dla złożonej klauzuli FROM, np. FROM (core0 + core1) > 1: przez nie alias źródłowy nadal działa.
Indeks poza zakresem
Indeks w zapisie strumien[k] musi wskazywać slot, który zapytanie rzeczywiście czyta. Kompilator odrzuca indeks poza tym zakresem, zamiast wygenerować plan czytający za końcem rekordu wejściowego. Granica zależy od tego, do czego odnosi się nazwa:
| Odwołanie | Granica | Przykład poprawny | Przykład odrzucony |
|---|---|---|---|
strumień z klauzuli FROM | liczba slotów, które ten strumień wnosi do FROM | core1[1] przy FROM core0 + core1 | core1[2] |
| strumień za oknem albo reduktorem | liczba slotów po operatorze, nie szerokość strumienia | core0[2] przy FROM core0@(1,3) | core0[3]; acc[1] przy FROM SUMC(acc) |
własna nazwa na liście SELECT | szerokość rekordu wejściowego FROM | merged[3] w STREAM merged FROM core0 + core1 | merged[4] |
własna nazwa w warunku RULE | szerokość rekordu wyjściowego strumienia | merged[3] przy SELECT * STREAM merged | merged[4] |
Okno i reduktor zmieniają liczbę slotów: core0@(1,3) wnosi trzy sloty, choć core0 ma dwa pola, a SUMC(acc) wnosi jeden. Ta sama liczba wyznacza rozwinięcie core0[_], więc zapis ręczny i zapis z _ mają ten sam zakres.
Przykładowe komunikaty:
Check result:Stream 'merged': stream 'core1' has 2 element(s)
  in its FROM clause, so 'core1[2]' is out of range
Check result:Stream 'merged': the FROM record of 'merged'
  has 4 element(s), so 'merged[4]' is out of range
Check result:Stream 'merged': rule 'alarm' reads the record of 'merged',
  which has 4 element(s), so 'merged[4]' is out of range
Indeks zwinięty z $ w generatorze strumieni podlega tej samej kontroli i daje ten sam komunikat co indeks napisany ręcznie.
Opisane wyżej aliasy źródłowe dotyczą operatora sumy +. Suma konkatenizuje schematy, dlatego zachowuje pozycję i tożsamość każdej składowej: core0[0] i core1[0] wskazują różne miejsca w rekordzie wynikowym.
Operator przeplotu # działa inaczej. Oba argumenty muszą mieć równoliczne schematy, a wynik ma jeden wspólny schemat. W danym slocie przeplot wybiera rekord jednej składowej, więc pozycja k lewego i prawego argumentu staje się tą samą pozycją k wyniku. Po wykonaniu A#B nazwa A albo B nie identyfikuje już źródła bieżącego rekordu.
Porównanie kompilacji dla deklaracji core0 i core1 z przykładu pokazuje różnicę bez uruchamiania zapytania:
Wyrażenie FROM | Odwołania na liście SELECT | Wynik kompilacji |
|---|---|---|
core0 + core1 | core0[0], core1[0] | PUSH_ID(merged[0]), PUSH_ID(merged[2]) - schematy są skonkatenowane, więc składowe pozostają rozróżnialne |
core0 # core1 | core0[0], core1[0] | błąd kompilacji - oba argumenty dzielą pozycję 0 jednego schematu wyniku |
Drugi wiersz odpowiada zapytaniu:
SELECT core0[0], core1[0] STREAM interleaved FROM core0#core1
Kompilator zatrzymuje je komunikatem, że core0 jest składową przeplotu i takiego odwołania nie można odróżnić od odwołania do drugiej składowej. Nie powstaje plan, który po cichu mapowałby oba pola na interleaved[0].
Z tego powodu kompilator odrzuca nazwane odwołania użytkownika, które przez # próbują sięgnąć do jego składowej. Zakaz obejmuje wszystkie formy:
- indeks liczbowy:
A[0]; - nazwę pola:
A.poleoraz gołą nazwę pola rozwiązaną doA; - indeks wieloznaczny:
A[_]; - kwalifikowany pełny skan:
A.*; - te same odwołania w warunku
RULEoraz przez substraty wygenerowane dla złożonej klauzuliFROM.
Poprawny zapis odwołuje się do jedynego schematu wyniku:
SELECT wynik[0], wynik[1] STREAM wynik  FROM A#B
SELECT wynik2.*           STREAM wynik2 FROM A#B
Niekwalifikowane * również oznacza cały schemat wynikowy i pozostaje legalne. Jeżeli dalsze obliczenie wymaga [_], najpierw należy nazwać przeplot, a następnie użyć jego wyniku:
SELECT *               STREAM przeplot      FROM A#B
SELECT przeplot[_] * 2 STREAM przeskalowany FROM przeplot
Gdy potrzebna jest ponownie konkretna składowa, należy odzyskać ją operatorem rozplotu & albo %, zamiast używać nazwy źródła przez węzeł #.
NOTE: Aliasowanie po
+ma pokrycie w teście integracyjnymPattern7, a odrzucenie odwołania spozaFROM- w teściefield_ref_outside_from. Odrzucanie nazwanych składowych#i kontrole pozytywne dla nazwy wyniku są pokryte testami jednostkowymiut_compiler.
Przetwarzanie symbolu _
Indeks [_] jest cukrem syntaktycznym powielającym wyrażenie pola. Jedno wyrażenie zapisane w SELECT rozwija się podczas kompilacji do wielu pól wynikowych, po jednym dla każdego zgodnego slotu wskazanych strumieni.
Liczba kopii nie wynika wyłącznie z własnego schematu strumienia. x[_] oznacza wszystkie sloty, które x wnosi do rekordu czytanego przez dane zapytanie z całej klauzuli FROM. Ma to znaczenie, gdy operator strumieniowy zmienia szerokość schematu, na przykład tworząc okno.
Przykład używa kanonicznych deklaracji z całego rozdziału - core0 ma dwa pola (BYTE, INTEGER), core1 ma dwa pola (INTEGER, FLOAT), schematy są równoliczne:
DECLARE a BYTE, b INTEGER   STREAM core0, 0.1 TEXTFILE 'sensor_a.txt'
DECLARE c INTEGER, d FLOAT  STREAM core1, 0.2 TEXTFILE 'sensor_b.txt'

SELECT core0[_] * core1[_] STREAM scaled FROM core0 + core1
Po przeprowadzeniu kompilacji:
$ xretractor -c query.rql
core0(1/10)	sensor_a.txt
	a: BYTE
	b: INTEGER
core1(1/5)	sensor_b.txt
	c: INTEGER
	d: FLOAT
scaled(1/10)	tail=1
	:- PUSH_STREAM(core0)
	:- PUSH_STREAM(core1)
	:- STREAM_ADD
	scaled_0: INTEGER
		PUSH_ID(scaled[0])
		PUSH_ID(scaled[2])
		MULTIPLY
	scaled_1: FLOAT
		PUSH_ID(scaled[1])
		PUSH_ID(scaled[3])
		MULTIPLY
Symbol _ rozwinął się w dwa pola: scaled[0] * scaled[2] (czyli a * c) i scaled[1] * scaled[3] (czyli b * d). Odwołania do core0 i core1 zostały przetłumaczone przez aliasowanie na absolutne pozycje w schemacie złączonym. Typy wynikowe to INTEGER (BYTE * INTEGER) i FLOAT (INTEGER * FLOAT) - wynik równania typów w górę, opisanego w osobnym podrozdziale.
Szerokość liczona w klauzuli FROM
Jednopolowy strumień src wnosi pięć slotów, gdy w FROM znajduje się jego okno src@(1,5). Dzięki temu splot FIR można zapisać bez osobnego, nazwanego strumienia okna:
DECLARE value INTEGER STREAM src, 1/500 TEXTFILE 'data.txt'
DECLARE coef INTEGER[5] STREAM filter, 1 TEXTFILE 'coef.txt'

SELECT src[_] * filter[_] STREAM products FROM src@(1,5)+filter
SELECT products[0]        STREAM output   FROM SUMC(products)
Pierwsze zapytanie rozwija się do pięciu iloczynów. Jest równoważne dłuższej postaci:
SELECT * STREAM window FROM src@(1,5)
SELECT window[_] * filter[_] STREAM products FROM window+filter
SELECT products[0] STREAM output FROM SUMC(products)
W krótszej postaci kompilator sam wydziela okno z FROM jako substrat. Taki substrat jest przezroczysty podczas ustalania szerokości wkładu src. Nazwany przez użytkownika strumień window stanowi natomiast granicę schematu, dlatego dłuższa postać odwołuje się do window[_], a nie do src[_].
Operator stojący w FROM może także zmniejszyć szerokość. Reduktor zwija okno do jednego slotu, więc poniższe src[_] rozwija się tylko raz:
SELECT src[_] STREAM total FROM SUMC(src@(1,5))
Jeżeli jedno wyrażenie zawiera kilka indeksów [_], kompilator tworzy tyle kopii, ile wynosi najmniejsza z ustalonych szerokości ich wkładów. W typowym splocie okno i strumień współczynników mają tę samą szerokość.
Kompilator odrzuca odwołanie, gdy wskazany strumień nie występuje w FROM albo jego pola nie tworzą tam spójnego bloku. Przykładem drugiego przypadku jest src[_] pod oknem zbudowanym nad konkatenacją (src+other)@(1,5): pola obu źródeł są powtarzane wspólnie i nie da się przypisać src jednej szerokości bez zgadywania. Należy wtedy nadać podwyrażeniu własną nazwę i użyć [_] na tym nazwanym wyniku.
Symbol _ a przeplot
Aliasowanie składowych przez A[_] jest poprawne dla sumy +, ponieważ suma zachowuje osobne fragmenty schematów obu argumentów. Nie wolno stosować tej postaci do składowej osiąganej przez przeplot #:
SELECT A[_] - B[_] STREAM roznica FROM A#B
Po przeplocie pozycje A[k] i B[k] są tą samą pozycją wspólnego schematu, więc powyższe wyrażenie nie identyfikuje dwóch różnych wartości. Kompilator kończy taki plan błędem zamiast po cichu obliczyć wynik[k]-wynik[k].
Jeżeli _ ma przetwarzać rekord przeplotu, należy najpierw nadać wynikowi nazwę, a potem odwołać się do tego wyniku:
SELECT * STREAM przeplot FROM A#B
SELECT przeplot[_] * 2 STREAM przeskalowany FROM przeplot
Odzyskanie konkretnej składowej wymaga operatora rozplotu & albo %.
Ta funkcjonalność ma główne zastosowanie w algorytmach filtrów sygnałowych, w których wykonuje się wiele takich samych operacji na odpowiadających sobie elementach okna i wektora współczynników. Nie jest konieczna do osiągnięcia pełnej funkcjonalności RetractorDB, ale znacząco skraca takie zapytania. Kompletny przykład przedstawia rozdział Implementacja filtru sygnałowego.
Równanie typów w górę
Co się dzieje w przypadku, kiedy mnożymy dane typu BYTE z danymi typu INTEGER ? W systemie RetractorDB obowiązują ścisłe zasady równania typów w górę. Pomnożenie pola typu BYTE z wartością pola, które jest typu INTEGER spowoduje powstanie w schemacie typu pola INTEGER. To dzieje się na etapie kompilacji.
Na chwilę obecną system RetractorDB wspiera następujące typy danych:
| Typ | Opis |
|---|---|
| BYTE | wartości 0–255 |
| INTEGER | 4 bajtowe wartości dla liczb ze znakiem |
| UINT | podobnie jak INTEGER dla liczb bez znaku |
| RATIONAL | liczby wymierne |
| FLOAT | liczby zmiennoprzecinkowe |
| DOUBLE | liczby zmiennoprzecinkowe podwójnej precyzji |
| STRING | ciągi znaków |
STRING i RATIONAL są używane przez deskryptory, konwersje i wyrażenia; ich reprezentację i zachowanie sprawdzają testy ut_payload, ut_convertTypes oraz scenariusze integracyjne. Liczby zespolone i wymierne liczby zespolone Eisensteina pozostają poza aktualnym zestawem typów.
Przykład równania typów w praktyce - zapytanie scaled z rozdziału Przetwarzanie symbolu _:
SELECT core0[_] * core1[_] STREAM scaled FROM core0 + core1
core0 ma pola BYTE i INTEGER, core1 ma pola INTEGER i FLOAT. Po rozwinięciu _ kompilator wyznacza typy pól wynikowych:
| Wyrażenie | Lewy typ | Prawy typ | Typ wynikowy |
|---|---|---|---|
scaled[0] * scaled[2] | BYTE | INTEGER | INTEGER |
scaled[1] * scaled[3] | INTEGER | FLOAT | FLOAT |
Skąd bierze się typ pola wynikowego
Typ, długość i krotność pola wyznacza jeden przebieg kompilatora - compiler::inferFieldShapes() - który wykonuje program pola w odwrotnej notacji polskiej na stosie typów, dokładnie tak, jak expressionEvaluator wykonuje go na stosie wartości. Przebieg stoi po rozwiązaniu odwołań do pól i agregatów okiennych, a przed upraszczaniem wyrażeń, więc deskryptor nie zależy od żadnego przełącznika optymalizacji.
Do września 2026 na to samo pytanie odpowiadały cztery reguły lokalne, z których żadna nie widziała całego wyrażenia. Parser zaczynał od INTEGER i rozpoznawał FLOAT albo DOUBLE tylko wtedy, gdy rzutowanie było ostatnim tokenem programu; osobny przebieg wnioskował STRING; typ redukcji okiennej ustalał się jeszcze gdzie indziej. Stąd brały się trzy wyniki niezgodne z wartością, którą silnik do pola zapisywał: SELECT source[0] nad polem DOUBLE dawało INTEGER, to_float('2.5') * 2 dawało INTEGER, a to_integer(AVG(x : 10)) + 1 wracało do RATIONAL.
Reguły kontraktu
Czysty odczyt pola zachowuje jego typ i długość. Odczyt jednego elementu tablicy liczbowej daje pojedynczą wartość, więc krotność spada do jednego; STRING[N] jest jednym slotem i zachowuje swoją szerokość.
Operator dwuargumentowy (+, -, *, /, ^) daje typ o wyższym miejscu w porządku BYTE < INTEGER < UINT < RATIONAL < FLOAT < DOUBLE - z jednym wyjątkiem: BYTE z BYTE daje INTEGER. Nie jest to decyzja projektowa, tylko odwzorowanie języka: uint8_t + uint8_t promuje się w C++ do int i właśnie int ląduje w wyniku. Ta sama promocja obowiązuje potęgę typu dokładnego, bo a^k jest liczone tym samym mnożeniem, co zapisany wprost iloczyn.
Operator jednoargumentowy (-x, NOT x) zachowuje typ argumentu, z wyjątkiem NOT nad napisem: wynik logiczny ma typ INTEGER.
Porównania liczbowe dają typ operandów po zrównaniu, bez promocji BYTE. Porównanie napisów oraz NOT nad napisem dają INTEGER o wartości 1 albo 0. AND i OR biorą typ wyniku z lewego operandu, a gdy ten jest NULL - z prawego; jeżeli wybrany operand jest napisem, wynikiem jest INTEGER. Operatory te nie sięgają listy SELECT: żyją w warunku RULE.
Funkcje mają jedną wspólną politykę:
| Funkcje | Typ wyniku |
|---|---|
isnull, IsZero, IsNonZero, Length | zawsze INTEGER |
sin, cos, exp | zawsze DOUBLE; nad RATIONAL odrzucane |
Sqrt, tan, log, log2 | typ argumentu; nad RATIONAL odrzucane |
Ceil, Floor, round, trunc | typ argumentu |
Abs, null2zero | typ argumentu |
to_integer, to_float, to_double, to_string | typ docelowy |
sin, cos i exp liczą w double i zwracają DOUBLE również dla argumentów całkowitych. Pozostałe funkcje matematyczne liczą przez double i rzutują wynik z powrotem na typ argumentu: Ceil nad polem DOUBLE daje DOUBLE, a Sqrt nad INTEGER daje INTEGER. Jawne konwersje wyznaczają typ swojego wyniku także wtedy, gdy stoją w środku wyrażenia: to_float('2.5') * 2 jest FLOAT, a to_integer(AVG(x : 10)) + 1 jest INTEGER.
Siedem funkcji o niewymiernej przeciwdziedzinie - Sqrt, sin, cos, exp, tan, log i log2 - nie kompiluje się nad argumentem typu RATIONAL: kompilator odrzuca plan i wymaga jawnego to_double. Ma to znaczenie praktyczne, bo reduktory MIN, MAX, AVG i SUMC nad wejściem całkowitym lub wymiernym dają RATIONAL. Powód, komunikat błędu, zasięg bramki (obejmuje też warunek RULE ... WHEN) i wyjątek dla funkcji zaokrąglających opisuje rozdział Wyrażenia pól i funkcje skalarne; tutaj nie jest to powtarzane, żeby obie strony nie rozjechały się przy następnej zmianie.
Agregat okna rekordowego bierze typ z całego programu swojego argumentu, przepuszczonego przez tę samą regułę, co reduktory strumieniowe: źródło arytmetyczne (BYTE, INTEGER, UINT, RATIONAL) redukuje się do RATIONAL, żeby średnia nie traciła dokładności, a FLOAT i DOUBLE zostają sobą. Dlatego MIN(k : 4) nad polem INTEGER daje RATIONAL, ale MIN(to_double(k) : 4) daje DOUBLE.
NULL nie jest typem. Pole ma typ, a brak wartości jest znacznikiem w metadanych rekordu. Wyrażenie, które na danym rekordzie policzy się na NULL, nie zmienia przez to typu swojego pola. null2zero(x) przepuszcza typ argumentu, a zero zapisuje się w tym właśnie typie.
Propagacja przez plan
Operatory, które kopiują schemat operandu - SELECT *, przesunięcie >N, decymacja -r oraz rozploty & i % - niosą kształt pola producenta slot po slocie. Suma strumieni + skleja schematy obu wejść. Typ przechodzi przez dowolnie długi łańcuch strumieni pośrednich.
Przeplot # uzgadnia schematy obu wejść na każdej pozycji płaskiej. Wybiera wyższy typ, dla pozycji liczbowej jego szerokość, a dla napisów większą długość. Różniące się układy są konwertowane pole po polu; na przykład RATIONAL wraz z FLOAT daje FLOAT i może utracić dokładność. Dokładność wyboru indeksów przez przeplot i rozplot nie odwraca konwersji typu. Odtworzenie co do bajta wymaga wspólnego układu zachowującego reprezentacje obu wejść.
Operatory, które schemat syntetyzują, zachowują własny: reduktor MIN/MAX/AVG/SUMC w klauzuli FROM daje jedno pole: RATIONAL dla źródła całkowitego lub wymiernego, FLOAT dla FLOAT i DOUBLE dla DOUBLE. Okno @(krok, szerokość) daje pola typu najszerszego z rekordu źródła.
Deklaracja DECLARE jest umową z plikiem źródłowym i nie podlega wnioskowaniu - żaden przebieg kompilatora jej nie zmienia.
Zmiana formatu artefaktu
Poprawne typowanie zmienia .desc i układ rekordu tam, gdzie dotąd wychodził INTEGER: DOUBLE zajmuje 8 bajtów zamiast 4, więc przesuwa offsety kolejnych pól. Strumień policzony starszą wersją silnika ma artefakt o innym układzie i przy starcie zostanie odrzucony jako niezgodny schemat - tak samo jak po każdej innej zmianie listy pól. Okresu zgodności nie ma: deskryptor opisuje teraz to, co silnik naprawdę zapisuje, a poprzednio opisywał co innego.
Debugowanie kompilacji
Kompilator transformuje plik .rql w plan wykonania przez kilka etapów. Efekt każdego etapu jest widoczny przez flagi diagnostyczne xretractor. Opisane tutaj narzędzia pozwalają odpowiedzieć na pytania: dlaczego schemat wygląda inaczej niż napisałem? skąd ta delta? dlaczego pojawił się substrat?
Podstawowe narzędzie: flaga -c
Flaga -c (--onlycompile) zatrzymuje xretractor po kompilacji i drukuje skompilowany plan na standardowe wyjście - bez uruchamiania przetwarzania:
xretractor -c query.rql
Kod wyjścia 0 oznacza sukces. Kod 1 - błąd kompilacji. Komunikaty błędów trafiają na stderr:
xretractor -c query.rql 2>errors.txt
echo $?
Kompilację można wywołać nawet gdy inny proces xretractor już działa - flaga -c nie próbuje przejąć blokady wykonania.
Jak czytać plan kompilacji
Dla kanonicznego query.rql z tego rozdziału plan wygląda następująco:
core0(1/10) sensor_a.txt
a: BYTE
b: INTEGER
core1(1/5) sensor_b.txt
c: INTEGER
d: FLOAT
merged(1/10) tail=1
:- PUSH_STREAM(core0)
:- PUSH_STREAM(core1)
:- STREAM_ADD
core0_0: BYTE
PUSH_ID(merged[0])
core0_1: INTEGER
PUSH_ID(merged[1])
core1_2: INTEGER
PUSH_ID(merged[2])
core1_3: FLOAT
PUSH_ID(merged[3])
result(1/10) tail=1
:- PUSH_STREAM(merged)
result_0: BYTE
PUSH_ID(result[0])
result_1: INTEGER
PUSH_ID(result[2])
result_2: BYTE
PUSH_ID(result[0])
result_3: INTEGER
PUSH_ID(result[2])
core2(3/10) sensor_c.txt
e: INTEGER
Każdy blok ma ustalony format:
nazwaStrumienia(delta)
:- operacjaStrumieniowa(arg)
nazwaPolaWyjściowego: TYP
instrukcja
...
| Element | Znaczenie |
|---|---|
nazwaStrumienia(delta) | Nazwa strumienia i jego interwał jako ułamek: 1/10 = 0.1 s = 10 Hz |
:- PUSH_STREAM(x) | Pcha strumień x na stos strumieniowy; pojawia się raz na każdy argument FROM |
:- STREAM_ADD | Operator sumy strumieni (+ w FROM) |
:- STREAM_HASH | Operator synchronizacji strumieni (# w FROM) |
:- STREAM_TIMEMOVE(n) | Przesunięcie w czasie (>n w FROM) |
pole: TYP | Pole schematu wynikowego po równaniu typów w górę |
PUSH_ID(s[n]) | Odkłada na stos wartość pola n ze strumienia s - tu widoczny efekt aliasowania |
PUSH_VAL(x) | Odkłada stałą x na stos |
ADD, MULTIPLY, … | Operacja arytmetyczna: zdejmuje dwa argumenty ze stosu, odkłada wynik |
Bloki efemerydów (DECLARE) pojawiają się na końcu planu - zawierają listę pól i ścieżkę do pliku danych.
Aliasowanie w planie: jeśli dwa pola wyjściowe wskazują na ten sam PUSH_ID, są aliasami. W przykładzie result_0 i result_2 oba to PUSH_ID(merged[0]) - potwierdzenie, że merged[0] i core0[0] to ta sama pozycja. Patrz Aliasowanie.
Substraty w planie: automatycznie wygenerowany substrat pojawia się jako blok z nazwą w stylu STREAM_HASH_core0_core1 - bez odpowiadającego SELECT w pliku źródłowym. Patrz Substraty.
Wizualizacja grafu zależności
Zamiast tekstu można wygenerować graf w formacie DOT i przetworzyć przez graphviz:
xretractor -c -d -f -t -s query.rql > out.dot && dot -Tsvg out.dot -o out.svg
Dostępne flagi modyfikujące wyjście DOT:
| Flaga | Pełna nazwa | Znaczenie |
|---|---|---|
-d | --dot | generuj wyjście DOT zamiast tekstowego planu |
-f | --fields | pokaż pola strumieni w węzłach grafu |
-t | --tags | pokaż programy poszczególnych pól (-f) |
-s | --streamprogs | pokaż sekwencje instrukcji stosu w węzłach |
-u | --rules | pokaż reguły RULE |
-p | --transparent | przezroczyste tło - do osadzania w dokumentach |
Graf pokazuje zależności między strumieniami jako krawędzie skierowane od źródeł do wyników. Substraty mają inny kolor niż strumienie jawnie zdefiniowane przez użytkownika. Patrz Budowa drzewa zależności.
NOTE: Opisana funkcjonalność ma pokrycie w teście:
issue31_docopisanym w załączniku pt. Testy Integracyjne.
Weryfikacja interwałów
Jeśli delta strumienia wynikowego jest niespodziewana:
- Sprawdź delty strumieni źródłowych - widoczne w blokach DECLARE na końcu planu.
- Sprawdź operator w klauzuli FROM - każdy operator ma inne równanie na deltę.
Przykład: core0(1/10) # core1(1/5) daje deltę 1/15 (średnia harmoniczna), nie 1/10. Jeśli spodziewałeś się 1/10, użyj + zamiast #. Pełne równania - patrz Rozwiązywanie interwałów.
Typowe błędy kompilacji
Niepoprawny literal lub interwał
Liczba spoza zakresu typu docelowego kończy parsowanie komunikatem numeric literal ... is out of range w Parse result:. Zerowy mianownik daje fraction ... has a zero denominator, a interwał równy zero - interval ... must be greater than zero. Dotyczy to zarówno pliku startowego, jak i żądania ad hoc; w drugim przypadku odmowa nie zatrzymuje serwera. Popraw liczbę lub wybierz dodatni interwał. Sam komunikat Circular dependency oznacza cykl zależności, a nie zerowy interwał.
Cykl w grafie zależności
[error] Circular dependency: stream interval resolution stalled with N
>> unresolved streams
Strumień odwołuje się pośrednio lub bezpośrednio do samego siebie. Wygeneruj graf przez -d - cykl będzie widoczny jako pętla. Patrz Wykrywanie pętli.
Nieznany strumień
Odwołanie do strumienia, który nie został jeszcze zadeklarowany. Pliki .rql przetwarzane są sekwencyjnie - SELECT nie może odwoływać się do strumienia zdefiniowanego niżej w pliku. Przesuń DECLARE lub SELECT wyżej.
Niezgodność krotności schematów przy _
Oba strumienie w wyrażeniu core0[_] * core1[_] muszą mieć schematy tej samej liczności. Sprawdź ile pól ma każdy z argumentów w blokach DECLARE planu. Patrz Przetwarzanie symbolu _.
Plik danych niedostępny
Błąd ten nie pojawia się przy -c - flaga weryfikuje poprawność zapytania, nie sprawdza czy pliki danych istnieją. Błąd dostępu do pliku pojawi się dopiero przy uruchamianiu przetwarzania bez -c.
Realizacja zapytań
Proces realizacji opiera się na ciągłym przeglądzie drzewa zapytań i sekwencyjnym i hierarchicznym wywoływaniu procedur budujących kolejne krotki strumieni i kolejne schematy danych.
Opis algorytmu należy zacząć od przedstawienia procedury sekwencjonowania. W systemie, w którym realizowane są zapytania z różnorodnymi wartościami definiującymi czasokres pomiędzy tworzonymi i napływającymi kolejnymi danymi potrzebny jest sposób wyznaczenia kolejnych interwałów.
Przeanalizujmy na początek następujący przykład. Załóżmy że w systemie występują dwa strumienie danych. Jeden napływa co sekundę drugi co dwie sekundy. Algorytm sekwencjonowania powinien zaproponować sekundowy interwał czasu pomiędzy wywoływaniem procedury przeznaczonej dla strumienia pierwszego i dwusekundowy dla strumienia drugiego. W praktyce przedstawiona zostanie sekundowa siatka czasowa – w której wszystkie sekundowe węzły zostaną wypełnione procedurą budowy krotek ze strumienia pierwszego i w tej samej siatce czasu – drugi strumień dołączy swoje procedury co drugą sekundę.
Wyznaczona w trakcie kompilacji siatka czasu jest bardzo istotna – to ona definiuje jak często i w jakich odstępach będą przetwarzane strumienie danych, które węzły zostaną pokryte przez wygenerowane procedury przetwarzania strumieni danych.
Rozważmy trzy strumienie o interwałach 1/3 s, 1/2 s i 2/3 s. Regularna siatka obejmująca wszystkie ich terminy miałaby krok 1/6 s: interwały są odpowiednio jego dwu-, trzy- i czterokrotnością. Krok 1/5 s nie spełnia tego warunku. Implementacja TimeLine nie odwiedza jednak każdego punktu wspólnej siatki; wybiera najbliższą chwilę, w której przypada kolejny rekord co najmniej jednego strumienia.
Generator terminów zachowuje interwały 1/3 i 1/2, ponieważ każdy termin strumienia 2/3 jest już terminem strumienia 1/3. Po slocie zerowym kolejne chwile to 1/3, 1/2, 2/3, 1, 4/3, 3/2, 5/3 i 2 sekundy. Dla każdej chwili silnik sprawdza należność wszystkich strumieni; wspólne terminy obsługuje w jednym slocie. Szczegóły opisuje Algorytm przeglądu drzewa zapytań.
Analizując poniższy wywód może bardziej oczywiste staną się wspomniane w rozdziale komentarze generowane dla programu swirly przedstawiające generowane schematy kulkowe.
Algorytm przeglądu drzewa zapytań
Przegląd ogólny
Algorytm przeglądu drzewa zapytań realizowany jest przez dwa współpracujące komponenty: dataModel (logika przetwarzania) oraz executorsm (pętla czasowa i IPC). Przed wejściem w główną pętlę system wykonuje krok zerowy, po czym cyklicznie iteruje po minimalnym zbiorze interwałów czasowych (Rys. 42).
%% pdf-height: 55%
%%{init: {"markdownAutoWrap": false}}%%
flowchart TD
A([Inicjalizacja]) --> B
B["processZeroStep()<br/>BINFILE i TEXTFILE: bootstrapDeclaration()<br/>Rozgłoś deklaracje plikowe"] --> C
C["TimeLine::getNextTimeSlot()<br/>Wyznacz następny slot czasowy"] --> W
W["rtAbsoluteSleep()<br/>Czekaj do terminu: kotwica + czas slotu"] --> V
V["DEVICE: migawka należnych źródeł pod blokadą epoki<br/>awaitRecords() poza blokadami modelu"] --> D
D["collectAwaitedStreams()<br/>Pod blokadami epoki i core: dueMask_ oraz dueNames_"] --> E
E["dataModel::processRows(dueMask_, currentTimeSlot)<br/>Przebieg 1: deklaracje - bootstrap i publikacja DEVICE<br/>Przebieg 2: nie-deklaracje - obliczenia i zapis<br/>Przebieg 3: deklaracje plikowe - odczyt na następny slot"] --> F
F["broadcast(dueNames_, formatRow)<br/>Kolejki Boost IPC do klientów xqry<br/>Zwolnij blokadę epoki"] --> C
Rys. 42. Algorytm przeglądu drzewa zapytań – przegląd ogólny
Struktura danych: qTree
qTree (src/retractor/lib/qTree.cpp) rozszerza std::vector<query> i jest wektorem topologicznie posortowanych zapytań. Sortowanie odbywa się przez DFS po grafie zależności budowanym z query.getDepStream() (Rys. 43).
%%{init: {"markdownAutoWrap": false}}%%
graph TD
A["A (DECLARE)<br/>rInterval=1/3"] --> B["B<br/>SELECT FROM A<br/>rInterval=1/3"]
A --> D["D<br/>SELECT FROM A,B<br/>rInterval=1"]
B --> C["C<br/>SELECT FROM B<br/>rInterval=1/2"]
B --> D
Rys. 43. Przykładowy graf zależności dla qTree
Po sortowaniu topologicznym kolejność w wektorze: [A, B, C, D]. Zapytanie C zależne od B zawsze trafi po B w iteracji - gwarantuje poprawność obliczeń.
Metoda getAvailableTimeIntervals() wyodrębnia ze wszystkich zapytań unikalne wartości rInterval (z pominięciem dyrektyw kompilatora i wartości zerowych) - wynik to wejście do konstruktora TimeLine.
Minimalna siatka czasowa: TimeLine / CRSMath
TimeLine (src/retractor/lib/CRSMath.cpp) zarządza racjonalnymi interwałami czasowymi. Konstruktor redukuje zbiór interwałów - usuwa wielokrotności, zachowując tylko koprimalne:
Wejście: {1/2, 1, 4} → Wyjście: {1/2}
(1 = 2 × 1/2, więc redundantne; 4 = 8 × 1/2, więc redundantne)
Wejście: {1/2, 1/3} → Wyjście: {1/2, 1/3}
(żadne nie jest wielokrotnością drugiego)
getNextTimeSlot() wyznacza kolejny slot jako min(delta × counter[delta]) po wszystkich deltach. Poniższy diagram ilustruje sloty dla delt {1/2, 1/3} i aktywne zapytania w każdym z nich (Rys. 44):
%% pdf-width: 100%
timeline
title Sloty czasowe dla delt {1/2, 1/3}
section t = 1/3
A (rInterval=1/3) : B (rInterval=1/3)
section t = 1/2
C (rInterval=1/2)
section t = 2/3
A (rInterval=1/3) : B (rInterval=1/3)
section t = 1
A (rInterval=1/3) : B (rInterval=1/3) : C (rInterval=1/2) : D (rInterval=1)
section t = 4/3
A (rInterval=1/3) : B (rInterval=1/3)
section t = 3/2
C (rInterval=1/2)
Rys. 44. Minimalna siatka czasowa dla delt {1/2, 1/3}
Sprawdzenie isThisDeltaAwaitCurrentTimeSlot(inDelta) zwraca true, gdy ctSlot_ / inDelta ma mianownik równy 1 (slot jest całkowitą wielokrotnością delty zapytania).
Krok zerowy: processZeroStep()
Przed wejściem w pętlę executorsm::run() wywołuje dataModel::processZeroStep(). Metoda przetwarza wyłącznie deklaracje plikowe (BINFILE i TEXTFILE):
for (const auto &q : coreInstance_)
if (q.isDeclaration() && q.kind != sourceKind::device)
bootstrapDeclaration(q);
bootstrapDeclaration() przełącza bufor ze stanu empty do flux, wykonuje revRead(0) i fire(), po czym sprawdza stan armed. Po kroku zerowym rekord deklaracji plikowej jest w outputPayload, gotowy dla konsumentów. Pod tą samą blokadą epoki następuje rozgłoszenie deklaracji plikowych.
DEVICE nie ma kroku zerowego ani rozgłoszenia w tej fazie. Jego pierwszy rekord trafia do modelu dopiero na początku pierwszego należnego slotu, przed obliczeniem zależnych zapytań. Deklaracja plikowa dołączona ad hoc jest inicjalizowana przed konsumentami w swoim pierwszym należnym slocie, ponieważ nie uczestniczyła w kroku zerowym.
Główna pętla: filtrowanie i przetwarzanie
Harmonogram slotów
Przed przetworzeniem slotu pętla czeka na jego termin \(T_k = T_0 + t_k\). \(T_0\) to kotwica epoki, odczytana z zegara monotonicznego (CLOCK_MONOTONIC) tuż przed pierwszym slotem, a \(t_k\) to czas logiczny slotu zwrócony przez TimeLine::getNextTimeSlot(). Pętla śpi tylko przez czas pozostały do terminu (rtAbsoluteSleep()), w każdym trybie taktowanym - z opcją --realtime i bez niej. Termin jest wyznaczany od nowa z wymiernej osi planu z dokładnością do milisekundy: ułamek milisekundy obcina się w każdym terminie osobno, więc błąd zaokrąglenia się nie sumuje.
- Czas pracy slotu nie przesuwa harmonogramu. Obliczenia, reguły i czekanie na źródło
DEVICEzużywają część okresu. Dopóki mieszczą się w okresie, następny slot zaczyna się w swoim terminie, a opóźnienie nie narasta. - Chwilowe spóźnienie jest nadrabiane. Jeżeli slot skończy się po terminie następnego (np. długie czekanie na
DEVICEalbo regułaDO SYSTEM), zaległe sloty są przetwarzane kolejno i bez snu, aż wykonanie dogoni harmonogram. Potem pętla znów śpi do terminów pierwotnej siatki. Żaden slot ani rekord nie jest pomijany, a kolejność przetwarzania się nie zmienia. - Trwałe przeciążenie nie jest ukrywane. Gdy średni czas pracy slotu przekracza jego okres, zaległość rośnie bez końca: sloty są nadal liczone wszystkie i w tej samej kolejności, ale coraz później względem terminów. Kotwica nie jest przesuwana, więc opóźnienie pozostaje widoczne (np. w sondzie
wake_lag_ns). Nadrobienie następuje dopiero wtedy, gdy praca slotów znów mieści się w okresie z zapasem. - Wstrzymanie procesu zostawia zaległość. Proces wznowiony po
SIGSTOPod razu przetwarza zaległe sloty seriami. Na LinuksieCLOCK_MONOTONICnie płynie w czasie uśpienia systemu; na macOS płynie, więc tam także uśpienie maszyny zostawia zaległość do odrobienia.
Kotwica należy do epoki planu. Przyjęcie nowego planu (xqry --reset) buduje nową oś czasu i odczytuje nową kotwicę, więc nowa epoka nie dziedziczy zaległości poprzedniej. Import ad hoc nie przewija osi: nowe interwały dołączają do bieżącej osi od pierwszego wystąpienia po bieżącym slocie, a ich terminy liczą się od tej samej kotwicy.
Termin TIMEOUT źródła DEVICE liczy się od chwili rzeczywistej pobudki slotu, nie od jego terminu. W trybie --no-clock pętla nie śpi wcale. Opcja --realtime nie zmienia harmonogramu, tylko dodaje szeregowanie SCHED_FIFO, blokowanie stron pamięci i powinowactwo CPU (patrz Opcje wywołania - xretractor).
Sygnał zatrzymania (SIGINT, SIGTERM, SIGHUP), który przerwie sen pętli, kończy przebieg przed slotem, którego termin jeszcze nie nadszedł. Sen przerwany w inny sposób jest ponawiany do tego samego terminu, bez wyznaczania nowego okresu. Na Linuksie sygnał wysłany do procesu przerywa sen pętli; na macOS może trafić do wątku komunikacyjnego i wtedy, podobnie jak przy xqry -k, przebieg kończy się dopiero po bieżącym okresie.
NOTE: Harmonogram slotów ma pokrycie w teście integracyjnym
slot_schedulei w teście jednostkowymut_executor_rt.
Filtrowanie zapytań: collectAwaitedStreams()
Dla bieżącego slotu executorsm::collectAwaitedStreams() tworzy dwie równoległe reprezentacje należnych zapytań:
dueMask_.assign(coreInstancePtr->size(), 0);
dueNames_.clear();
std::size_t position = 0;
for (const auto &q : *coreInstancePtr) {
if (tl.isThisDeltaAwaitCurrentTimeSlot(q.rInterval)) {
dueMask_[position] = 1;
dueNames_.emplace_back(q.id);
}
++position;
}
dueMask_ jest wektorem char o długości całego planu: element równy 1 wskazuje należne zapytanie na tej samej pozycji w qTree. dueNames_ jest wektorem std::string_view z nazwami tych zapytań, używanym do rozgłaszania. Oba wektory zachowują pojemność między slotami.
Maska musi opisywać ten sam układ planu, który przetworzy processRows(). Dlatego powstaje pod blokadami w kolejności plan_epoch_mutex, potem core_mutex; blokada epoki pozostaje zajęta przez obliczenie slotu i rozgłoszenie. Import ad hoc może zmienić kolejność topologiczną planu, więc wyznaczenie maski przed zajęciem blokady epoki naruszałoby ten warunek. Ochrona epoki zabezpiecza również czas życia widoków nazw.
Przetwarzanie: processRows(dueMask, currentTimeSlot)
dataModel::processRows(std::span<const char> dueMask, currentTimeSlot) zajmuje core_mutex, sprawdza długość maski i odświeża tablicę uchwytów instancji po zmianie qTree::planRevision(). Uchwyty odpowiadają pozycjom w planie, co eliminuje powtarzane wyszukiwanie nazw w obliczeniach slotu. Instancje są przechowywane w qSet przez std::unique_ptr, więc zmiana układu mapy zachowuje ich adresy.
Przed wywołaniem processRows() wykonawca zbiera migawkę należnych źródeł DEVICE pod krótką blokadą epoki, a następnie wywołuje rdb::awaitRecords() poza blokadami modelu. Oczekiwanie wypełnia prywatne bufory akcesorów; publikacja danych do modelu odbywa się dopiero w processRows().
Funkcja wykonuje trzy przejścia po planie, uwzględniając tylko pozycje zaznaczone w masce (Rys. 45):
%% pdf-width: 100%
%% pdf-height: 85%
%%{init: {"htmlLabels": false, "flowchart": {"wrappingWidth": 260, "nodeSpacing": 20, "rankSpacing": 20, "padding": 10}}}%%
flowchart LR
subgraph P1["Przebieg 1"]
direction TB
S([processRows - dueMask]) --> D
D["Należne deklaracje<br/>Bootstrap źródeł w stanie empty<br/>DEVICE: publikacja rekordu bieżącego slotu"]
end
subgraph P2["Przebieg 2"]
direction TB
N["Należne nie-deklaracje<br/>Kolejność topologiczna"] --> X0
X0{"Minęły origin i ogon?<br/>Dostępne wejście dla pierwszego rekordu ad hoc?"} -->|tak| X1
X0 -->|nie| X5([pomiń zapytanie])
X1["constructInputPayload()<br/>buduje dane wejściowe z FROM"] --> XW
XW["computeWindowAggregates()<br/>redukuje historię dla okien SELECT"] --> X2
X2["constructOutputPayload()<br/>ewaluuje wyrażenia SELECT"] --> X3
X3["write()<br/>zapis na dysk lub do pamięci"] --> X4
X4["constructRulesAndUpdate()<br/>ewaluuje klauzule RULE"]
end
subgraph P3["Przebieg 3"]
direction TB
F["Należne deklaracje plikowe w stanie armed<br/>flux, revRead(0), fire()<br/>Pobierz rekord na następny należny slot<br/>DEVICE jest pomijany"] --> E([koniec])
end
P1 --> P2 --> P3
Rys. 45. Algorytm processRows - trzy przejścia przetwarzania
Rekordy DEVICE są publikowane przed konsumentami bieżącego slotu. Deklaracje plikowe przechodzą do kolejnego rekordu dopiero po konsumentach, i tylko w slotach należnych danemu źródłu. Zapytanie zaznaczone w masce może jeszcze nie emitować wyniku z powodu ogona lub początku logicznego (origin).
Okna rekordowe listy SELECT
Jeżeli zapytanie zawiera MIN/MAX/AVG/SUMC(wyrażenie : W), etap computeWindowAggregates() działa po zbudowaniu payloadu FROM, ale przed ewaluacją pól wynikowych. Dla indeksu logicznego n czyta rekordy wskazanego źródła od n-(W-1) do n. Gołe pole korzysta z bezpośredniego odczytu płaskiego slotu; ogólne wyrażenie jest obliczane osobno na payloadzie każdego rekordu historii.
Wartości NULL są pomijane, a okno bez wartości obecnych zapisuje NULL dla wszystkich czterech statystyk. Grupy o tym samym źródle, programie wyrażenia i szerokości współdzielą jedno przejście po historii. Wyniki trafiają do streamInstance::windowValues i stają się zwykłymi operandami constructOutputPayload(), dlatego można pisać na przykład 2*MIN(a : 5)+1 albo null2zero(AVG(a+b : 5)).
Rozgłaszanie wyników: broadcast()
Po każdym processRows() wywoływane jest broadcast(dueNames_, formatRow) pod nadal zajętą blokadą epoki - algorytm przedstawia Rys. 46:
%% pdf-width: 85%
%% pdf-height: 60%
%%{init: {"markdownAutoWrap": false, "flowchart": {"nodeSpacing": 25, "rankSpacing": 30, "padding": 6}}}%%
flowchart TB
A([dueNames_]) --> B["printRowValue()<br/>serializuj do<br/>Boost property_tree"]
B --> C{{"klienci subskrybujący<br/>strumień?"}}
C -->|brak| H([pomiń])
C -->|tak| D["kolejka brcdbr<id><br/>try_send(dane)"]
D --> E{{"kolejka pełna?"}}
E -->|nie| F([wysłano])
E -->|"tak - brak<br/>odbiorcy"| G["usuń kolejkę<br/>usuń id2StreamName_"]
Rys. 46. Algorytm broadcast – rozsyłanie wyników przez Boost IPC
printRowValue() buduje strukturę z nazwą strumienia, liczbą pól, wartościami i bitmapą null, zapisuje jako Boost info format i wysyła przez boost::interprocess::message_queue.
Pełny przykład: zapytania A, B, C, D dla delt
Rys. 47 przedstawia wybór należnych zapytań i kolejność faz dla planu [A, B, C, D] z grafu na Rys. 43. A jest źródłem plikowym z interwałem 1/3. Diagram opisuje harmonogram; faktyczna emisja wyniku zależy również od ogona i początku logicznego zapytania.
%% pdf-width: 85%
%% pdf-height: 65%
%%{init: {"markdownAutoWrap": false, "sequence": {"mirrorActors": false, "messageMargin": 22, "boxMargin": 6}}}%%
sequenceDiagram
participant TL as TimeLine
participant ES as executorsm
participant DM as dataModel
participant IPC as Boost IPC
ES->>DM: processZeroStep()
DM->>DM: A: bootstrapDeclaration() [armed]
ES->>IPC: broadcast(A)
TL-->>ES: nextSlot = 1/3
ES->>DM: processRows([1,1,0,0], 1/3)
DM->>DM: Przebieg 2: B, jeśli minęły origin i ogon
DM->>DM: Przebieg 3: A pobiera następny rekord
ES->>IPC: broadcast(A, B)
TL-->>ES: nextSlot = 1/2
ES->>DM: processRows([0,0,1,0], 1/2)
DM->>DM: Przebieg 2: C, jeśli minęły origin i ogon
Note over DM: A nie jest należne - bez odczytu
ES->>IPC: broadcast(C)
TL-->>ES: nextSlot = 2/3
ES->>DM: processRows([1,1,0,0], 2/3)
DM->>DM: Przebieg 2: B, jeśli minęły origin i ogon
DM->>DM: Przebieg 3: A pobiera następny rekord
ES->>IPC: broadcast(A, B)
TL-->>ES: nextSlot = 1
ES->>DM: processRows([1,1,1,1], 1)
DM->>DM: Przebieg 2: B, C, D w kolejności topologicznej
Note over DM: Każde zapytanie sprawdza origin i ogon
DM->>DM: Przebieg 3: A pobiera następny rekord
ES->>IPC: broadcast(A, B, C, D)
Rys. 47. Harmonogram przetwarzania zapytań A, B, C, D przy deltach {1/2, 1/3}
Nazwy przy broadcast oznaczają argument dueNames_, a nie gwarancję wysłania rekordu przez każde zapytanie. Drzewo zależności determinuje kolejność obliczeń w przejściu 2, a interwały wyznaczają maskę aktywnych węzłów. Gdy A jest źródłem DEVICE, pomija krok zerowy, oczekuje na dane przed obliczeniem należnego slotu i publikuje rekord w przejściu 1; przejście 3 wtedy go pomija.
Realizacja algebraiczna - powiązanie kodu z równaniami
Każdy kluczowy fragment algorytmu opisanego na tej stronie jest bezpośrednią realizacją równań z algebry regularnych serii czasowych i formalnych dowodów.
Operatory algebraiczne w SOperations.hpp
Plik src/include/SOperations.hpp koduje operatory algebry wprost jako funkcje na liczbach wymiernych:
| Operator | Symbol | Funkcja w kodzie |
|---|---|---|
| Przeplot | φ | Hash(Δa, Δb, i, retPos) |
| Rozplątanie lewostronne | Θ | Div(Δa, Δb, i) |
| Rozplątanie prawostronne | ∼Θ | Mod(Δa, Δb, i) |
| Różnica | δ | Subtract(Δa, Δb, i) |
| Agregacja i serializacja | Ψ | agse(offset, step) |
Każda z tych funkcji jest dosłownym przekładem wzoru z algebry. Div realizuje rozplątanie lewostronne:
return i + ceilR((i + 1) * deltaA / deltaB);
\[ a_{n} = c_{n+\left\lceil \frac{(n+1)\Delta_{a}}{\Delta_{b}} \right\rceil} \]
Mod realizuje rozplątanie prawostronne:
return i + floorR(i * deltaB / deltaA);
\[ b_{n} = c_{n+\left\lfloor \frac{n\Delta_{b}}{\Delta_{a}} \right\rfloor} \]
Hash implementuje test z definicji przeplotu - warunek \(\left\lfloor iz \right\rfloor = \left\lfloor (i+1)z \right\rfloor\) przy \(z = \Delta_{b}/(\Delta_{a}+\Delta_{b})\) - i zwraca odpowiedni offset do strumienia A albo B.
Pomocnicze funkcje floorR() i ceilR() operują wyłącznie na boost::rational<int>, nigdy nie przechodząc przez double. Jest to bezpośrednia realizacja wymagania z Twierdzenia 2: niejawne rzutowanie na float łamie założenia twierdzenia Fraenkela - materializacja do postaci zmiennoprzecinkowej musi być odłożona do momentu jawnego zastosowania podłogi lub sufitu.
TimeLine jako minimalna baza układu pokrywającego
Konstruktor TimeLine wyznacza pierwotny zbiór interwałów - usuwa wszystkie delty będące całkowitą wielokrotnością innej delty ze zbioru. Interwał jest pierwotny, gdy żaden mniejszy interwał z zestawu nie jest jego dzielnikiem z ilorazem naturalnym. Jest to wyznaczanie minimalnego układu pokrywającego (covering system) w rozumieniu twierdzenia Fraenkela: tylko pierwotne delty generują niezależne sekwencje Beatty’ego i tylko one są potrzebne do wyznaczenia pełnej siatki czasowej.
Metoda getNextTimeSlot() - opatrzona komentarzem // MAGIC Warning w źródle - generuje kolejne punkty siatki jako:
\[ t_{k} = \min_{\delta \in \mathrm{sr}} \left(\delta \cdot \mathrm{counter}[\delta]\right) \]
gdzie sr to pierwotny zbiór interwałów, a \(\mathrm{counter}[\delta]\) zlicza dotychczasowe „trafienia“ każdej delty. Pętla dwufazowa - osobno wyznaczenie minimum, osobno inkrementacja liczników - gwarantuje poprawną obsługę kolizji: kilka delt może wyznaczać ten sam slot jednocześnie.
ℹ️ Info
Komentarz
// MAGIC Warningw źródleCRSMath.cppoznacza, że algorytm jest poprawny z nieoczywistego powodu. Nie wystarczy intuicja - poprawność gwarantuje twierdzenie Fraenkela. Ponieważsrzawiera wyłącznie pierwotne interwały (żaden nie jest wielokrotnością innego), liczniki poszczególnych delt nigdy nie „wychodzą przed siebie“ w sposób, który pominąłby lub zdublował slot. Kolizja - gdy dwie delty wskazują na ten sam slot - jest przypadkiem legalnym i jest obsługiwana przez drugą pętlę. „Magia“ polega na tym, że prosta formułamin(δ·counter[δ])z automatyczną inkrementacją jest równoważna pełnemu generatorowi sekwencji Beatty’ego dla całego układu pokrywającego.
isThisDeltaAwaitCurrentTimeSlot() jako test przynależności do sekwencji Beatty’ego
boost::rational<int> value = ctSlot_ / inDelta;
return (value.denominator() == 1);
Test sprawdza, czy \(t_{\mathrm{slot}} / \Delta \in \mathbb{N}\) - czy bieżący slot jest całkowitą wielokrotnością delty zapytania. W języku teorii sekwencji Beatty’ego: punkt \(t\) należy do sekwencji o gęstości \(\Delta\) wtedy i tylko wtedy, gdy \(t/\Delta\) jest liczbą naturalną. Warunek na mianownik równy 1 wynika z arytmetyki boost::rational - ułamek jest zawsze w postaci zredukowanej, więc mianownik 1 oznacza dokładnie liczbę całkowitą bez żadnych zaokrągleń.
Zapytania Ad hoc
Przez zapytania Ad hoc rozumiemy zapytania kierowane do działającego systemu. W typowym scenariuszu jaki zakładano w przypadku rozwoju systemu, założono we wstępnie rozpatrywanych scenariuszach, że użytkownik systemu będzie znał wszystkie zapytania i źródła danych wymagane do uzyskania przetworzonych serii czasowych.
W trakcie rozwoju systemu pojawiły się jednak dodatkowe scenariusze, zakładające, że praca systemu nie powinna być przerywana a dodatkowe zapytania powinny zostać dołączone do planu realizacji zapytań. Tego typu funkcjonalność będziemy nazywać zapytaniami Ad hoc, dołączanymi do systemu w trakcie jego działania bez przerywania jego pracy.

Rys. 48. Przepływ sterowania dla zapytań Ad Hoc
Na Rys. 48 przedstawiono opisany powyżej przepływ sterowania. Plik z zapytaniami i dyrektywami najpierw jest kierowany do procesu xretractor. Następnie poprzez pamięć współdzieloną proces xqry pobiera dane z xretractor. Tym samym procesem możemy wysłać do procesu xretractor polecenie. W tym poleceniu zawieramy tekst dodatkowego zapytania, które xretractor powinien dołączyć do przetwarzanego drzewa.
Co można dołączyć w locie
Kanałem ad hoc można dołączyć dokładnie jedno polecenie SELECT, DECLARE albo RULE. Dyrektywy kompilatora oraz program zawierający kilka poleceń są odrzucane bez zmiany aktywnego planu.
Błąd składni lub niepoprawna wartość jest odsyłana klientowi wraz z powodem, a serwer nadal obsługuje następne polecenia. Parser odrzuca m.in. literały liczbowe poza zakresem, zerowy mianownik, interwał równy zero (w DECLARE oraz przy &, % i -) i pustą nazwę FILE. Jeśli dołączenie nie powiedzie się po imporcie, serwer przywraca poprzedni plan i wycofuje nowe roszczenia nazw strumieni i plików w magistrali. Tę samą komendę można ponowić po usunięciu przyczyny błędu.
Wycofanie importu obejmuje zarówno błąd zwrócony statusem, jak i wyjątek podczas importu, kompilacji lub rejestracji nowych strumieni. W drugim przypadku klient xqry -a wypisuje powód z odpowiedzi serwera, np. command processor failure: ..., i kończy się kodem niezerowym. Dotychczasowe strumienie pozostają dostępne, a odrzucone nazwy znikają z planu i magistrali. Obie drogi oraz ponowienie tej samej komendy sprawdza adhoc_register_rollback, w tym wariant -throw.
Jeżeli muteks magistrali przestanie działać podczas wycofywania importu, plan jest odtwarzany, lecz nowych roszczeń nie da się zwolnić. Pozostają zajęte do końca instancji; dziennik ERROR wymienia nazwy strumieni i ścieżki magazynów wraz z przyczyną. Odmowa importu nie gwarantuje w tym przypadku przywrócenia stanu rejestru magistrali.
Przed dołączeniem nowych strumieni serwer sprawdza katalog STORAGE, zachowane deskryptory, istnienie, rodzaj i prawo odczytu źródeł oraz możliwość otwarcia plików wyjściowych oraz odpowiednich .shadow. Deskryptor nowego SELECT musi zgadzać się z planem w schemacie i nie może wprowadzać REF, którego plan nie podaje; jego TYPE musi być obsługiwany. Kontrola obejmuje także deskryptory bez ROTATION i dla MEMORY, ponieważ import ich nie usuwa. Sprawdzane są wyłącznie nowe strumienie. Kontrola otwarcia nie tworzy nowych plików; dla nieistniejącego pliku sprawdza katalog nadrzędny. Odmowa zwraca klientowi przyczynę, np. cannot open output file, bez zmiany planu. Jeśli katalog przestanie być dostępny po tej kontroli, błąd otwarcia akcesora POSIX, POSIXSHD lub segmentu DEFAULT/DIRECT również wraca jako odmowa: serwer wycofuje import i nowe roszczenia w magistrali, pozostaje uruchomiony i pozwala ponowić polecenie. Ta obsługa późnego błędu nie obejmuje profilu STORAGE GENERIC.
Kolizja wygenerowanej nazwy substratu z innym programem jest odmową kompilacji (Fail local chain compiler:Substrate name '...' denotes two different programs), bez zakończenia serwera. Dotyczy także zwykłych nazw z podkreśleniami, takich jak A_B + C oraz A + B_C. Po odmowie można przesłać poprawione polecenie; kontrole sprawdzają it_plan_error_e4-run i it_storage_refusal-adhoc.
Nowe źródło można zadeklarować bez zatrzymywania pracującego silnika:
$ xqry -a "DECLARE a BYTE STREAM C, 1 TEXTFILE 'data3.txt'"
Kod wyjścia 0 bez komunikatu oznacza przyjęcie deklaracji. Deklaracja dołączona po kroku zerowym otrzymuje bazę indeksu logicznego w pierwszym należnym jej slocie. Jeżeli dołączone później zapytanie wymaga okna albo przesunięcia, emisja czeka, aż źródło zgromadzi pełną wymaganą historię. HOLD nie jest do tego potrzebny; pozostaje opcjonalną dyrektywą opóźniającą fizyczny odczyt. Ponowne DECLARE istniejącej nazwy jest odrzucane, a nie traktowane jako zmiana konfiguracji.
Przy kilku działających instancjach samo DECLARE nie wskazuje właściciela, ponieważ nie ma klauzuli FROM. Trzeba wtedy podać cel jawnie:
$ xqry --server pomiary -a "DECLARE a BYTE STREAM C, 1 TEXTFILE 'data3.txt'"
Dołączanie pierwszej deklaracji do serwera uruchomionego z pustym planem nie jest jeszcze obsługiwane; kanał ad hoc wymaga aktywnego modelu danych.
Reguła dołączana w locie może wykonywać DO DUMP albo DO SET. DO SYSTEM pozostaje dostępne tylko w pliku planu, z którego instancja startuje, ponieważ udostępnienie go przez IPC pozwalałoby klientowi wykonywać dowolne polecenia powłoki na koncie serwera. Ta sama granica obowiązuje na kanale xqry --reset, który też przenosi pełny plan, ale też nie niesie autorstwa: plan z regułą DO SYSTEM jest tam odrzucany w całości, chyba że operator świadomie ustawi service.unrestricted = true (→ xqry). Kanał ad hoc odmawia bezwarunkowo i tego klucza nie czyta. Cel ON musi być istniejącym strumieniem utworzonym przez SELECT.
Przy historycznym zakresie DUMP -H TO M warunek WHEN jest oceniany najwcześniej na rekordzie H+1 po dołączeniu, gdy H poprzednich rekordów również pochodzi już z tego okresu. Dla zakresu bez historii (H=0) ocena zaczyna się od pierwszego nowego rekordu. Magazyn MEMORY musi mieć co najmniej H+1 slotów; przy H > 0 i pojemności N <= H żądanie jest odrzucane bez dołączenia reguły. Dołączenie nie zwiększa pojemności istniejącego magazynu. Szczegóły opisuje Realizacja alarmowania.
xqry --server pomiary -a \
"RULE alarm ON temperatura WHEN temperatura[0] > 80 DO DUMP -10 TO 5"
Na strumieniu MEMORY powyższy przykład wymaga co najmniej 11 slotów; przy pojemności 10 żądanie jest odrzucane.
Przy wielu instancjach klient kieruje SELECT według właścicieli strumieni z FROM, a RULE według strumienia z ON. Zapytanie łączące źródła z kilku serwerów jest odrzucane. Nowe nazwy strumieni i pliki magazynu są zgłaszane w magistrali przed modyfikacją aktywnego planu, więc ad hoc nie może nadpisać zasobu innej instancji.
Ad hoc powiększa istniejący plan. Do jego pełnego, atomowego zastąpienia - także w instancji bezczynnej - służy xqry --reset plik.rql.
Zmienne planu i DO SET
Ad hoc widzi zmienne VAR aktywnego planu: może je czytać w SELECT i WHEN oraz zapisywać przez dołączoną regułę DO SET. Deklaracje VAR i LET są odrzucane; stałe LET z pliku planu nie są widoczne. Dla planu z przykładu histerezy można wysłać:
xqry --server pomiary -a "SELECT status[0], ?ALARM STREAM monitor FROM status"
xqry --server pomiary -a "RULE force_alarm ON status WHEN status[0] >= 300 DO SET ?ALARM = 1"
Reguła zaczyna oceniać warunek od następnego nowego rekordu celu. Jej zapis jest zatwierdzany na końcu slotu, więc staje się widoczny od kolejnego slotu. W konflikcie z regułą planu albo wcześniej dołączoną regułą ad hoc wygrywa później dołączona wyzwolona reguła. Nie ma osobnego klucza konfiguracji dla SET; odmowa DO SYSTEM pozostaje bez zmian.
Typ prawej strony musi być typem zmiennej. Odmowa nie zmienia wartości ani reguł aktywnego planu. Przyjęte ad hoc zachowuje stan istniejących zmiennych; przyjęty --reset tworzy nowy stan z deklaracji i usuwa reguły ad hoc poprzedniego planu. Reguła SET może wskazać istniejącą pojedynczą instancję generatora, np. cell$0; cała rodzina nie jest celem w żywym planie. Pokrycie: it_var_adhoc-run.
Kiedy zaczyna się strumień dołożony ad hoc
Plan zbudowany od początku pracy systemu numeruje rekordy od początku logicznego wyliczonego przez kompilator. Zapytanie dołożone po kroku zerowym nie ma takiej przeszłości - jego baza odpowiada pierwszemu należnemu slotowi, w którym runtime je obsłużył, a nie slotowi zerowemu planu. Import jest atomowy: skompilowane drzewo i jego instancje strumieni są publikowane pod wspólnym zamkiem, a pętla wykonania przebudowuje siatkę czasu bez cofania się, nawet jeśli nowe zapytanie wnosi nowe tempo.
Model może przyjmować komendy jeszcze przed krokiem zerowym, np. przy bramce --xqrywait (-x). Źródło plikowe dołączone w tym oknie należy do początkowego planu epoki: krok zerowy nadaje mu bazę wyliczoną przez kompilator i przygotowuje pierwszy rekord, tak samo jak źródłom z pliku planu. Źródła DEVICE nie mają odczytu w kroku zerowym; ich pierwszy rekord jest czytany w należnym slocie. W trakcie samego kroku zerowego wspólny zamek blokuje import do zakończenia inicjalizacji. Przypadek dołączenia źródła przed tym krokiem sprawdza it_hash_string-adhoc-zero-step.
NOTE: Zachowanie to ma pokrycie w teście
issue227_join_alignment(przypadekadhoc-origin).
Przykład
Przykład rozpoczniemy od przygotowania prostego zapytania:
DECLARE a BYTE STREAM A, 1 TEXTFILE 'data1.txt'
DECLARE a BYTE STREAM B, 2 TEXTFILE 'data2.txt'
SELECT * STREAM str1 FROM A+B
Plik z zapytaniem zapiszemy pod nazwą qplan1.rql. Do poprawnej realizacji zapytania konieczne jest również przygotowanie plików data1.txt i data2.txt. Proponuję wypełnić data1.txt kolejnymi liczbami od 1 do 6 każda w nowej linii, a w pliku data2.txt liczby od 10 do 15. W tak przygotowanym katalogu uruchamiamy polecenie
$ xretractor qplan1.rql
Bez ROTATION start usuwa wcześniejsze pliki wyników SELECT, więc dawny schemat str1 nie blokuje tego przykładu. Przy zachowaniu plików przez ROTATION niezgodny deskryptor jest odmową przed startem z komunikatem descriptor schema mismatch i ścieżką pliku. Operator musi przywrócić zgodny plan albo świadomie usunąć rodzinę plików strumienia i rozpocząć go od nowa. Import ad hoc zachowuje istniejące pliki i również odrzuca niezgodny deskryptor.
Proces xretractor rozpocznie przetwarzanie danych. Należy w tym momencie uruchomić kolejny terminal i wydać w nim polecenie:
$ xqry -d
name | duration | size | count | location | cap
-----+----------+------+-------+-----------+----
str1 | 1 | 48 | 24 | | 0
A | 1 | -1 | 3 | data1.txt | 1
B | 2 | -1 | 2 | data2.txt | 1
W postaci tabelarycznej wyświetli się co w danym systemie się przetwarza. Ile bajtów już napłynęło, z jakich plików dane są czytane. Ile danych zostało już przetworzonych. Oczekując bardziej opisowej formy możemy wydać następujące polecenie:
$ xqry -d -y
---
apiVersion: xqry/v1
streams:
- name: str1
delta: 1
size: 214
count: 107
- name: A
delta: 1
count: 86
location: data1.txt
- name: B
delta: 2
count: 43
location: data2.txt
Udzielona odpowiedź jest w formie yaml.
Aby dołożyć do systemu kolejne zapytanie musimy wydać polecenie:
$ xqry -a "SELECT * STREAM str2 FROM A#B"
Polecenie w tej formie wysyła do procesu xretractor nowe zapytanie. Brak komunikatu i kod wyjścia 0 oznaczają przyjęcie. System otrzymując je prowadzi kompilację i złączy drzewa planów zapytań; przy odmowie xqry zwraca kod niezerowy i zapisuje przyczynę diagnostyczną.
Jeśli zajrzymy ponownie do stanu systemu, zobaczymy następujący obraz:
$ xqry -d
name | duration | size | count | location | cap
-----+----------+------+-------+-----------+----
str2 | 2/3 | 10 | 10 | | 0
A | 1 | -1 | 23 | data1.txt | 1
str1 | 1 | 312 | 156 | | 0
B | 2 | -1 | 12 | data2.txt | 1
Lub tak:
$ xqry -d -y
---
apiVersion: xqry/v1
streams:
- name: str2
delta: 2/3
size: 7
count: 7
- name: A
delta: 1
count: 16
location: data1.txt
- name: str1
delta: 1
size: 298
count: 149
- name: B
delta: 2
count: 8
location: data2.txt
Przyglądając się dokładniej zapytaniom za pomocą polecenia xqry zobaczymy następującą odpowiedź systemu dla zapytania str1:
$ xqry -t str1 -y
---
apiVersion: xqry/v1
stream:
name: str1
delta: 1
query: SELECT * STREAM str1 FROM A+B
fields:
str1.A_0:
type: BYTE
str1.B_1:
type: BYTE
oraz dla zapytania str2:
$ xqry -t str2 -y
---
apiVersion: xqry/v1
stream:
name: str2
delta: 2/3
query: SELECT * STREAM str2 FROM A#B
fields:
str2.a:
type: BYTE
Jak widać dodatkowe zapytanie str2 zostało poprawnie złączone z istniejącym planem realizacji zapytania. Widać też że zebranych danych jest o wiele mniej w porównaniu z str1.
NOTE: Opisana funkcjonalność ma pokrycie w teście:
issue6_adhocopisanym w załączniku pt. Testy Integracyjne.
Realizacja alarmowania
Mechanizm alarmowania (dyrektywa RULE) jest nieodłączną częścią głównej pętli przetwarzania. Nie jest osobnym procesem działającym w tle - reguły są ewaluowane synchronicznie, w tej samej iteracji siatki czasowej co obliczenia SELECT. Daje to pewność, że alarm zawsze odnosi się do danych właśnie obliczonych, a nie z poprzedniego cyklu.
Miejsce RULE w cyklu przetwarzania
Przypomnijmy schemat funkcji processRows() opisanej w rozdziale Algorytm przeglądu drzewa zapytań. Dla każdego zapytania nie będącego deklaracją wykonywane są kolejno cztery kroki (Rys. 49):
%%{init: {"markdownAutoWrap": false}}%%
flowchart LR
A["constructInputPayload()"] --> B["constructOutputPayload()"]
B --> C["write()"]
C --> D["constructRulesAndUpdate()"]
Rys. 49. Kolejność kroków przetwarzania jednego zapytania
Krok czwarty - constructRulesAndUpdate() - to właśnie wykonanie wszystkich reguł przypiętych do bieżącego zapytania. Wywoływany jest po zapisaniu wyników SELECT na dysk, co oznacza, że reguła zawsze ocenia gotową, właśnie obliczoną próbkę strumienia.
Ewaluacja warunku WHEN
Każda reguła zawiera listę tokenów opisujących wyrażenie logiczne (pole condition struktury rule). W momencie ewaluacji system:
- Pobiera
outputPayloadbieżącego zapytania - to bieżąca próbka strumienia. - Przekazuje warunek do silnika
expressionEvaluator::eval()- tego samego silnika, który oblicza wyrażeniaSELECT. - Rzutuje wynik na wartość logiczną (
boolCast): każda niezerowa wartość liczbowa totrue, zero tofalse.
Jeśli warunek jest spełniony, wykonywana jest skojarzony z regułą akcja (DO SYSTEM, DO DUMP albo DO SET). Jeśli niespełniony - reguła jest pomijana bez żadnych efektów ubocznych. Pełny przepływ przedstawia Rys. 50.
%%{init: {"markdownAutoWrap": false}}%%
flowchart TD
A["Nowa próbka strumienia"] --> B["expressionEvaluator::eval(warunek, próbka)"]
B --> C{boolCast}
C -->|true| D{typ akcji?}
C -->|false| E([pomiń])
D -->|DO SYSTEM| F["system(polecenie)"]
D -->|DO DUMP| G["dumpManager::registerTask()"]
D -->|DO SET| I["Ewaluacja wartości i bufor zapisu"]
I --> H
F --> H["dumpManager::<br/>processStreamChunk()"]
G --> H
Rys. 50. Przepływ ewaluacji reguły
Akcja DO SET i granica slotu
constructRulesAndUpdate() oblicza prawą stronę SET na tym samym rekordzie i tych samych wartościach VAR co WHEN. Zapisuje wynik, także NULL, w buforze bieżącego slotu. Przy konkurencji o zmienną zachowuje zapis reguły o późniejszej pozycji w tekście planu. Reguły dodawane ad hoc otrzymują kolejne pozycje.
Dopiero udane zakończenie dataModel::processRows, po przesunięciu źródeł deklarowanych, przepisuje bufor do wartości bieżących. Wszystkie pola i reguły slotu czytają poprzedni stan; kolejność węzłów nie zmienia widoczności zapisu. Błąd przed tą granicą nie zatwierdza VAR, a następny slot czyści bufor; nie jest to wycofanie zapisanych rekordów lub zewnętrznych akcji. Ta sama granica obowiązuje w --until-eof i silniku osadzonym. Odczyt xqry --vars odbywa się między slotami, pod blokadą epoki planu.
Wczytanie lub reset planu buduje wartości z deklaracji, więc utrata zatrzasku po restarcie nie naprawia się samym zgromadzeniem okna. Semantykę i ograniczenia opisuje VAR i DO SET. Pokrycie: ut_dataModel, it_var_set-value, it_var_reset-run.
Akcja DO SYSTEM
Wywołanie DO SYSTEM jest najprostsze: system wywołuje ::system(polecenie) bezpośrednio w wątku przetwarzania. Wywołanie jest synchroniczne - xretractor czeka na zakończenie procesu przed przejściem do następnej reguły.
Kod wyjścia polecenia jest sprawdzany:
0- sukces, brak wpisu w logu.≠ 0- xretractor loguje błąd przez spdlog z kodem wyjścia.- Niepowodzenie
system()(np. brak powłoki) - logowany jako błąd krytyczny.
⚠️ Ostrzeżenie
Polecenie wykonywane jest synchronicznie. Długo trwające skrypty (np. wysyłanie dużych plików, wywołania sieciowe z timeoutem) opóźnią cały cykl przetwarzania. W takich przypadkach zaleca się uruchamianie procesu w tle:
DO SYSTEM 'mój_skrypt &'.
Akcja DO DUMP - szczegółowy algorytm
DO DUMP zapisuje wskazany zakres rekordów względem próbki t, dla której warunek reguły jest prawdziwy. Zakres jest półotwarty: [step_back, step_forward), przy czym step_back < step_forward; rekord o przesunięciu step_forward nie należy do zrzutu. Ujemne przesunięcia oznaczają historię, 0 próbkę bieżącą, a dodatnie przesunięcia próbki przyszłe. Obsługuje to klasa dumpManager.
- Zdarzenie - warunek
WHENprawdziwy dla próbkit, reguła wywołujedumpManager::registerTask() - Faza 1 - zapis historycznej części zakresu z bufora strumienia (albo ustawienie opóźnienia startu)
- Faza 2 - jeśli pozostały rekordy do zebrania,
processStreamChunk()dopisuje próbkę bieżącą i próbki przyszłe - Koniec - przy
dumpedRecordsToGo == 0najbliższeprocessStreamChunk()zamyka plik i usuwa zadanie bez dopisywania kolejnych rekordów
Faza 1: dane historyczne (przy rejestracji zadania)
W chwili wyzwolenia reguły - zaraz po stwierdzeniu, że warunek jest prawdziwy - dumpManager::registerTask():
- Usuwa istniejący wpis pod nazwą pliku zrzutu (
unlink()) i tworzy nowy plik przez POSIXopen()z flagamiO_RDWR | O_CREAT | O_EXCL | O_NOFOLLOW | O_CLOEXEC. Następnie usuwa z kolejki wcześniejsze zadania piszące pod tę samą nazwę pliku i zamyka ich deskryptory (zob. Retencja). - Jeśli
step_back < 0, odczytuje historyczną część zakresu[step_back, min(step_forward, 0)), czylimin(step_forward, 0) - step_backrekordów. Kompilator uwzględnia najdalsze wymagane przesunięcie historyczne przy wyznaczaniu pojemności strumienia. - Zapisuje te rekordy do pliku od najstarszego do najnowszego, bez rekordu na prawej granicy zakresu historycznego.
- Oblicza liczbę pozostałych rekordów:
dumpedRecordsToGo = (step_forward - step_back) - historyWritten, gdziehistoryWrittenoznacza liczbę rekordów zapisanych w kroku 3, równą zeru przy braku części historycznej. - Jeśli
step_back >= 0(opóźnienie startu), ustawiadelayDumpRecordsToGo = step_back.
Przykład: DUMP -3 TO 2
Przy rejestracji: zapisz próbki t-3, t-2, t-1 (historia)
Do zebrania: 2 próbki (t, t+1)
dumpedRecordsToGo = 2
Przykład: DUMP -5 TO -2
Przy rejestracji: zapisz próbki t-5, t-4, t-3
dumpedRecordsToGo = 0 - cały zakres jest już zapisany
Przykład: DUMP -5 TO 0
Przy rejestracji: zapisz próbki t-5, t-4, t-3, t-2, t-1
dumpedRecordsToGo = 0 - próbka t nie należy do zakresu
Przy step_forward <= 0 cały zrzut jest gotowy po rejestracji zadania. Najbliższe processStreamChunk(), wywoływane jeszcze przy obsłudze próbki t, usuwa zakończone zadanie i zamyka jego plik; nie dopisuje próbki bieżącej ani przyszłych.
Dla reguły z pliku planu zakres DUMP -H TO M (H > 0) wymaga co najmniej H+1 rekordów: H rekordów historii oraz rekordu bieżącego. Kompilator automatycznie powiększa pierścień STORAGE MEMORY do tej pojemności, także gdy nie podano RETENTION albo jego wartość jest mniejsza. Większe jawne RETENTION pozostaje minimum pojemności pierścienia. Dla magazynów plikowych DEFAULT i DIRECT z ograniczoną retencją kompilator odrzuca plan, jeśli retencja nie zapewnia H+1 rekordów nawet tuż po rotacji: musi zachodzić (segments - 1) * capacity + 1 >= H+1. Dotyczy to również retencji z konfiguracji [storage] default_retention.
Dla reguły dołączonej ad hoc historia musi powstać w całości po jej dołączeniu. Przy zakresie DUMP -H TO M reguła może po raz pierwszy ocenić warunek WHEN na rekordzie H+1 po dołączeniu: poprzednie H rekordów stanowi historię, a nowy rekord jest próbką bieżącą. Bez części historycznej (H=0) warunek jest oceniany już dla pierwszego nowego rekordu. Strumień MEMORY musi przechowywać co najmniej H+1 rekordów; żądanie sięgające głębiej jest odrzucane bez dołączenia reguły.
Faza 2: próbka bieżąca i dane przyszłe
Po rejestracji zadanie trafia do kolejki bookOfTasks[streamName]. dumpManager::processStreamChunk() jest wywoływane po ocenie wszystkich reguł dla próbki t, a następnie po każdej nowej próbce strumienia:
- Dla każdego aktywnego zadania w kolejce (
dumpedRecordsToGo > 0):- Jeśli
delayDumpRecordsToGo > 0- dekrementuj i pomiń (opóźnienie startu). - Wpp. - zapisz bieżącą próbkę do pliku i dekrementuj
dumpedRecordsToGo.
- Jeśli
- Gdy
dumpedRecordsToGoosiągnie 0 - zamknij deskryptor pliku i usuń zadanie z kolejki.
Pełna sekwencja dla DUMP -3 TO 2 przedstawiona jest na Rys. 51.
%% pdf-width: 85%
%% pdf-height: 55%
%%{init: {"markdownAutoWrap": false, "sequence": {"mirrorActors": false, "messageMargin": 22, "boxMargin": 6}}}%%
sequenceDiagram
participant SI as streamInstance
participant DM as dumpManager
note over SI: Próbka t - warunek TRUE
SI->>DM: registerTask(stream, {-3, 2, retention=0})
DM->>DM: Otwórz plik dump.tmp
DM->>DM: Zapisz t-3, t-2, t-1 (historia)
DM->>DM: dumpedRecordsToGo = 2
SI->>DM: processStreamChunk(stream)
DM->>DM: Zapisz t → dumpedRecordsToGo = 1
note over SI: Próbka t+1
SI->>DM: processStreamChunk(stream)
DM->>DM: Zapisz t+1 → dumpedRecordsToGo = 0
DM->>DM: Zamknij plik - zadanie gotowe
Rys. 51. Sekwencja zbierania danych przez DO DUMP –3 TO 2
Przypadek opóźnionego startu (step_back ≥ 0)
Gdy step_back jest nieujemny, zrzut nie zaczyna się od chwili zdarzenia, lecz od step_back próbek po zdarzeniu:
Przykład: DUMP 2 TO 5
Przy rejestracji: delayDumpRecordsToGo = 2
Próbka t → pomiń (delay=2→1)
Próbka t+1 → pomiń (delay=1→0)
Próbka t+2 → zapisz (dumpedRecordsToGo = 3→2)
Próbka t+3 → zapisz (dumpedRecordsToGo = 2→1)
Próbka t+4 → zapisz (dumpedRecordsToGo = 1→0) - koniec
Retencja (RETENTION N)
Bez klauzuli RETENTION każde wyzwolenie reguły zapisuje zrzut pod jedną nazwą <strumień>_<reguła>_dump.tmp. Z klauzulą RETENTION N pierwsze wyzwolenie reguły w danym przebiegu silnika tworzy _dump_0.tmp, a kolejne numery plików rotują modulo N: _dump_0.tmp, _dump_1.tmp, …, _dump_(N-1).tmp.
Nazwa pliku musi wskazywać jedną regułę. Plan, w którym dwie reguły DO DUMP mają ten sam rdzeń <strumień>_<reguła> - np. reguła b_c na strumieniu a i reguła c na strumieniu a_b - jest odrzucany przy wczytywaniu, a reguła dołączana ad hoc z takim rdzeniem dostaje odmowę. Porównanie nie rozróżnia wielkości liter, bo na systemie plików nieczułym na nią (domyślnie macOS) Ab_r i ab_R to ten sam plik, a poprawność planu nie może zależeć od hosta. Autor planu zmienia wtedy nazwę reguły albo strumienia.
Plik zrzutu zawsze powstaje od nowa. Silnik kasuje to, co leży pod jego nazwą - także dowiązanie symboliczne albo twarde, za którym nie podąża - i tworzy nowy plik na wyłączność (O_EXCL | O_NOFOLLOW). Zapis nie trafia więc do celu dowiązania podstawionego pod końcową nazwę zrzutu. Ta ochrona nie obejmuje podmiany katalogów nadrzędnych podczas rozwiązywania ścieżki; nie jest gwarancją atomowego ograniczenia zapisu do katalogu magazynu. Proces, który trzymał poprzedni zrzut otwarty, nadal widzi jego dawną zawartość. Błąd usunięcia, utworzenia lub pozycjonowania pliku zrzutu jest błędem I/O: xretractor kończy wykonanie z klasą środowiska K4 i kodem EIO (5 na Linuksie), podając nazwę pliku i przyczynę. Plik planu usługi pozostaje zachowany; zasady opisuje xretractor.
Zadania zrzutu czekają w kolejce bookOfTasks, jednej na strumień i wspólnej dla wszystkich jego reguł DO DUMP. Kolejka nie ma własnej pojemności i nie wypycha zadań: zadanie kończy się po zebraniu całego zakresu albo wtedy, gdy ta sama reguła odtworzy jego plik. Po utworzeniu nowego pliku registerTask() usuwa z kolejki wcześniejsze zadania piszące pod tę samą nazwę, a destruktor dumpTask zamyka ich deskryptory. Zastąpione zadanie nie pisze więc do pliku odłączonego od katalogu, a pod każdą nazwą zbiera dane tylko najnowsze wyzwolenie.
Reguła bez RETENTION ma zatem w toku najwyżej jedno zadanie i nowe wyzwolenie przerywa jej poprzedni, nieukończony zrzut. Reguła z RETENTION N ma najwyżej N zadań: nieukończony zrzut przerywa dopiero wyzwolenie, które po zawinięciu numeracji wraca do jego pliku, czyli N-te kolejne. Zadania innych reguł na tym samym strumieniu pozostają nietknięte - reguły nie ucinają sobie nawzajem zrzutów, także dwie reguły bez RETENTION. Liczba deskryptorów otwartych na strumieniu nie przekracza sumy tych limitów po jego regułach.
Jeśli step_forward > 0, ostatnia wymagana próbka ma przesunięcie step_forward - 1 względem zdarzenia i musi być zapisana przed wyzwoleniem, które ponownie użyje tego samego pliku (przy regularnych zdarzeniach: po N interwałach, a bez RETENTION po jednym). Dla step_forward <= 0 cały zrzut zostaje zapisany przy rejestracji.
Format pliku zrzutu
Plik zawiera surowe rekordy binarne bez żadnego nagłówka - każdy rekord ma rozmiar określony przez deskryptor (descriptor.getSizeInBytes()). Format jest identyczny z formatem używanym przez artefakty strumienia, co pozwala odczytać go narzędziem xtrdb po ręcznym podaniu schematu:
$ xtrdb
> storage <ścieżka>
> open <strumień>_<reguła>_dump { <typ> <pole> }
> list
> quit
Pełny zapis rekordu i błędy I/O
Zarówno przy kopiowaniu historii, jak i dopisywaniu bieżących próbek silnik ponawia write() do zapisania całego rekordu. Dodatni wynik krótszy od rozmiaru rekordu oznacza postęp, po którym zapisywane są pozostałe bajty. EINTR dopuszcza najwyżej pięć kolejnych ponowień; zapisanie kolejnych bajtów zeruje ten licznik. Licznik pozostałych rekordów zadania zmniejsza się dopiero po zapisaniu pełnego rekordu (#479).
Zapis bez postępu (write() zwracające 0) daje Errc::IO z errno=EIO; inny błąd zapisu zachowuje przyczynę systemową, np. ENOSPC, a wyczerpanie ponowień po przerwaniu zachowuje EINTR. Komunikat wskazuje ścieżkę oraz liczbę zapisanych bajtów wobec rozmiaru rekordu. xretractor kończy taki przebieg błędem środowiska K4 z kodem EIO i zachowuje plik planu usługi. Błąd po częściowym zapisie może pozostawić początek rekordu w pliku; zapis nie jest wycofywany. Ukończenie write() nie oznacza synchronizacji danych na trwały nośnik. Testy ut_dumpManager obejmują zapis w częściach z EINTR, brak postępu, ENOSPC, limit ponowień oraz błędy pozycjonowania i zapisu historii.
Kontrakt zrzutu: same wartości, bez NULL i bez przerw
Zrzut jest bezgłowym blokiem bajtów. dumpManager zapisuje wprost payload->span(), rekord po rekordzie, i nie tworzy przy nim żadnego pliku towarzyszącego: nie ma .desc, więc schemat trzeba znać z zewnątrz, i nie ma .meta, więc mapa NULL oraz przerwy w transmisji nie mają gdzie trafić. Rozszerzenie .tmp sugeruje plik roboczy, ale to artefakt końcowy - po zamknięciu deskryptora nie następuje żadne przemianowanie.
Wynika z tego jedna konsekwencja, którą trzeba znać przed użyciem zrzutu jako wejścia dla czegokolwiek:
| Co silnik wie o rekordzie | Co widzi czytelnik zrzutu |
|---|---|
pole ma wartość NULL - z nullfill, z luki transmisji, z przepełnienia arytmetyki, z dzielenia przez zero | wartość zastępcza typu: 0 dla BYTE, INTEGER, UINT, FLOAT i DOUBLE, 0/1 dla RATIONAL, bajty zerowe dla STRING |
przed rekordem była przerwa w transmisji (wpis gap w indeksie .meta) | nic - rekordy leżą jeden za drugim, bez znacznika |
| rekordu nie ma w ogóle, bo żądane okno sięga głębiej niż zgromadzona historia | rekord wyzerowany, nieodróżnialny od rekordu o wartościach zerowych |
Zero w pliku zrzutu jest więc nierozróżnialne od prawdziwego zera, od NULL i od rekordu, którego silnik nigdy nie miał. Nie jest to przeoczenie implementacji, lecz granica formatu: NULL i przerwa są pojęciami wnętrza silnika - żyją w mapie NULL payloadu i w indeksie .meta towarzyszącym artefaktowi, tam są przechowywane i tam są przetwarzane - a jednolitego sposobu zapisania ich na zewnątrz system na dziś nie ma. Zrzut jest migawką wartości, nie zapisem tego, co silnik wiedział.
Gdy potrzebna jest wierność, informację o braku niosą dwie inne drogi:
- artefakt strumienia (
SELECT … STREAM) wraz ze swoim plikiem.meta-xtrdbwypisuje mapęNULLi przerwy poleceniamimetaorazmetaraw(→ Pliki); - kanał klienta
xqry --jsonl, w którym brak wartości jest osobnymnullJSON-owym, per element pola tablicowego (→ API monitorowania strumieni).
Funkcja null2zero w zapytaniu trzecią drogą nie jest: zamienia brak na zero jawnie i w zapytaniu, więc jest konwersją stratną, a nie sposobem eksportu informacji o braku (→ Operatory agregujące).
Wiele reguł - kolejność ewaluacji
Do jednego strumienia można przypiąć wiele reguł. Wszystkie ewaluowane są w jednej iteracji constructRulesAndUpdate(), w kolejności ich deklaracji w pliku .rql. Każda reguła jest niezależna - spełnienie jednej nie wpływa na ewaluację pozostałych (Rys. 52).
%%{init: {"markdownAutoWrap": false}}%%
%% pdf-width: 100%
flowchart TD
A["Nowa próbka strumienia S"] --> R1["Reguła 1: WHEN S[0] > 100"]
A --> R2["Reguła 2: WHEN S[0] < 10"]
A --> R3["Reguła 3: WHEN S[0] > 100"]
R1 -->|true| A1["DO SYSTEM 'notify-send'"]
R2 -->|true| A2["DO SYSTEM 'echo alarm'"]
R3 -->|true| A3["DO DUMP -5 TO 5"]
R1 -->|false| X1([pomiń])
R2 -->|false| X2([pomiń])
R3 -->|false| X3([pomiń])
Rys. 52. Niezależna ewaluacja wielu reguł na tym samym strumieniu
Ograniczenia i uwagi praktyczne
| Sytuacja | Zachowanie |
|---|---|
| Warunek spełniony dwa razy z rzędu (np. pomiar stale powyżej progu) | Każda próbka rejestruje nowe zadanie DUMP; bez RETENTION przerywa ono poprzedni nieukończony zrzut tej samej reguły, z RETENTION N - dopiero N-te kolejne wyzwolenie |
Dwie reguły DUMP o tym samym rdzeniu nazwy pliku (np. b_c na a i c na a_b, także różne tylko wielkością liter) | Plan jest odrzucany, reguła ad hoc dostaje odmowę; trzeba zmienić nazwę reguły albo strumienia |
Strumień wejściowy DECLARE jako cel ON | Błąd kompilacji - reguły można podpiąć wyłącznie pod SELECT |
| Reguła z pliku planu żąda rekordów sprzed początku strumienia | Część historyczna zrzutu nie jest skracana; nieistniejące rekordy są zastępowane zerami |
Za mało rekordów po dołączeniu reguły ad hoc (DUMP -H TO M) | Reguła czeka z oceną WHEN na rekord H+1 po dołączeniu; dla H=0 ocenia pierwszy nowy rekord |
Reguła ad hoc z historią H > 0 na MEMORY o pojemności N <= H | Żądanie jest odrzucane bez dołączenia reguły; potrzeba H+1 slotów na historię i rekord bieżący |
| Plik DUMP niedostępny podczas wykonania | Błąd I/O zwrócony przez Result; xretractor kończy działanie z kodem EIO, zachowując plan usługi. Brak katalogu STORAGE przy wcześniejszej kontroli jest odmową planu |
| DO SYSTEM zwraca niezerowy kod | Błąd w logu spdlog; przetwarzanie kontynuuje |
Ruchome okno danych AGSE
Ruchome okno danych to pojęcie powszechnie stosowane w systemach przetwarzających strumienie lub serie czasowe. Idea polega na grupowaniu danych w oknach czasowych, dając możliwość użytkownikowi możliwość przetwarzania w zamrożonych migawkach.
RetractorDB wspiera ten model przetwarzania danych poprzez operator AgSe (Agregacja i Serializacja). Operator ten jest dwuargumentowy i działa na strumieniu. Oznaczany znakiem @, ma postać:
strumień@(k, w)
gdzie:
- k - skok okna (dodatnia liczba naturalna): o ile elementów spłaszczonego strumienia przesuwa się okno przy każdym kroku,
- w - rozmiar okna (liczba całkowita różna od zera): ile elementów zawiera jeden rekord wyjściowy.
Spłaszczenie uwzględnia wszystkie elementy tablic liczbowych. Rekord z INTEGER[3] wnosi trzy elementy, a STRING[N] jeden element tekstowy. Skok liczony w rekordach i skok liczony w elementach są równe tylko dla źródła jednoelementowego.
Wartość dodatnia w zachowuje historyczną konwencję RetractorDB: najnowsze pole okna jest pierwsze. Wartość ujemna oznacza agregację lustrzaną - odwraca tę kolejność, więc pola są ułożone zgodnie z napływem.
Jak zmienia się interwał strumienia wyjściowego
Jeśli strumień źródłowy ma W spłaszczonych elementów w rekordzie i interwał Δ, to strumień wyjściowy operatora @(k, w) ma:
|w|pól w rekordzie wyjściowym,- interwał wyjściowy
Δ_out = (Δ / W) × k.
| Parametry | Efekt |
|---|---|
k = |w| | okno tumbling - kolejne okna nie zachodzą na siebie |
k < |w| | okno przesuwne (sliding) - kolejne okna zachodzą na siebie |
k > |w| | próbkowanie z przerwami - część danych jest pomijana |
k = 1, |w| = 1 | serializacja - wielopolowy rekord rozbijany na jednoelementowe |
w < 0 | agregacja lustrzana - kolejność napływu od najstarszego pola |
Typowe wzorce użycia
# serializacja: 2 pola → 1 pole (interwał ÷ 2)
SELECT * STREAM s1 FROM A@(1,1)
# tumbling window: 4 elementy, bez nakladania
SELECT * STREAM s2 FROM A@(4,4)
# sliding window: okno 5-elementowe przesuwane o 1
SELECT * STREAM s3 FROM A@(1,5)
# sampling: every fifth flattened element
SELECT * STREAM s4 FROM A@(5,1)
# deserialization: align pairs and restore arrival order
SELECT * STREAM s5 FROM (s1>1)@(2,-2)
Wizualizacja operatora @
Poniżej schematyczne przedstawienie działania source@(k, w) dla strumienia jednoelementowego:
Dane wejściowe: 0 1 2 3 4 5 6 7 8 9 ...
↓ ↓ ↓ ↓ ↓ ↓ ↓ ↓ ↓ ↓
@(1, 3) - sliding window, skok=1, okno=3:
[2,1,0] [3,2,1] [4,3,2] [5,4,3] ...
@(3, 3) - tumbling window, skok=3, okno=3:
[3,2,1] [6,5,4] ...
@(5, 1) - próbkowanie co 5 elementów:
[0] [5] ...
@(2,-2) - lustrzana, skok=2, okno=2:
[1,2] [3,4] [5,6] [7,8] ...
Okno jest stemplowane końcem przedziału: rekord o indeksie logicznym n obejmuje pozycje n·k−(|w|−1) … n·k, więc jego najnowsze pole leży dokładnie w pozycji n·k. Dzięki temu indeks logiczny okna oznacza tę samą chwilę co indeks logiczny źródła i złączenie okna z jego własnym źródłem (potok FIR) nie wyprzedza sygnału. Ilustracja powyżej pokazuje ciąg emitowanych okien; pierwsze z nich nosi indeks origin, nie zero.
Przy k = |w| emitowane okna są rozłączne, ale nie muszą zaczynać podziału od pierwszego elementu źródła. Dla @(3,3) pierwszy pełny rekord ma indeks 1 i obejmuje pozycje 1..3. Zmiana znaku w odwraca kolejność pól bez zmiany fazy; wyrównanie par przy deserializacji pokazuje przykład serializacji.
AGSE emituje dopiero pełne okno. Początkowe sloty, w których okno sięgałoby przed początek źródła, nie są rekordami i nie mają definicji - tworzą raportowany w planie origin=. Sloty, w których okno jest zdefiniowane, ale najnowsze pole jeszcze nie powstało, tworzą tail=. Prawdziwy NULL obecny w danych pozostaje natomiast elementem pełnego okna. Formalna granica ogona i pojemności historii jest opisana w rozdziale Ogony, początki logiczne i obserwowalność operatorów.
Przykłady
Poniższe podrozdziały prezentują konkretne zastosowania operatora AgSe:
- Przykład serializacji - zamiana wielopolowego rekordu na sekwencję jednoelementowych rekordów i powrót przez wyrównanie fazy oraz agregację lustrzaną.
- Przykład średniej ruchomej - sliding window jako podstawa filtru uśredniającego sygnał.
- Różne typy okien - tumbling, sliding i próbkowanie na jednym strumieniu danych.
Polecenia xqry --null w przykładach pomijają wiersze całkowicie NULL, w tym powiadomienia IPC sprzed pierwszego pełnego okna. Filtr pomija również prawdziwe wyniki całkowicie NULL; aby je obserwować, pomiń tę opcję. Kontrakt odbioru opisują opcje xqry.
Na początku rozważymy proces serializacji w operatorze Agregacji i Serializacji – AgSe.
NOTE: Opisana funkcjonalność ma pokrycie w testach:
agse1,agse2,agse3,Pattern6opisanych w załączniku pt. Testy Integracyjne.
Przykład serializacji
Na początku stwórzmy plik qplan3.rql o następującej zawartości:
DECLARE a BYTE, b BYTE STREAM A, 1 TEXTFILE 'data3.txt'
SELECT * STREAM str3 FROM A@(1,1)
Oraz przygotujmy plik data3.txt o następującej zawartości:
$ seq 0 9 | paste - -
0 1
2 3
4 5
6 7
8 9
Ostatnia, pusta linia jest istotna i znacząca. Po uruchomieniu xretractor qplan3.rql a w drugim oknie xqry -s str3 ujrzymy coś zbliżonego:
$ xqry --null -s str3
7
8
9
0
1
2
3
4
5
6
To co widzimy to przykład serializacji. Ciekawy aspekt operatora Agse w tym przypadku widać również w planie realizacji zapytania. Możemy zajrzeć do niego za pomocą polecenia:
$ xretractor -c qplan3.rql -f -p -d > out.dot && dot -Tsvg out.dot -o out.svg
W pliku out.svg zobaczymy następujący plan realizacji zapytania (Rys. 53):
Rys. 53. Plan realizacji zapytania po kompilacji AGSE
Ze strumienia źródłowego, w którym co sekundę przychodzą dane zawierające dwa bajty – tworzony jest strumień danych w którym co pół sekundy pojawia się jeden bajt.
Skoro mamy już w systemie strumień danych str3 zwracający sekwencyjne liczby – możemy go wykorzystać do dalszych transformacji. Dodajmy do pliku qplan3.rql następujące zapytanie:
SELECT * STREAM str4 FROM str3@(2,2)
Po uruchomieniu nie ujrzymy jednak oczekiwanej źródłowej postaci pliku dane3.txt. Pojawi się natomiast coś podobnego:
$ xqry --null -s str4
2 1
4 3
6 5
8 7
0 9
2 1
4 3
6 5
Wynik ma najnowsze pole jako pierwsze, a jego pary obejmują elementy o indeksach 1..2, 3..4 itd. Zmiana znaku szerokości odwraca kolejność pól:
SELECT * STREAM str4 FROM str3@(2,-2)
Pierwsze rekordy takiego strumienia to:
$ xqry --null -s str4
1 2
3 4
5 6
7 8
9 0
...
Kolejność napływu jest już zachowana, ale para 1 2 nadal łączy pola z dwóch sąsiednich rekordów źródła. Sam minus nie zmienia fazy okna. Aby odtworzyć pierwotne pary 0 1, 2 3 itd., zastąp ostatnie zapytanie następującym:
SELECT * STREAM str4 FROM (str3>1)@(2,-2)
Przesunięcie >1 sprawia, że pozycje 1..2 przesuniętego strumienia niosą elementy 0..1 strumienia str3. Ujemna szerokość układa je w kolejności napływu. Pierwszy rekord str4 ma indeks logiczny 1, a kolejne rekordy przywracają wartości i grupowanie źródła:
0 1
2 3
4 5
6 7
8 9
...
Generując obraz planu zapytania realizujący najpierw serializację a potem deserializację ujrzymy następującą zależność (Rys. 54):
%% pdf-width: 30%
flowchart BT
A["A: BYTE a, BYTE b; delta=1"] --> S["str3: A@(1,1); delta=1/2"]
S --> T["str3>1: phase alignment"]
T --> R["str4: @(2,-2); delta=1"]
Rys. 54. Serializacja, wyrównanie fazy i deserializacja
Zaprezentowano tutaj najbardziej podstawowy przykład zastosowania operatora ruchomego okna danych. Jeśli zaczniemy eksperymentować ze skokiem i rozmiarem okna, zauważymy, że jesteśmy w stanie stworzyć dowolne, przesuwające się okno nad strumieniem danych lub pominąć niektóre elementy budując skok większy od szerokości okna.
Historyczny zapis eksperymentu poniżej pokazuje serializację i odwracanie pól; nie obejmuje dodanego wyżej wyrównania fazy >1:

Animacja. Zapis sesji eksperymentu z serializatorem AGSE
NOTE: Opisana funkcjonalność ma pokrycie w testach:
agse1,agse2,agse3,Pattern6opisanych w załączniku pt. Testy Integracyjne.
Przykład średniej ruchomej
Średnia ruchoma (ang. moving average) to jeden z najprostszych i najczęściej stosowanych filtrów sygnałowych. Każdy punkt wyjściowy jest średnią arytmetyczną N ostatnich próbek. Operator @(1, N) w RetractorDB tworzy dokładnie takie okno: dla każdego nowego pomiaru dostępne jest N ostatnich wartości.
Dane źródłowe
Przyjmijmy strumień temperatury mierzonej co sekundę. Plik temp.txt zawiera kolejne odczyty:
$ seq 10 5 60 > temp.txt
10
15
20
25
30
35
40
45
50
55
60
Zapytanie RQL
Plik avg.rql:
DECLARE temp INTEGER STREAM sensor, 1 TEXTFILE 'temp.txt'
SELECT * STREAM avg5 FROM AVG(sensor@(1,5))
Co robi zapytanie
sensor@(1,5)tworzy przesuwne okno pięciu ostatnich odczytów temperatury. Interwał wyjściowy wynosi(1s / 1) × 1 = 1s, ponieważ źródło ma jeden element w rekordzie.AVG(...)redukuje pięć pól każdego pełnego okna do średniej. Dla wejściaINTEGERwynik ma typRATIONAL, więc zachowuje część ułamkową.
Ręczne zsumowanie pól INTEGER i podzielenie przez całkowite 5 obcinałoby wynik: dla [1,1,1,1,2] dałoby 1, a AVG daje dokładnie 6/5. Wartości NULL są pomijane; okno bez żadnej obecnej wartości daje NULL. Drugim sposobem zapisania tej średniej jest agregat historii SELECT AVG(temp : 5) STREAM avg5 FROM sensor, opisany w rozdziale Operatory agregujące.
Uruchomienie
$ xretractor avg.rql --xqrywait &
$ xqry --null -s avg5
Przykładowy wynik (okno wypełnia się po pierwszych 5 próbkach):
20/1
25/1
30/1
35/1
40/1
45/1
50/1
Pierwszy zapisany wynik to (10+15+20+25+30)/5 = 20, wypisany jako ułamek 20/1. Rekord artefaktu powstaje dopiero po uzyskaniu pełnego okna. Opcja --xqrywait wstrzymuje start do pierwszego polecenia klienta, dzięki czemu subskrypcja obejmuje pierwszy wynik. --null pomija w wyjściu klienta początkowe wiersze NULL przekazywane przez IPC; pomija też rzeczywiste wyniki całkowicie NULL.
Weryfikacja planu zapytania
$ xretractor -c avg.rql -f -p -d > out.dot && dot -Tsvg out.dot -o out.svg
W wygenerowanym planie widać źródło sensor, substrat okna AGSE i reduktor tworzący avg5. Okno ma pięć pól, a wynik średniej jedno pole typu RATIONAL. Kompilator wydziela substrat bez potrzeby nadawania mu osobnej nazwy w zapytaniu.
Zależność między parametrami okna a opóźnieniem
Przy pełnych danych średnia ruchoma o długości N ma opóźnienie grupowe (N-1)/2 próbek. Dla N=5 są to 2 próbki (2 sekundy). To własność filtru, odrębna od początkowego oczekiwania na pełne okno i od ogona startowego planu. Zwiększenie okna:
- zmniejsza szum (większe wygładzenie),
- zwiększa opóźnienie,
- nie zmienia interwału wyjściowego (przy stałym skoku k=1).
Zmiana skoku przy stałym oknie:
sensor@(5,5) -- tumbling: wynik co 5 sekund, bez nakładania
sensor@(1,5) -- sliding: wynik co sekundę, pełne nakładanie
sensor@(3,5) -- częściowe nakładanie: wynik co 3 sekundy
NOTE: Opisana funkcjonalność ma pokrycie w testach:
agse1,agse2,agse3,Pattern6opisanych w załączniku pt. Testy Integracyjne.
Różne typy okien
Operator @(k, w) przez dobór dwóch parametrów pozwala zbudować każdy z klasycznych typów okien stosowanych w przetwarzaniu strumieni. Poniżej zestawienie wzorców na jednym wspólnym strumieniu źródłowym.
Strumień źródłowy
Plik data.txt - 12 kolejnych liczb całkowitych:
$ seq 1 12 > data.txt
Deklaracja źródła - jeden rekord co sekundę, jedno pole:
DECLARE val INTEGER STREAM src, 1 TEXTFILE 'data.txt'
Tumbling window - okna bez nakładania
Skok równy rozmiarowi okna: k = w. Kolejne emitowane okna są rozłączne. Ich faza wynika ze stemplowania końcem okna, więc początkowy fragment wejścia może poprzedzać pierwsze pełne okno.
SELECT * STREAM tumbling FROM src@(4,4)
Interwał wyjściowy: 1s × 4 / 1 = 4s. Dwa pierwsze rekordy wyjściowe:
$ xqry --null -s tumbling
5 4 3 2
9 8 7 6
Pierwszy rekord ma indeks logiczny 1 i obejmuje pozycje źródła 1..4, czyli wartości 2..5. Dodatnia szerokość umieszcza najnowszą wartość na początku rekordu. Próbka 1 leży przed pierwszym pełnym oknem tego podziału.
Zastosowania: agregacja próbek w stałych przedziałach czasu (np. minutowe, godzinowe).
Sliding window - okna z nakładaniem
Skok mniejszy od rozmiaru okna: k < w. Każdy element wejściowy pojawia się w kilku kolejnych oknach.
SELECT * STREAM sliding FROM src@(1,4)
Interwał wyjściowy: 1s × 1 / 1 = 1s. Rekordy wyjściowe:
$ xqry --null -s sliding
4 3 2 1
5 4 3 2
6 5 4 3
7 6 5 4
...
Zastosowania: średnia ruchoma, detekcja trendów, filtry FIR (jak w implementacji filtru sygnałowego).
Próbkowanie - okna z przerwami
Skok większy od rozmiaru okna: k > w. Część elementów wejściowych jest pomijana.
SELECT * STREAM sampled FROM src@(3,1)
Interwał wyjściowy: 1s × 3 / 1 = 3s. Rekordy wyjściowe:
$ xqry --null -s sampled
1
4
7
10
Zastosowania: decimacja sygnału, redukcja częstotliwości próbkowania, diagnostyka co N-ty pomiar.
Okno lustrzane - odwrócona kolejność pól
Ujemna wartość w odwraca kolejność pól w rekordzie wyjściowym przy zachowaniu tego samego rozmiaru okna.
SELECT * STREAM mirrored FROM src@(2,-2)
Interwał wyjściowy: 1s × 2 / 1 = 2s. Rekordy wyjściowe (kolejność pól odwrócona):
$ xqry --null -s mirrored
2 3
4 5
6 7
8 9
...
Porównaj z src@(2,2), które dałoby 3 2, 5 4, 7 6 - najnowszą wartość jako pierwszą. Ujemna szerokość zachowuje kolejność napływu, ale nie zmienia fazy podziału na pary. Wyrównanie fazy przy odwracaniu serializacji opisano w przykładzie serializacji.
Zestawienie wzorców
| Zapytanie | Typ okna | Interwał | Rozmiar rekordu | Nakładanie |
|---|---|---|---|---|
src@(4,4) | tumbling | 4 s | 4 pola | brak |
src@(1,4) | sliding | 1 s | 4 pola | pełne |
src@(2,4) | hop window | 2 s | 4 pola | częściowe |
src@(3,1) | próbkowanie | 3 s | 1 pole | brak |
src@(2,-2) | lustrzane | 2 s | 2 pola | brak |
Plan realizacji zapytań
Wszystkie cztery warianty można uruchomić jednocześnie umieszczając je w jednym pliku .rql:
DECLARE val INTEGER STREAM src, 1 TEXTFILE 'data.txt'
SELECT * STREAM tumbling FROM src@(4,4)
SELECT * STREAM sliding FROM src@(1,4)
SELECT * STREAM sampled FROM src@(3,1)
SELECT * STREAM mirrored FROM src@(2,-2)
$ xretractor -c windows.rql -f -p -d > out.dot && dot -Tsvg out.dot -o out.svg
Plan zapytania pokaże cztery niezależne gałęzie wywodzące się ze wspólnego węzła src. Każda gałąź realizuje inny typ okna bez wzajemnych zależności.
NOTE: Opisana funkcjonalność ma pokrycie w testach:
agse1,agse2,agse3,Pattern6opisanych w załączniku pt. Testy Integracyjne.
Odtwarzanie strumienia
Serie czasowe bardzo często rozumiemy jako dane oznaczone znacznikami czasowymi. Dane zachowane np. w pliku możemy dowolnie przetwarzać – zachowując ich kolejność w oparciu o zarejestrowane zależności czasowe. System RetractorDB został wyposażony w możliwość ponownego wyemitowania takiego strumienia zachowując zarejestrowane zależności czasowe, tak jakby faktycznie ponownie te dane napływały.
W celu przedstawienia przykładu przygotujmy plik tekstowy wypełniony danymi np. od 30 do 45.
$ seq 30 45 > dane.txt
Tak przygotowany plik będziemy odtwarzać w systemie RetractorDB.
W kolejnym kroku stwórzmy następujący plik wypełniony zapytaniami dla systemu – query.rql zawierający tylko jedną deklarację zakończoną HOLD.
DECLARE a INTEGER STREAM core, 1 TEXTFILE 'dane.txt' HOLD
Uruchamiamy w jednym oknie polecenie:
$ xretractor query.rql
W kolejnym wydajemy polecenie:
$ xqry -s core
0
0
0
…
Zobaczymy ciąg zer …
W kolejnym oknie wydajemy następujące polecenie:
$ xqry -a "SELECT * STREAM ping FROM core VOLATILE"
Kod wyjścia 0 bez komunikatu oznacza, że zapytanie zostało przyjęte. W tym momencie w oknie prezentującym wartości ze strumienia core pojawią się wartości core.
$ xqry -s core
0
0
0
…
0
0
0
30
31
32
33
…
Nagrany przykład poniżej (Rys. 55):

Rys. 55. Nagrany przykład odtwarzania strumienia
Przykłady zastosowań
W niniejszym rozdziale zostaną przedstawione krótkie przykłady zastosowania systemu RetractorDB w rozwiązaniu konkretnych zagadnień spotykanych w konstrukcjach systemów monitorowania.
Każdy przykład jest kompletny - zawiera opis problemu, projekt zapytań RQL, uruchomienie oraz interpretację wyników. Przykłady można uruchomić samodzielnie: wymagane pliki danych i skrypty są opisane krok po kroku.
-
Przykład demonstruje, jak zrealizować cyfrowy filtr FIR bezpośrednio w strumieniu zapytań RQL, bez zewnętrznych bibliotek DSP. Zagadnienie jest reprezentatywne dla szerokiej klasy problemów przetwarzania sygnałów: filtracja szumów, separacja pasm częstotliwości, wygładzanie serii czasowych.
Przykład obejmuje:
- projektowanie współczynników filtru w programie GNU Octave (algorytm Remeza, metoda
remez()), - przeniesienie współczynników do pliku tekstowego i wczytanie ich jako strumień
DECLARE, - implementację splotu dyskretnego jako zestawu zapytań
SELECTz operatorem ruchomego okna@i rozwinięciem symbolu_, - wizualizację przebiegu filtracji w czasie rzeczywistym za pomocą
xqryignuplot.
Wynikiem jest działający system filtrujący sygnał pseudolosowy (50 Hz) do pasma 0–2 Hz, obserwowany na żywo podczas działania xretractor.
- projektowanie współczynników filtru w programie GNU Octave (algorytm Remeza, metoda
-
Analiza sygnałów EKG (MIT-BIH)
Przykład demonstruje zastosowanie RetractorDB do przetwarzania klinicznych sygnałów EKG z publicznej bazy MIT-BIH Arrhythmia Database (PhysioNet). Jest to złożony przypadek użycia łączący kilka mechanizmów systemu: wielokanałowe strumienie wejściowe, wieloetapowy potok filtracji FIR, adaptacyjny próg detekcji oraz wizualizację w czasie rzeczywistym.
Przykład obejmuje:
- przygotowanie danych: konwersja nagrań MIT-BIH (format WFDB) do plików tekstowych kompatybilnych z RetractorDB,
- implementację pięcioetapowego algorytmu Pan-Tompkins w RQL: filtr pasmowoprzepustowy → różniczkowanie → potęgowanie → całkowanie ruchome → detekcja progowa,
- wizualizację sygnału EKG i wyniku detekcji QRS w oknie gnuplot (tryb RTL - najnowsze próbki po prawej),
- interpretację wyników: odczyty interwałów RR, identyfikacja epizodów arytmii na rekordzie 205 MIT-BIH.
Wynikiem jest działający detektor QRS przetwarzający dwukanałowy sygnał EKG (MLII + V1) z częstotliwością 360 Hz, realizowany wyłącznie zapytaniami RQL bez specjalistycznych bibliotek.
-
Przykład demonstruje, jak z regularnego strumienia próbek zbudować świece OHLC (otwarcie, maksimum, minimum, zamknięcie) i narysować je na żywo razem z próbkami, z których powstały. Ta sama konstrukcja pasuje do każdego sygnału, który ogląda się w przedziałach: notowań, pomiarów czujników, obciążenia.
Przykład obejmuje:
- wygładzenie szumu agregatem okna rekordowego
AVG(... : 25), - okno rozłączne z agregacją lustrzaną
@(10,-10), które wyznacza granice świecy i kolejność jej próbek, - reduktory
MAXiMINw klauzuliFROMoraz złożenie świecy i jej próbek w jeden rekord operatorem+, - wizualizację w trybie
xqry --gnuplot-ohlcuruchamianą celemninja candlestick.
Wynikiem jest wykres 25 świec po 10 próbek, odświeżany co 0,2 s, w którym każda świeca stoi dokładnie nad próbkami, z których powstała.
- wygładzenie szumu agregatem okna rekordowego
Implementacja filtru sygnałowego
Zagadnienia związane z przetwarzaniem sygnałów cyfrowych zawierają w sobie problemy związane z filtracją. Celem filtracji jest rozdzielenie informacji zawartych wewnątrz sygnału. Zazwyczaj celem jest oddzielenie sygnału od jego zakłóceń.
Filtry mogą być analogowe oraz cyfrowe. W ramach proponowanego rozwiązania skupimy się na filtrach cyfrowych. Filtr cyfrowy implementowany jest jako ciąg operacji na kolejnych danych przetwarzanego sygnału w danym oknie czasowym. Z reguły dobierając filtr cyfrowy musimy zdecydować na jakie kompromisy musimy się zgodzić. Dodatkowo, możemy trafić na zabezpieczenia prawne związane z niektórymi algorytmami lub metodami [9].
Projektowanie filtru w Octave
Projektując filtr cyfrowy musimy określić jaki zakres częstotliwości chcemy wytłumić a jaki wzmocnić lub pozostawić nienaruszony. Parametry te określamy jako pasmo zaporowe i przepustowe. Jednym ze znanych mi narzędzi używanych do konstrukcji filtrów cyfrowych jest program GNU Octave (https://octave.org). Za pomocą tego narzędzia możemy wygenerować wymagane współczynniki do obliczeń prostego cyfrowego filtru sygnałowego.
Dla przykładu przyjmiemy następujące wartości wymagane do konstrukcji filtru sygnałowego:
- Częstotliwość próbkowania sygnału wejściowego 50Hz
- Pasmo przepustowe 0-2Hz
- Pasmo zaporowe 5-25Hz
Częstotliwość próbkowania sygnału wejściowego 50Hz oznacza że 50 próbek pojawi się w ciągu sekundy. W systemie RetractorDB oznacza to że sygnał źródłowy powinien napływać z szybkością Delta = 0,02. I taką częstotliwość powinno wspierać zdefiniowane źródło danych.
Dla takich założeń filtra sygnałowego program w języku Octave tworzący filtr sygnałowy przedstawia się następująco:
pkg signal load
filtord = 25 % Długość filtru
Fs = 50; % Częstotliwość próbkowania 50Hz
FNq = Fs/2; % Częstotliwość Nyquista
F1c = 2; % Pasmo przepustowe 0 - 2Hz
F2c = 5; % Pasmo zaporowe 5 Hz ->
F3c = 25; % Pasmo zaporowe <- 25 Hz
f=[0,F1c/FNq,F2c/FNq,F3c/FNq]
m = [ 1 , 1 , 0, 0 ]
freqz ( remez(filtord,f,m) );
Tak przygotowany plik powinniśmy zapisać na dysku lub wkopiować bezpośrednio do okna terminala programu Octave.
Parametry zmiennoprzecinkowe filtru możemy wyświetlić wydając polecenie remez(filtord,f,m). Graficzną charakterystykę filtru uzyskamy wydając następujące polecenie:
octave:1> [h, w] = freqz ( remez(filtord,f,m) );
subplot(2,1,1);
plot (f, m, '', w/pi, abs (h), '');
xlabel('Znormalizowana częstotliwość')
ylabel('wzmocnienie')
grid on
subplot(2,1,2);
plot(f,20*log10(m+1e-5),'', w/pi,20*log10(abs(h)),'');
xlabel('Znormalizowana częstotliwość')
ylabel('wzmocnienie (dB)')
grid on
Uruchomienie powyższego kodu w programie Octave zaprezentuje następującą odpowiedź w postaci graficznej (Rys. 56):

Rys. 56. Reprezentacja graficzna w dziedzinie częstotliwości wyznaczonego filtru cyfrowego
Na osi rzędnych Octave przedstawia znormalizowaną częstotliwość. Zakres prezentowanej na rysunku częstotliwości na osi rzędnych od 0 do 1 odpowiada częstotliwości od 0Hz do 25Hz. Na osi odciętych pierwszy rysunek prezentuje liniowe wzmocnienie, drugi tą samą wielkość ale w skali logarytmicznej.
Parametry filtru można wyświetlić za pomocą polecenia:
octave:11> remez(filtord,f,m)
ans =
-4.2689e-03
-2.0148e-02
-1.4865e-02
-1.8188e-02
-1.4031e-02
-4.5861e-03
…
Chcąc otrzymać stałoprzecinkowe parametry 16 bitowego filtru należy wydać polecenie:
octave:12> floor(remez(filtord,f,m) * 32767)
ans =
-140
-661
-488
-596
-460
Implementacja w systemie RetractorDB
Uzyskane wartości powinniśmy przenieść do pliku tekstowego o nazwie filterremez.txt
Dla celów testowych sygnał źródłowy pobierzemy z generatora liczb pseudolosowych. Dane efemeryczne pobierzemy bezpośrednio ze źródła z częstotliwością 50Hz.
Początkowa część pliku query.rql zapytania zawierająca deklaracje źródeł dla systemu RetractorDB przedstawia się następująco:
DECLARE coef INTEGER[25] STREAM filter, 1 TEXTFILE 'filterremez.txt'
DECLARE data BYTE STREAM source, 0.02 DEVICE '/dev/urandom'
W kolejnej części znajdują się polecenia tworzące proces przetwarzania sygnałów.
SELECT source[_] * filter[_] STREAM accRow FROM source@(1,25)+filter
SELECT accRow[0] STREAM output FROM SUMC(accRow)
SELECT int(output[0]/25/1000),source[0] STREAM outputAll FROM output+source
Pierwsze z trzech zapytań umieszcza okno bezpośrednio w klauzuli FROM. Indeks source[_] przyjmuje szerokość 25 slotów wnoszonych przez source@(1,25), dlatego kompilator tworzy 25 iloczynów z odpowiadającymi współczynnikami filter[_]. Nie jest potrzebny osobny, nazwany strumień okna; kompilator wydziela go jako substrat planu. Następnie SUMC(accRow) sumuje iloczyny, a ostatnie zapytanie łączy wynik filtru z bieżącą próbką źródła. Suma z SUMC ma typ RATIONAL, dlatego ostatnie zapytanie skaluje ją i rzutuje funkcją int(...) na liczbę całkowitą; bez rzutowania xqry wypisywałby ułamki postaci 2225159/12500, z których gnuplot odczytuje tylko licznik, i przebieg przefiltrowany znalazłby się poza zakresem osi.
Po rozwinięciu symbolu [_] plan zawiera wiele pól, więc pełny wynik kompilacji zajmuje kilka ekranów. Możliwy do szybkiej analizy podgląd procesu można uzyskać poleceniem:
$ xretractor -c query.rql -p -d > out.dot && dot -Tsvg out.dot -o out.svg
Ujrzymy następujący obraz (Rys. 57):
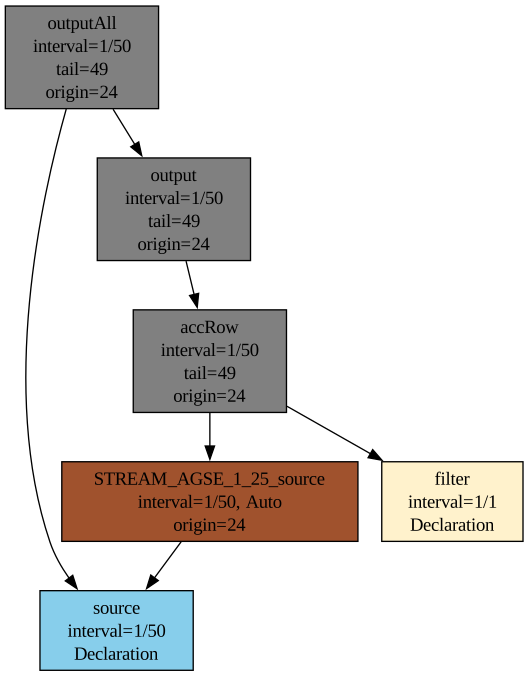
Rys. 57. Zależność przetwarzanych strumieni danych w trakcie realizacji filtru sygnałowego
Uruchomienie
Próba podejrzenia zawartych pól oraz typów danych spowoduje rozszerzenie wygenerowanego rysunku na tyle, że niemożliwe jest załączenie tutaj wygenerowanego wyniku bez utraty czytelności.
Pragnąc podejrzeć proces przetwarzania sygnałów w czasie rzeczywistym powinniśmy wydać następujący ciąg poleceń:
- w pierwszym oknie uruchomić proces serwera przetwarzający zgromadzone dane. Powinny się w tym katalogu znajdować pliki query.rql oraz filterremez.txt za pomocą polecenia
$ xretractor query.rql
- w drugim oknie wydać należy następujące polecenie:
$ xqry -s outputAll -p 50:256 | gnuplot
Na ekranie powinniśmy ujrzeć następujący wykres biegnący z lewa na prawo wypełniany na bieżąco danymi (Rys. 58):
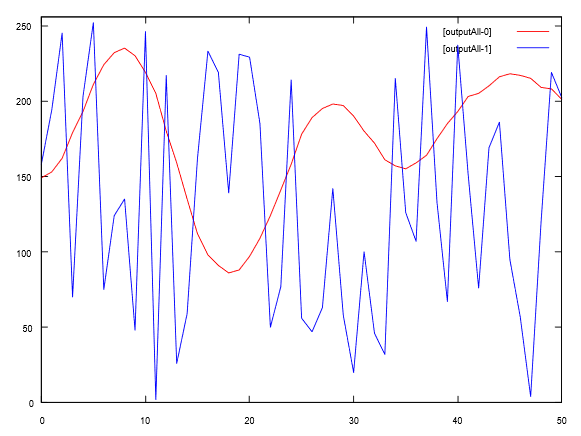
Rys. 58. Filtracja sygnału zrealizowana wewnątrz RetractorDB
Na Rys. 58 widzimy dwa wykresy nałożone na siebie. Ten bardziej zróżnicowany – na ekranie komputera widoczny jako niebieska linia zawierająca dużą zmienność to wizualizacja sygnału wejściowego. Dane pobrane z generatora liczb pseudolosowych z częstotliwością 50 próbek na sekundę. Oraz drugi wykres opływający dane wejściowe – na ekranie komputera prezentowany w kolorze czerwonym, bardziej łagodny, opływający – to właśnie dane przefiltrowane opracowanym filtrem sygnałowym. Sygnał, którego pasmo przepustowe zostało ograniczone do 0-2Hz (niskich częstotliwości) i ograniczone zaporowo w obszarze (5-25Hz) w obszarze wysokich częstotliwości. Obrazowo można powiedzieć, że wyizolowaliśmy linię melodyczną dla basów.
Należy pamiętać, że na ekranie komputera ten wykres przesuwa się w prawo bardzo szybko, prezentując obraz możliwości bieżącego przetwarzania danych realizowanych w systemie RetractorDB.
Zapis ekranu w trakcie realizacji procesu przetwarzania przedstawia Rys. 59:
.gif)
Rys. 59. Animacja procesu filtracji sygnału w czasie rzeczywistym
NOTE: Opisana funkcjonalność ma pokrycie w teście:
dspopisanym w załączniku pt. Testy Integracyjne.
Wizualizacja EKG i Detekcja Arytmii - baza MIT-BIH
Źródło danych - PhysioNet MIT-BIH Arrhythmia Database
Baza MIT-BIH Arrhythmia Database jest publicznie dostępnym zbiorem nagrań elektrokardiograficznych opublikowanym przez PhysioNet pod adresem:
https://physionet.org/content/mitdb/1.0.0/
Zawiera 48 półgodzinnych nagrań dwukanałowych zebranych od 47 pacjentów w Beth Israel Hospital w Bostonie w latach 1975–1979. Nagrania zostały manualnie zaadnotowane przez co najmniej dwóch niezależnych kardiologów i są szeroko stosowane w badaniach nad automatyczną detekcją arytmii.
Rekord 205
Przykład korzysta z rekordu 205 - nagrania 59-letniego mężczyzny leczonego Digoksyną i Quinaglutem. Rekord zawiera przypadki częstoskurczu komorowego (VT) i jest często cytowany w literaturze jako trudny diagnostycznie ze względu na dwie morfologicznie odmienne formy dodatkowych pobudzeń komorowych (PVC).
Parametry nagrania:
| Parametr | Wartość |
|---|---|
| Czas trwania | ≈ 30 min |
| Częstotliwość próbkowania | 360 Hz |
| Liczba próbek | 650 000 |
| Kanał 1 (MLII) | Zmodyfikowane odprowadzenie kończynowe II |
| Kanał 2 (V1) | Odprowadzenie przedsercowe V1 |
| Rozdzielczość | 12 bitów, wzmocnienie 200 LSB/mV, punkt zerowy 1024 |
Wartości surowe przechowywane są jako liczby całkowite bez jednostek (tzw. wartości ADC). Przeliczenie na miliwolty:
\[\text{mV} = \frac{\text{ADC} - 1024}{200}\]
Zakres rzeczywistych wartości w pliku rec205 mieści się w przedziale 589–1315 (MLII) i 718–1106 (V1), co odpowiada amplitudzie sygnału w granicach ok. ±1,5 mV.
Przygotowanie danych
Oryginalne pliki nagrania (205.hea, 205.dat, 205.atr) są dostarczane w formacie MIT-BIH i wymagają konwersji do formatu binarnego rozpoznawanego przez RetractorDB.
Format MIT-BIH 212
Sygnał w pliku 205.dat jest spakowany dwanaście-bitowo w formacie 212: każde trzy bajty przechowują dwie kolejne próbki obu kanałów według schematu:
[B0][B1][B2] → MLII = B0 | ((B1 & 0x0F) << 8)
V1 = B2 | ((B1 >> 4) << 8)
Wartości są 12-bitowe ze znakiem (zakres –2048..2047).
Konwersja do formatu RetractorDB
Skrypt examples/ecg/mitbih2rdb.py czyta nagłówek 205.hea, dekoduje pary próbek i zapisuje je jako rekordy int32 little-endian do pliku rec205:
650 000 rekordów × 2 pola × 4 bajty = 5 200 000 bajtów
Jednocześnie skrypt generuje skrypt RQL odtwarzający sygnał (rec205-replay.rql). Plik deskryptora rec205.desc jest tworzony przez build.sh.
Całość przygotowania uruchamia się jednym poleceniem z katalogu głównego projektu:
bash examples/ecg/build.sh
Wynikiem są trzy pliki w katalogu examples/ecg/rec205/:
| Plik | Generuje | Opis |
|---|---|---|
rec205 | mitbih2rdb.py | Dane binarne (int32 LE) |
rec205.desc | build.sh | Deskryptor strumienia |
rec205-replay.rql | mitbih2rdb.py | Skrypt RQL odtwarzania |
Zapytanie RQL
Plik rec205-replay.rql definiuje dwa strumienie:
DECLARE MLII INTEGER, V1 INTEGER STREAM ecg, 1/360 BINFILE 'rec205'
SELECT ecg.MLII, ecg.V1 STREAM s205out FROM ecg VOLATILE
Klauzula STREAM ecg, 1/360 określa interwał czasowy jednej próbki jako 1/360 s, co odpowiada rzeczywistej częstotliwości próbkowania 360 Hz. Słowo BINFILE (w deskryptorze TYPE BINFILE) powoduje, że plik rec205 jest czytany jako surowe rekordy binarne, sekwencyjnie w pętli (po ostatniej próbce odczyt wraca do początku), co umożliwia ciągłe odtwarzanie nagrania.
Strumień wyjściowy s205out jest zadeklarowany jako VOLATILE, dlatego nie jest zapisywany na dysk - dane trafiają wyłącznie do procesu konsumenta (xqry).
Wizualizacja na ekranie
Do wyświetlenia wykresu w czasie rzeczywistym służy cel ecg w systemie budowania. Uruchamia on skrypt scripts/xplot.sh, który startuje xretractor w tle, a następnie przepuszcza strumień danych przez xqry do gnuplot.
# z katalogu build/Debug
ninja ecg
Wywołanie rozwijane przez CMake:
scripts/xplot.sh s205out rec205-replay.rql 720,560,1360 --gnuplot-rtl
Znaczenie parametrów:
| Parametr | Znaczenie |
|---|---|
s205out | Nazwa strumienia wynikowego |
rec205-replay.rql | Plik zapytań |
720 | Szerokość okna danych (próbki widoczne jednocześnie) |
560,1360 | Zakres osi Y (wartości ADC pasujące do rzeczywistego sygnału) |
--gnuplot-rtl | Najnowsze próbki po prawej stronie, wykres przesuwa się od prawej do lewej |
Opcja --gnuplot-rtl jest parametrem xqry powodującym odwrócenie osi X gnuplota (set xrange [720:0]). Efekt jest taki, że najświeższe próbki pojawiają się po prawej stronie okna, a starsze przesuwają się w lewo - analogicznie do klasycznego wydruku EKG na taśmie papierowej.
Skrypt nadaje uruchamianemu serwerowi nazwę wyprowadzoną z katalogu roboczego i przekazuje ją do wszystkich wywołań xqry --server. Dzięki temu kilka celów wykresowych może działać równocześnie bez przejęcia cudzej instancji. Opcjonalny piąty argument pozwala podać inną nazwę; jeżeli jest już zajęta, skrypt kończy się przed usunięciem katalogu wynikowego.
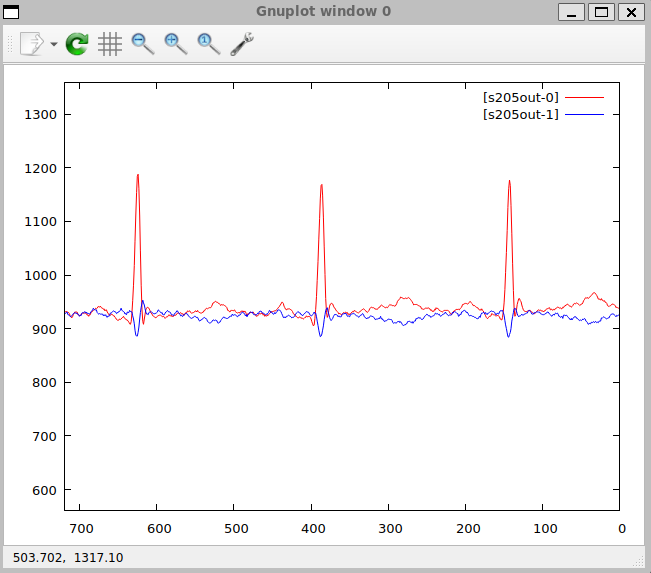
Rys. 60. Widok okna gnuplot z odtwarzanym sygnałem EKG (rekord 205)
Okno przedstawione na Rys. 60 prezentuje 720 próbek, czyli dokładnie 2 sekundy sygnału przy 360 Hz, co odpowiada typowej szerokości jednego paska EKG używanej w diagnostyce.
Detekcja QRS i identyfikacja arytmii
Kontekst - algorytm Pan-Tompkins
Detekcja zespołów QRS jest fundamentem automatycznej analizy EKG. Zespół QRS reprezentuje depolaryzację komór serca i odpowiada każdemu uderzeniu serca widocznemu jako ostry pik w sygnale. Znając położenia QRS w czasie, można wyliczyć interwały RR, a na ich podstawie rozpoznać podstawowe zaburzenia rytmu:
| Miara pochodna od QRS | Zastosowanie |
|---|---|
| Interwały RR | Częstotliwość akcji serca (HR), VT, bradykardia |
| Zmienność RR (HRV) | Autonomiczny układ nerwowy, przewidywanie zdarzeń |
| Morfologia QRS | Rozróżnienie PVC od normalnego rytmu, APC |
| Czas trwania QRS | Blok odnogi pęczka Hisa (BBB) |
Algorytm Pan-Tompkins (1985) jest klasycznym, pięcioetapowym potokowym algorytmem cyfrowego przetwarzania sygnałów realizowanym za pomocą filtrów FIR. RetractorDB implementuje go bezpośrednio jako strumień zapytań RQL, bez specjalistycznych bibliotek DSP.
Generowanie filtrów sygnałowych (coef)
Algorytm wymaga dwóch zestawów współczynników FIR, przechowywanych jako pliki tekstowe (bp_coef.txt, d_coef.txt). Generowane są jednorazowo skryptami Pythona przed uruchomieniem detekcji.
Filtr pasmowoprzepustowy - gen_bp_coef.py
Krok 1 algorytmu wymaga filtru wycinającego szumy i artefakty poza pasmem QRS. Pasm przepustowe 5–15 Hz przy fs = 360 Hz daje odpowiedź zawierającą morfologię QRS przy jednoczesnym tłumieniu linii bazowej (< 5 Hz) i szumów mięśniowych (> 15 Hz).
Metoda projektowania to okienkowy sinc (windowed sinc):
h_bp[n] = (h_lp2[n] − h_lp1[n]) · w[n]
gdzie:
h_lp[n] = 2·fc·sinc(2·fc·(n−M))- idealny filtr dolnoprzepustowyw[n] = 0,54 − 0,46·cos(2πn/(N−1))- okno Hamminga tłumiące efekty GibbsaM = (N−1)/2 = 12- punkt centralny filtru (opóźnienie grupowe = 12 próbek)
Parametry:
| Parametr | Wartość |
|---|---|
| Długość filtru N | 25 współczynników |
| Dolna f. graniczna fc₁ | 5 Hz (znorm. 5/360) |
| Górna f. graniczna fc₂ | 15 Hz (znorm. 15/360) |
| Skala całkowitoliczbowa | ×1000 (dzielona /1000 w RQL) |
Uruchomienie skryptu:
cd examples/ecg/rec205
python3 gen_bp_coef.py
# Zapisano 25 współczynników do bp_coef.txt
# Współczynniki: [-2, -2, -1, 0, 3, 8, 14, 23, 32, 41, 49, 54, 56, ...]
# Suma (wzmocnienie DC): 5 / 1000 = 0.0050
Współczynniki są symetryczne względem centrum (n=12), co potwierdza fazę liniową filtru - niezbędną właściwość przy analizie EKG, gdyż gwarantuje brak zniekształceń fazowych morfologii QRS.
Filtr różniczkujący - gen_d_coef.py
Krok 2 algorytmu stosuje filtr podkreślający strome zbocza QRS. Pan i Tompkins zaproponowali 5-punktowy estymator pochodnej:
y[n] = (1/8T) · (−x[n−4] − 2·x[n−3] + 2·x[n−1] + x[n])
Współczynniki (od najstarszej do najnowszej próbki):
h = [−1, −2, 0, 2, 1]
Właściwości filtru:
| Właściwość | Wartość |
|---|---|
| Suma współczynników | 0 (zerowe wzmocnienie DC - eliminuje offsety) |
| Maksymalna odpowiedź | f ≈ 10–25 Hz (zakres zbocza QRS) |
| Czynnik skali (1/8T) | 360/8 = 45 Hz (pomijany - nie wpływa na detekcję) |
cd examples/ecg/rec205
python3 gen_d_coef.py
# Zapisano 5 współczynników do d_coef.txt
# Współczynniki: [-1, -2, 0, 2, 1]
# Suma (wzmocnienie DC): 0 (powinno być 0)
Implementacja potoku w RQL - rec205-detect.rql
Plik rec205-detect.rql implementuje kompletny pięcioetapowy potok dla dwóch kanałów EKG (MLII i V1):
# Okna wydzielone automatycznie z FROM mają pozostać w pamięci
SUBSTRAT 'memory'
DECLARE MLII INTEGER, V1 INTEGER STREAM ecg, 1/360 BINFILE 'rec205'
DECLARE bp_coef INTEGER[25] STREAM bpf, 1 TEXTFILE 'bp_coef.txt'
DECLARE d_coef INTEGER[5] STREAM df, 1 TEXTFILE 'd_coef.txt'
# Wyodrębnienie kanałów
SELECT ecg.MLII STREAM mlii FROM ecg VOLATILE
SELECT ecg.V1 STREAM v1 FROM ecg VOLATILE
# 1. Filtr pasmowoprzepustowy (5-15 Hz) - splot FIR 25-tap
SELECT mlii[_]*bpf[_] STREAM bp_acc FROM mlii@(1,25)+bpf VOLATILE
SELECT int(bp_acc[0]/1000) STREAM bp_out FROM SUMC(bp_acc) VOLATILE
# 2. Różniczkowanie - splot FIR 5-tap
SELECT bp_out[_]*df[_] STREAM d_acc FROM bp_out@(1,5)+df VOLATILE
SELECT int(d_acc[0]) STREAM d_out FROM SUMC(d_acc) VOLATILE
# 3. Kwadrat (/1000 zapobiega przepełnieniu int32)
SELECT d_out[0]^2/1000 STREAM sq_out FROM d_out VOLATILE
# 4. Całkowanie ruchome 30 próbek (~83 ms)
SELECT int(sq_out[0]) STREAM mwi FROM AVG(sq_out@(1,30)) VOLATILE
# 5. Próg adaptacyjny - 2× średnia ruchoma 180 próbek (0,5 s)
SELECT int(mwi[0]) STREAM mwi_thr FROM AVG(mwi@(1,180)) VOLATILE
# Wyjście: MLII wycentrowane, V1 wycentrowane, sygnał detekcji ×5
SELECT mlii[0]-900, v1[0]-900, (mwi[0]-mwi_thr[0]*2)*5 \
STREAM detect_out FROM mlii+v1+mwi+mwi_thr VOLATILE
Uzasadnienie parametrów
Operator @(1,25) tworzy ruchome okno 25 próbek bezpośrednio w FROM. Indeks mlii[_] rozwija się zgodnie z 25 slotami, które to okno wnosi do rekordu wejściowego, a SUMC sumuje iloczyny z bpf[_]. W ten sposób splot dyskretny nie wymaga osobnego zapytania mlii_win. Ten sam zapis tworzy pięcioelementowy splot różniczkujący - patrz rozdział Przetwarzanie symbolu _.
Kompilator wydziela okna i reduktory z rozbudowanej klauzuli FROM jako własne substraty. VOLATILE dotyczy strumienia nazwanego w danym SELECT, nie tych automatycznych węzłów. Dyrektywa SUBSTRAT 'memory' utrzymuje cały potok pośredni w pamięci; bez niej wygenerowane okna korzystałyby z domyślnego składowania dyskowego.
Dzielenie bp_acc[0]/1000 w kroku 1 kompensuje skalę całkowitoliczbową współczynników filtru pasmowoprzepustowego. Drugie /1000, po potęgowaniu w kroku 3, ogranicza wzrost wartości; bez niego d_out[0]^2 mógłby przekroczyć zakres int32 (2 147 483 647) dla typowych amplitud EKG.
Potok liczy w arytmetyce całkowitej, dlatego każdy wynik reduktora wraca do INTEGER jawnym int(...) (skrót to_integer). SUMC i AVG nad polem INTEGER dają RATIONAL; bez rzutowania mianowniki rosną z etapu na etap (/1000, kwadrat, średnia z 30 próbek), aż boost::rational<int> przepełnia się bez ostrzeżenia.
Wyrażenie wyjściowe (mwi[0]-mwi_thr[0]*2)*5 implementuje próg adaptacyjny: wartość jest dodatnia tylko wówczas, gdy obwiednia MWI przekracza dwukrotność bieżącej średniej ruchomej - co wskazuje na wykryty QRS. Mnożnik ×5 skaluje sygnał detekcji do zakresu wizualnie porównywalnego z surowym EKG na wykresie.
Uruchomienie - ninja ecg-detect-qrs
Proces uruchamia się jedną komendą z katalogu build/Debug:
cd build/Debug
ninja ecg-detect-qrs
CMake rozwinął ten cel do polecenia:
scripts/xplot.sh detect_out rec205-detect.rql 720,-400,400 --gnuplot-rtl
Znaczenie parametrów:
| Parametr | Znaczenie |
|---|---|
detect_out | Nazwa strumienia wynikowego (3 pola) |
rec205-detect.rql | Plik zapytań z powyższym potokiem |
720 | Szerokość okna: 720 próbek = 2 sekundy przy 360 Hz |
−400,400 | Zakres osi Y w jednostkach ADC (≈ ±2 mV) |
--gnuplot-rtl | Najnowsze próbki po prawej stronie (prawo-lewo) |
Skrypt xplot.sh uruchamia xretractor w tle (kompiluje i wykonuje zapytania), a następnie przez xqry przekazuje strumień detect_out do gnuplot w trybie ciągłym. Okno gnuplot odświeża się przy każdej nowej paczce próbek.
Opis rysunku - okno gnuplot
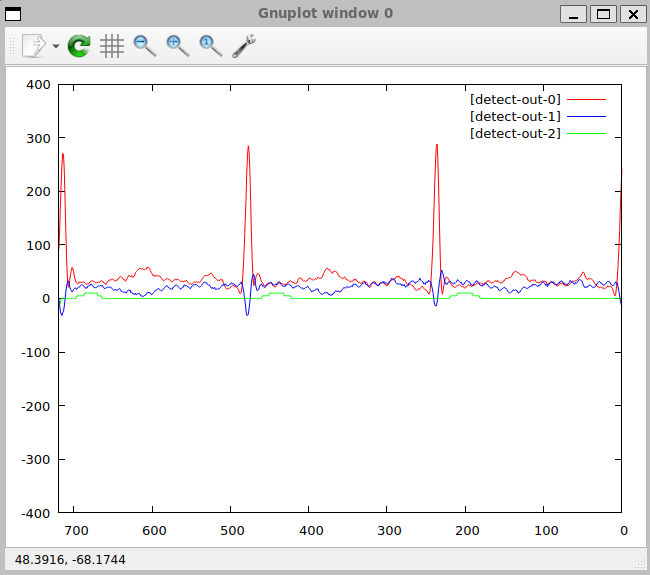
Rys. 61. Okno gnuplot uruchomionego celem ninja ecg-detect-qrs - rekord 205 MIT-BIH, 720 próbek (2 s), RTL
Na Rys. 61 widoczne są trzy sygnały odpowiadające trzem polom strumienia detect_out:
[detect-out-0] linia czerwona - MLII wycentrowane (mlii − 900)
Surowy sygnał EKG z odprowadzenia MLII przesunięty o punkt bazowy 900 ADC tak, że oś zerowa odpowiada izolinii. Dwa ostre piki (amplituda ≈ 280 ADC ≈ 1,4 mV) w okolicach próbek 520 i 350 od prawej krawędzi reprezentują dwa kolejne zespoły QRS. Wyraźna morfologia QRS z dominującym pikiem R potwierdza prawidłowe działanie filtru pasmowoprzepustowego - szumy zostały stłumione, a pik zachował amplitudę.
[detect-out-1] linia niebieska - V1 wycentrowane (v1 − 900)
Sygnał z odprowadzenia V1 tego samego nagrania. Morfologia QRS w V1 jest z reguły mniej wyrażona niż w MLII, co widać na rysunku - sygnał niebieski wykazuje mniejszą amplitudę piku R przy podobnych pozycjach czasowych QRS. Jednoczesna obecność obu kanałów pozwala różnicować pobudzenia nadkomorowe (APC) od komorowych (PVC), ponieważ QRS komorowe wykazują odmienną morfologię w V1.
[detect-out-2] linia zielona - sygnał detekcji QRS ((mwi − 2·mwi_thr) × 5)
Sygnał wyniku algorytmu. Wartość dodatnia oznacza wykryty zespół QRS - obwiednia całkowania ruchomego przekroczyła dwukrotność progu adaptacyjnego. Na rysunku widoczne są dwa wyraźne dodatnie impulsy pokrywające się w czasie z pikami QRS na kanale MLII. Między uderzeniami linia pozostaje blisko zera lub nieznacznie poniżej - potwierdzając specyficzność detekcji.
Odstęp między dwoma widocznymi QRS wynosi w przybliżeniu 170 próbek, co przy 360 Hz daje:
RR ≈ 170 / 360 ≈ 0,47 s → HR ≈ 127 bpm
Wartość ta mieści się w zakresie odnotowanego w rekordzie 205 częstoskurczu komorowego (VT, 79–216 bpm), co sugeruje że wizualizowany fragment nagrania pochodzi z jednego z 6 epizodów VT odnotowanych przez kardiologów MIT-BIH.
Schemat przepływu procesu
Poniższy diagram (Rys. 62) pokazuje kompletny przepływ danych od surowego nagrania MIT-BIH do identyfikacji arytmii, ze wskazaniem miejsca, w którym RetractorDB realizuje algorytm Pan-Tompkins, oraz powiązania z klasycznymi metodami rozpoznawania arytmii:

Rys. 62. Przepływ danych - od nagrania MIT-BIH przez potok Pan-Tompkins w RQL do wizualizacji i identyfikacji arytmii
Prawa gałąź diagramu - Identyfikacja arytmii - reprezentuje klasyczne metody analizy po detekcji QRS, które można zbudować jako kolejne zapytania RQL nadbudowane na strumieniu detect_out:
| Metoda | Opis | Powiązanie z QRS |
|---|---|---|
| Interwały RR | Czas między kolejnymi QRS → HR | bezpośrednio z pozycji detekcji |
| HRV (zmienność) | Odchylenie standardowe RR | statystyki strumienia RR |
| Klasyfikacja PVC | Szerokość QRS > 120 ms, morfologia V1 | szerokość okna mwi |
| Detekcja VT | Sekwencja ≥ 3 PVC z HR > 100 bpm | RULE na strumieniu HR+PVC |
| Detekcja APC | Wczesny, wąski QRS poprzedzający pauzę | morfologia MLII vs V1 |
RetractorDB udostępnia operatory RULE oraz reduktory okienkowe (AVG, SUMC), które umożliwiają implementację powyższych metod w tym samym języku zapytań RQL, bez wychodzenia poza środowisko systemu. Detekcja QRS jest pierwszym i niezbędnym etapem tej hierarchii.
Wykres świecowy (OHLC)
Wykres świecowy (ang. candlestick chart) jest podstawową formą prezentacji notowań w analizie technicznej. Każdy przedział czasu opisują cztery wartości: otwarcie (open), maksimum (high), minimum (low) i zamknięcie (close). Prostokąt świecy rozciąga się od otwarcia do zamknięcia, a knoty sięgają maksimum i minimum przedziału.
Przykład pokazuje, jak zbudować świece z regularnego strumienia wyłącznie zapytaniami RQL i jak xqry --gnuplot-ohlc rysuje je na wspólnej osi razem z próbkami, z których powstały. Źródłem danych są bajty losowe, wygładzone średnią kroczącą do przebiegu przypominającego kurs. Nie są to dane rynkowe - przykład demonstruje mechanizm, a nie analizę notowań.
Zapytanie RQL
Plik examples/candlestick/candlestick.rql:
STORAGE 'temp'
DEFAULT VOLATILE
DECLARE v BYTE STREAM source, 0.02 DEVICE '/dev/random'
SELECT int(AVG(source[0] : 25)) STREAM price FROM source
SELECT * STREAM bar FROM price@(10,-10)
SELECT * STREAM hi FROM MAX(bar)
SELECT * STREAM lo FROM MIN(bar)
SELECT bar[0], int(hi[0]), int(lo[0]), bar[9] STREAM ohlc FROM bar + hi + lo
SELECT * STREAM chart FROM ohlc + bar
Plan składa się z następujących strumieni:
| Strumień | Interwał | Pola | Rola |
|---|---|---|---|
source | 0,02 s (50 Hz) | 1 | bajty odczytywane z /dev/random |
price | 0,02 s | 1 | średnia krocząca z 25 próbek - „kurs” |
bar | 0,2 s | 10 | okno rozłączne: 10 próbek kursu w kolejności napływu |
hi | 0,2 s | 1 | maksimum rekordu bar |
lo | 0,2 s | 1 | minimum rekordu bar |
ohlc | 0,2 s | 4 | otwarcie, maksimum, minimum, zamknięcie |
chart | 0,2 s | 14 | świeca i dziesięć próbek, z których powstała |
Dyrektywa DEFAULT VOLATILE utrzymuje wszystkie wyniki i substraty w pamięci, więc przykład niczego nie utrwala na dysku (→ Klauzula VOLATILE). Katalog temp wskazany przez STORAGE musi jednak istnieć przed startem serwera.
Strumień price powstaje z agregatu okna rekordowego AVG(source[0] : 25). Agregat w liście SELECT redukuje pionowo, po kolejnych rekordach historii, więc zamienia biały szum w wolno zmienny przebieg, a interwał wyniku pozostaje równy interwałowi źródła. Średnia ma typ RATIONAL, dlatego zapytanie rzutuje ją funkcją int(...) na liczbę całkowitą - z tego samego powodu co w przykładzie filtru sygnałowego: gnuplot odczytałby z ułamka tylko licznik.
Strumień bar jest oknem price@(10,-10). Skok i szerokość są równe, więc jest to okno rozłączne (tumbling): każda próbka kursu trafia do dokładnie jednej świecy, a nowy rekord pojawia się co 10 × 0,02 s = 0,2 s. Ujemna szerokość oznacza agregację lustrzaną - pola są ułożone zgodnie z napływem, dlatego bar[0] jest najstarszą próbką okna (otwarcie), a bar[9] najnowszą (zamknięcie) (→ Różne typy okien).
Strumienie hi i lo używają reduktorów MAX(bar) i MIN(bar) w klauzuli FROM. Reduktor strumieniowy zwija poziomo pola jednego rekordu, więc daje maksimum i minimum dziesięciu próbek świecy przy niezmienionym interwale 0,2 s (→ Operatory agregujące). Wynik reduktora również ma typ RATIONAL, stąd int(hi[0]) i int(lo[0]) w kolejnym zapytaniu.
Agregat okna rekordowego nie zastąpiłby tu okna @. Zapis MAX(price[0] : 10) w liście SELECT przesuwa się o jeden rekord i emituje wynik co 0,02 s, czyli dałby dziesięć nakładających się świec na każdą właściwą. Dopiero okno rozłączne wyznacza granice świecy i jej interwał.
Suma bar + hi + lo łączy trzy strumienie o tym samym interwale w rekord o 12 polach, z których ohlc wybiera cztery wartości świecy. Ostatnie zapytanie, ohlc + bar, dokleja do świecy jej dziesięć próbek. Rekord chart ma zatem 14 pól: otwarcie, maksimum, minimum, zamknięcie i próbki w kolejności napływu. Ponieważ świeca i jej próbki przychodzą w jednym rekordzie, klient nie musi dopasowywać w czasie dwóch osobnych strumieni.
Tryb --gnuplot-ohlc
Opcja --gnuplot-ohlc jest modyfikatorem trybu -p / --gnuplot programu xqry (→ xqry). Oczekuje rekordu o układzie:
open, high, low, close, próbka_1, ..., próbka_N
Liczba próbek N wynika z długości rekordu (N = liczba pól - 4) i nie wymaga osobnego parametru. Rysowanie przebiega według następujących reguł:
- Każdy rekord daje jedną świecę, ustawioną nad środkiem przedziału zajmowanego przez jej N próbek. Korpus świecy ma szerokość 80% tego przedziału.
- Świeca, której zamknięcie jest nie mniejsze niż otwarcie, jest zielona (wzrostowa); pozostałe są czerwone (spadkowe). Próbki są rysowane niebieską linią.
- Pierwszy parametr
-pliczy próbki, tak jak w zwykłym trybie gnuplot. W oknie mieści się więc tyle świec, ile wynosi szerokość okna podzielona przez N. - Najnowsza próbka stoi w x = 0. Modyfikator
--gnuplot-rtlodwraca oś, więc najnowsze świece pojawiają się po prawej stronie. - Świeca, w której którakolwiek z czterech wartości jest
NULL, jest pomijana w całości; jej próbki pozostają na wykresie. - Rekord bez próbek (4 pola lub mniej) nie jest rysowany.
xqrywypisuje wtedy jednorazowo komunikat nastderr, np.xqry: --gnuplot-ohlc needs open, high, low, close and at least one sample; stream 'ohlc' sends 4. Standardowe wyjście trafia do gnuplota, więc bez tego komunikatu okno pozostałoby puste bez wyjaśnienia. - Wywołanie
--gnuplot-ohlcbez--gnuplotkończy się błędem--gnuplot-ohlc requires --gnuplot/-p mode.
Uruchomienie
Do wyświetlenia wykresu służy cel candlestick w systemie budowania:
# z katalogu build/Debug albo build/Release
ninja candlestick
CMake uruchamia w katalogu examples/candlestick wywołanie:
scripts/xplot.sh chart candlestick.rql 250,64,192 "--gnuplot-ohlc --gnuplot-rtl"
Znaczenie parametrów:
| Parametr | Znaczenie |
|---|---|
chart | Nazwa strumienia wynikowego |
candlestick.rql | Plik zapytań |
250 | Szerokość okna w próbkach - 25 świec po 10 próbek |
64,192 | Zakres osi Y; średnia z 25 losowych bajtów skupia się wokół 127,5 |
--gnuplot-ohlc --gnuplot-rtl | Tryb świecowy, najnowsze świece po prawej stronie |
Skrypt scripts/xplot.sh działa tak samo jak w przykładzie analizy sygnałów EKG: tworzy od nowa katalog temp, uruchamia nazwaną instancję xretractor w tle i przepuszcza strumień przez xqry do gnuplot.
Bez skryptu przykład można uruchomić w dwóch oknach terminala, z katalogu examples/candlestick:
$ mkdir -p temp && xretractor candlestick.rql
$ xqry -s chart -p 250,64,192 --gnuplot-ohlc --gnuplot-rtl | gnuplot
Rys. 63. Wykres świecowy strumienia chart - 25 świec po 10 próbek, najnowsze po prawej
Rys. 63 przedstawia jedną ramkę danych wysłaną przez xqry --gnuplot-ohlc --gnuplot-rtl, wyrenderowaną przez gnuplot. Każda świeca obejmuje dokładnie dziesięć próbek niebieskiej linii: dolna lub górna krawędź korpusu leży na pierwszej próbce przedziału (otwarcie), przeciwna na ostatniej (zamknięcie), a knoty sięgają najwyższej i najniższej próbki przedziału. Otwarcie kolejnej świecy leży blisko zamknięcia poprzedniej, ponieważ price jest średnią kroczącą i zmienia się płynnie między przedziałami.
NOTE: Tryb
--gnuplot-ohlcsprawdzają testy jednostkoweut_formatter: położenie świecy nad jej próbkami, szerokość okna liczona w próbkach, pomijanie świecy z wartościąNULLoraz rekord bez próbek.
Załączniki
W obszarze załączników znalazły się dokumenty, które nie są związane bezpośrednio z konstrukcją systemu, ale stanowią opis motywacji decyzji projektowych, dokumentację narzędzi oraz materiał pomocniczy dla osób wdrażających lub rozwijających system.
-
Budowanie produkcyjne i warianty diagnostyczne
Opis kontraktu bezpieczeństwa produkcyjnego
releaseoraz izolowanych trybówrelease-ablationiprobe. Rozdział przedstawia kontrolę czystości źródeł, jawne wartości przełączników optymalizatora, rozdzielenie katalogów CMake i Conan, weryfikację konfiguracji gotowej binarki oraz niezmiennik zgodności wyniku między wariantami. -
Wersjonowany kontrakt JSON Lines oraz opcjonalne biblioteki Python i C++ do obserwacji strumieni jawnie nazwanej instancji. Rozdział opisuje mapowanie typów, cykl życia subskrypcji, timeouty, ograniczone bufory, obsługę błędów oraz osobne cele budowania, instalowania i testowania API.
-
Opis historycznych okoliczności, które doprowadziły do powstania RetractorDB. Punkt wyjścia stanowi doświadczenie autora przy budowie systemu nadzoru neonatologicznego na początku XXI wieku - zderzenie z ograniczeniami relacyjnych baz danych przy rejestracji sygnałów o wysokiej granulacji, próby oparte na ówczesnych systemach strumieniowych oraz ewolucja ku dedykowanemu silnikowi przetwarzania serii czasowych. Rozdział wyjaśnia również, skąd pochodzi nazwa „Retractor“ - nawiązanie do grupy narzędzi chirurgicznych rozdzielających i łączących struktury tkankowe, traktowane tu jako analogia do operacji na strumieniach danych.
-
Pliki zapytań RetractorDB (rozszerzenie
.rql) mają dedykowane definicje kolorowania składni dla trzech środowisk:- Visual Studio Code - rozszerzenie
rql-vscodeinstalowane z repozytorium GitHub, - Vim - pliki
syntax/rql.vimiftdetect/rql.vim, instalowane przezscripts/buildrdb.sh vimsyntaxlub ręcznie do~/.vim/, - bat / batcat - definicja w formacie Sublime Text 3, instalowana przez
scripts/buildrdb.sh batsyntax.
Każde ze środowisk rozpoznaje słowa kluczowe RQL (
SELECT,DECLARE,RULE,STREAM, …), typy danych, komentarze, literały łańcuchowe i wartości liczbowe. - Visual Studio Code - rozszerzenie
-
Kompletna dokumentacja flag wiersza poleceń dla wszystkich trzech narzędzi systemu:
Narzędzie Rola xretractorGłówny proces przetwarzania: kompiluje zapytania RQL i realizuje plan xqryKlient: odpytuje działający xretractorprzez wspólną pamięćxtrdbNarzędzie inspekcji: analizuje artefakty binarne i metadane Każde narzędzie opisano w osobnym podrozdziale wraz z przykładami wywołań i objaśnieniem znaczenia poszczególnych przełączników.
-
Katalog wszystkich testów integracyjnych systemu z opisem weryfikowanej funkcjonalności. Testy integracyjne uruchamiają rzeczywiste binaria (
xretractor,xqry,xtrdb) i porównują wyniki z wzorcami - w odróżnieniu od testów jednostkowych GTest, które testują izolowane klasy bibliotek.Scenariusze znajdują się we wspólnym drzewie
test/IntegrationTest. Testy uruchamiające serwer otrzymują jedną z szesnastu przestrzeniRDB_NAMESPACEi blokadę zasobu CTest dla swojego katalogu, dzięki czemu większość z nich może działać równolegle bez kolizji nazw strumieni, IPC ani plików roboczych. Scenariusze badające globalną tożsamość, współpracę wielu serwerów i sprzątanie pozostałości mogą wymagaćRUN_SERIAL.Uruchomienie:
ninja testlubctest -R <nazwa> -Vw katalogubuild/Debug/. -
Kontrakt silnika osadzonego, katalogu magazynu, błędów, kopii NumPy/DLPack i urządzeń.
-
Materiały C2/C3 i decyzje projektowe oddzielone od aktualnego API.
-
Procedura smoke lokalnego modułu i wheel oraz osobnego odbioru w Colab CPU/GPU.
Budowanie produkcyjne i warianty diagnostyczne
Skrypt scripts/buildrdb.sh udostępnia produkcyjne budowanie release oraz tryby diagnostyczne. Warianty release-ablation i probe mają osobne konfiguracje CMake, katalogi wynikowe i generatory Conan. Kontrola gotowej binarki potwierdza użyte przełączniki. Przygotowanie narzędzi i instalację opisuje Instalacja systemu.
⚠️ Ostrzeżenie
Binarki z
release-dirty,release-ablationiprobesą wariantami diagnostycznymi. Nie należy ich instalować ani pakować jako wydania produkcyjne.
Tryby budowania
| Polecenie | Przeznaczenie | Katalog binarny |
|---|---|---|
scripts/buildrdb.sh release | zweryfikowane wydanie produkcyjne | build/Release |
scripts/buildrdb.sh release-dirty | diagnostyka lokalnych zmian, bez kwalifikacji produkcyjnej | build/Release |
scripts/buildrdb.sh release-ablation | wybrana konfiguracja optymalizatora i sondy | build/Release-Ablation/<konfiguracja> |
scripts/buildrdb.sh probe | diagnostyka z włączoną sondą | build/Release-Probe |
Tryby release-ablation i probe korzystają również z osobnych katalogów generatorów Conan:
build/Conan-Release-Ablation/<konfiguracja>,build/Conan-Release-Probe.
Dzięki temu ich cache CMake, definicje kompilatora i binaria nie są zapisywane w produkcyjnym build/Release.
release-dirty dopuszcza niezatwierdzone zmiany i przebudowuje ten sam katalog build/Release, którego używa release. Nadal jawnie ustawia przełączniki optymalizatora i sprawdza --build-info, ale wynik służy do diagnostyki zmian przed commitem. Nie jest izolowanym wariantem ani wydaniem produkcyjnym; przed przygotowaniem wydania należy ponownie wykonać release z czystego drzewa.
Kontrakt produkcyjnego release
Polecenie:
scripts/buildrdb.sh release
działa w trybie fail closed: każda niespełniona kontrola przerywa budowanie. Skrypt:
- wymaga repozytorium Git oraz całkowicie czystego drzewa roboczego;
- odrzuca zmiany śledzone, staged i pliki nieśledzone;
- usuwa poprzedni katalog
build/Release; - usuwa z procesu konfiguracji typowe zmienne pozwalające wstrzyknąć flagi kompilatora, linkera lub CMake;
- jawnie przekazuje pełną konfigurację produkcyjną;
- buduje binarkę w świeżym katalogu;
- odczytuje konfigurację z gotowego
xretractor; - ponownie sprawdza czystość drzewa źródeł.
Zmienne usuwane ze środowiska procesu budowania to między innymi CFLAGS, CPPFLAGS, CXXFLAGS, LDFLAGS, CMAKE_ARGS, CMAKE_GENERATOR oraz CMAKE_TOOLCHAIN_FILE. Zmienne uruchomieniowe sondy RDB_BENCH_CSV i RDB_BENCH_PLAN również nie są przekazywane.
Konfiguracja produkcyjna jest zawsze następująca:
RDB_OPT_DEDUP_SUBSTRATES=ON
RDB_OPT_SHARE_EQUIVALENT_SELECTS=ON
RDB_OPT_COMMUTATIVE_ADD=ON
RDB_OPT_FACTOR_MATCHED_HASH_TIMEMOVES=ON
RDB_BENCH_PROBE=OFF
RDB_OPT_SIMPLIFY_EXPRESSIONS=ON
Po kompilacji skrypt wykonuje:
build/Release/src/retractor/xretractor --build-info
i porównuje wynik z powyższym zestawem. Brak binarki albo choć jedna inna wartość kończy release błędem.
ℹ️ Info
Kontrola czystości Git dowodzi, że budowanie nie korzysta z lokalnych, niezatwierdzonych zmian. Nie dowodzi poprawności zawartości zatwierdzonego commitu. Za tę część odpowiadają przegląd zmian, testy i CI.
Warianty z wyłączanymi optymalizacjami
Polecenie:
scripts/buildrdb.sh release-ablation
otwiera podmenu pozwalające niezależnie przełączać:
RDB_OPT_DEDUP_SUBSTRATES
RDB_OPT_SHARE_EQUIVALENT_SELECTS
RDB_OPT_COMMUTATIVE_ADD
RDB_OPT_FACTOR_MATCHED_HASH_TIMEMOVES
RDB_BENCH_PROBE
RDB_OPT_SIMPLIFY_EXPRESSIONS
Każdy wariant otrzymuje katalog opisujący pełną konfigurację, na przykład:
build/Release-Ablation/dedup-OFF_share-ON_comm-ON_factor-ON_probe-OFF_simplify-ON
Wartości wszystkich sześciu przełączników są przekazywane jawnie. Zapobiega to dziedziczeniu wartości zapisanych przez wcześniejszą konfigurację w CMakeCache.txt.
Konfiguracja:
RDB_OPT_SHARE_EQUIVALENT_SELECTS=OFF
RDB_OPT_COMMUTATIVE_ADD=ON
jest niedozwolona. Kanonizacja przemiennego dodawania jest częścią współdzielenia równoważnych obliczeń SELECT, dlatego podmenu i CMake odrzucają takie połączenie.
Po zbudowaniu wariantu skrypt porównuje --build-info z wartościami wybranymi w podmenu. Niezgodność jest błędem konfiguracji.
Sonda pomiarowa
RDB_BENCH_PROBE jest opcjonalną instrumentacją, a nie optymalizacją planu. Polecenie:
scripts/buildrdb.sh probe
buduje wariant ze wszystkimi optymalizacjami włączonymi oraz:
RDB_BENCH_PROBE=ON
Binarka trafia do build/Release-Probe. Jest zbudowana na zoptymalizowanym kodzie Release, ale nie jest binarką produkcyjną.
W release-ablation sondę można włączyć albo wyłączyć niezależnie od konfiguracji optymalizatora.
Sonda nie uczestniczy w wyborze ani kolejności przebiegów optymalizatora. Nie jest jednak instrumentacją o zerowym koszcie: RDB_BENCH_PLAN dodatkowo przegląda plan i zapisuje statystyki, a RDB_BENCH_CSV wykonuje pomiary zegara i operacje plikowe. Sonda jest więc semantycznie nieinwazyjna, ale jej narzut może wpływać na mierzone czasy.
Jeżeli binarka ma RDB_BENCH_PROBE=ON, a podczas kompilacji ustawiona jest zmienna RDB_BENCH_PLAN, kompilator zapisuje na standardowe wyjście błędów stabilny wiersz:
REWRITE_APPLIED r1=<liczba> r2=<liczba> r3=<liczba>
Liczniki są zerowane przed każdym wywołaniem kompilatora. r1 oznacza liczbę skutecznych przekształceń (A > i) # (B > k) -> (A # B) > (i + k). r2 oznacza liczbę unikalnych węzłów STREAM_ADD, w których kanoniczny odcisk planu rzeczywiście zamienił kolejność dzieci. r3 oznacza liczbę uproszczeń programów pól i warunków RULE: zwinięć stałych, połączeń ogonów stałych i usuniętych elementów neutralnych, a także zastąpień powtórzonego dokładnego czynnika potęgą (E*E*E -> E^3). Ostatnia reguła obejmuje tylko typy BYTE, INTEGER, UINT i RATIONAL; nie przepisuje mnożenia FLOAT ani DOUBLE. Liczniki opisują zastosowane przepisania, a nie przyspieszenie. Przy RDB_BENCH_PROBE=OFF kod liczników nie trafia do binarki i wiersz REWRITE_APPLIED nie jest emitowany.
Ręczna kontrola wariantu
Każdy xretractor udostępnia:
ścieżka/do/xretractor --build-info
Polecenie wypisuje konfigurację i kończy działanie bez uruchamiania silnika (równoważny skrót: -b). Jest obsługiwane przed wczytaniem i walidacją pliku konfiguracyjnego, więc daje poprawny wynik także wtedy, gdy konfiguracja hosta uniemożliwiłaby normalny start programu. Przykładowy wynik wariantu produkcyjnego:
RDB_OPT_DEDUP_SUBSTRATES=ON
RDB_OPT_SHARE_EQUIVALENT_SELECTS=ON
RDB_OPT_COMMUTATIVE_ADD=ON
RDB_OPT_FACTOR_MATCHED_HASH_TIMEMOVES=ON
RDB_BENCH_PROBE=OFF
RDB_OPT_SIMPLIFY_EXPRESSIONS=ON
Nazwa katalogu jest pomocnicza; informacja z binarki jest ostatecznym potwierdzeniem użytych definicji kompilatora.
Testy wariantów
Wyłączenie optymalizacji może celowo zmienić strukturę planu i dostępność testów wymagających konkretnego kształtu. Nie może natomiast zmienić części wartościowej wyniku: interwału, początku logicznego, publicznego deskryptora, rekordów z mapami wartości pustych ani polityki materializacji. Ogon startowy podlega słabszej gwarancji opisanej poniżej.
CTest przypisuje testom wymagającym konkretnej optymalizacji etykiety requires_* i może je wyłączyć dla niezgodnej konfiguracji. Etykieta expected_ablation_failure opisuje wtedy oczekiwaną niedostępność testu kształtu planu, a nie przyzwolenie na różnicę semantyczną.
Procedura oceny błędu powinna być następująca:
- uruchomić ten sam test w konfiguracji produkcyjnej;
- potwierdzić, że przechodzi z wymaganymi optymalizacjami;
- uruchomić go w badanym wariancie;
- wykazać związek błędu z wyłączonym przełącznikiem;
- jeżeli test wymaga wyłączonego przebiegu, wyłączyć go dla tego wariantu;
- każdy inny błąd traktować jako regresję.
Test it_optimizer_ablation-build-info kontroluje zgodność informacji raportowanej przez binarkę z konfiguracją CMake. Pozostałe testy it_optimizer_ablation-* sprawdzają strukturę planów i porównania semantyczne między wariantami.
Wariant z wyłączoną optymalizacją może zmienić strukturę planu, ale nie może zmienić wartości, map NULL, publicznego deskryptora, początku logicznego ani polityki materializacji. Ogon może się skrócić po włączeniu poprawnego przepisania planu, lecz nie może spowodować emisji przed dostępnością danych. Każde inne odchylenie jest regresją, a nie dopuszczalną właściwością wariantu.
Pakowanie
Pakiety produkcyjne należy przygotowywać dopiero po poprawnym, zweryfikowanym release:
scripts/buildrdb.sh release package
Opcja package ponownie ustawia produkcyjne wartości przełączników i przebudowuje wybrany katalog przed uruchomieniem CPack. Nie należy uruchamiać pakowania na katalogach Release-Ablation ani Release-Probe.
Pakiety mają różne przeznaczenie:
| Wariant | Zawartość domyślna i ścieżki |
|---|---|
Linux: package (DEB/TGZ) | Trzy programy pod /usr/bin, jednostka systemd, licencja, domyślny TOML i przykłady konfiguracji. |
Linux: package-portable | Ścieżki względne: bin/, share/doc/retractordb/LICENSE, share/retractordb/retractor.toml; bez jednostki systemd. Usługę może utworzyć instalator webowy. |
Rozwojowy port Apple: package (TGZ) | Prefiks /usr/local, bez komponentu usługowego systemd; brak dostarczonej konfiguracji launchd. |
CPack nie generuje pakietu źródłowego. Test it_packaging sprawdza dokładną zawartość DEB, jeśli dostępne jest dpkg-deb, oraz archiwum portable. Skrypty przygotowania linuxowych zasobów wydania znajdują się w scripts/release_package/; ich wykonanie i publikacja są odrębne od lokalnej instalacji.
Możliwości platformy i sanitizery
Konfiguracja CMake sprawdza dostępne funkcje platformy i zapisuje wyniki RDB_HAS_* w generated/platformConfig.h. Lista RDB_PLATFORM_FALLBACKS określa świadomie dopuszczone ścieżki zastępcze. Na Linuksie domyślnie jest pusta. Jeśli kontrolowana próba wybiera niezadeklarowaną ścieżkę, konfiguracja kończy się błędem; najpierw należy sprawdzić CMakeFiles/CMakeConfigureLog.yaml, zamiast automatycznie dopisywać brakującą funkcję do listy.
Opcja CMake -DRDB_SANITIZE=address,undefined włącza AddressSanitizer i UndefinedBehaviorSanitizer; wykrycie niezdefiniowanego zachowania przerywa wykonanie. Jest to argument konfiguracji CMake, a nie dodatkowa opcja buildrdb.sh. Sanitizery wymagają przebudowania testowanych binariów.
Na rozwojowym porcie Apple gotowym wejściem jest scripts/macos-build.sh --sanitize. Zwykły przebieg testów bez Valgrinda nie włącza sanitizerów automatycznie. scripts/macos-build.sh release wybiera konfigurację Release, ale nie realizuje produkcyjnego kontraktu buildrdb.sh release. Pełny przebieg i ograniczenia opisuje środowisko rozwojowe Apple.
Opcjonalne API klienckie
Katalog api/ jest rozwijany i testowany razem z silnikiem, ale nie należy do domyślnego produktu. Zwykłe cele ninja, ninja install, ninja test oraz ninja package pozostawiają biblioteki i testy API poza wynikiem.
Jawne wejścia są rozdzielone:
| Polecenie | Znaczenie |
|---|---|
ninja install-withapi | Buduje i instaluje silnik oraz komponent api. |
ninja test-api | Buduje testowego klienta C++ i uruchamia testy z etykietą api. |
cmake -DRDB_WITH_API=ON . | Dołącza komponent api do pakietów CPack; zwykły cel test przestaje wtedy odfiltrowywać etykietę api. |
Przełącznik pakowania musi być ustawiony podczas konfiguracji, ponieważ CPack ustala listę komponentów właśnie wtedy. Bez RDB_WITH_API=ON pakiety nie zawierają bibliotek API; pozostała zawartość zależy od wariantu pakietu opisanego wyżej. Test it_packaging chroni domyślny zestaw Linux DEB i portable.
Cele C++ API są zawsze znane CMake, ale mają EXCLUDE_FROM_ALL. Reguły instalacji należą do osobnego komponentu api, więc samo ninja install ich nie wykonuje. Szczegóły użycia bibliotek i kontraktu JSONL zawiera rozdział API monitorowania strumieni.
API monitorowania strumieni
Ten klient obserwuje serwis. Engine i odczyt offline mają osobny kontrakt, a instalacja Python rozróżnia wheel z silnikiem od pakietu samego klienta.
Opcjonalne API klienckie służy do monitorowania strumieni działającej, jawnie nazwanej instancji xretractor na tym samym hoście Linux. Warstwa transportowa uruchamia procesy xqry --jsonl; dzięki temu API nie powiela protokołu Boost IPC i korzysta z tych samych reguł wyboru strumienia oraz kończenia subskrypcji co narzędzie wiersza poleceń.
Dostępne są:
- pakiet Python 3.10+ bez zależności uruchomieniowych poza biblioteką standardową;
- statyczna biblioteka C++23 z publicznym nagłówkiem i konfiguracją CMake;
- wersjonowany kontrakt JSON Lines v1, który można obsłużyć także bez gotowej biblioteki.
API nie uruchamia serwera, nie ładuje planów, nie łączy się ponownie po awarii i nie odtwarza pominiętych próbek. Jest interfejsem obserwacji na żywo, a nie transportem trwałym ani bezstratnym.
Kontrakt JSON Lines v1
xqry --jsonl obsługuje cztery polecenia tylko do odczytu:
xqry --server laboratory --jsonl --hello
xqry --server laboratory --jsonl --dir
xqry --server laboratory --jsonl --detail temperature
xqry --server laboratory --jsonl --select temperature --elimitqry 10
Każdy wiersz stdout jest kompletnym obiektem UTF-8 JSON z version: 1 i event. Komunikaty diagnostyczne trafiają na stderr.
| Zdarzenie | Zawartość |
|---|---|
pong | Odpowiedź na hello. |
streams | Tablica elementów {name, delta}; pusta dla serwera bezczynnego. |
schema | Nazwa strumienia, delta, oryginalne zapytanie i uporządkowane pola. |
record | Nazwa strumienia i spłaszczona tablica wartości. |
end | Normalny koniec: limit albo server_stopped_or_reloaded. |
error | Stabilny kod oraz opis błędu; proces kończy się niezerowo. |
Subskrypcja emituje najpierw schemat, potem rekordy i dokładnie jedno końcowe zdarzenie end albo error. EOF bez zdarzenia końcowego jest błędem procesu, nawet gdy kod wyjścia wynosi zero.
{"version":1,"event":"schema","stream":"temperature","delta":"1/20","query":"...","fields":[{"name":"v","type":"INTEGER","count":2}]}
{"version":1,"event":"record","stream":"temperature","values":["21",null]}
{"version":1,"event":"end","reason":"limit"}
Pole count w schemacie jest licznością skalarną. Tablice liczbowe zachowują wszystkie elementy i osobne wartości NULL; STRING[N] pozostaje jednym napisem. Niepuste wartości na przewodzie są napisami interpretowanymi według typu ze schematu. Dzięki temu liczby wymierne zachowują licznik i mianownik, a napis "null" nie miesza się z JSON null.
| Typ RQL | Python | C++ Value |
|---|---|---|
NULL | None | std::monostate |
BYTE, INTEGER, UINT | int | std::int64_t |
FLOAT, DOUBLE | float | double |
RATIONAL | fractions.Fraction | Rational |
INTPAIR | para liczb | std::pair<int64_t, int64_t> |
IDXPAIR | para napis–liczba | std::pair<std::string, int64_t> |
STRING | str | std::string |
Wiadomości nie niosą znacznika czasu źródła ani trwałego numeru sekwencji. Precyzję liczb zmiennoprzecinkowych ogranicza istniejąca tekstowa serializacja IPC, a całe opakowanie INFO musi mieścić się w limicie 1024 bajtów kolejki serwera.
--idle-timeout N kończy JSONL po N milisekundach bez rekordu; zero wyłącza limit. Jest to niezależne od timeoutu pojedynczego odczytu w bibliotekach.
Python
Pakiet instaluje się ze źródeł:
python3 -m venv .venv-api
.venv-api/bin/python -m pip install ./api/python
Każda subskrypcja posiada własny proces potomny xqry:
from retractordb import Client, ReadTimeout
with Client("laboratory", xqry="/path/to/xqry") as db:
print(db.streams())
print(db.describe("temperature"))
with db.subscribe("temperature", limit=10) as samples:
for record in samples:
print(record["v"])
print(samples.end_reason)
Client(server, xqry="xqry", timeout=5.0) przyjmuje timeout w sekundach. subscribe(stream, limit=0, idle_timeout=0.0, capacity=1024) zwraca obiekt ze schematem znanym już przy zakończeniu wywołania. next(timeout=...) może zgłosić ReadTimeout bez zamykania subskrypcji. Zwykła iteracja czeka bez limitu. Rekord mapuje nazwę pola na skalar albo listę elementów tablicy.
Należy używać menedżerów kontekstu lub jawnego close(). Samo przerwanie pętli for nie zamyka iteratora. Biblioteka nie instaluje obsługi sygnałów aplikacji.
ping() po poprawnej odpowiedzi serwera zwraca True; przy błędzie zgłasza Error z kodem i opisem przyczyny. Nie zwraca False i nie ukrywa błędów transportu ani protokołu. Przykład obsługi błędu:
from retractordb import Client, Error
with Client("laboratory", xqry="/path/to/xqry") as db:
try:
db.ping()
except Error as exc:
print(f"Blad ping: {exc.code}: {exc}")
else:
print("Serwer odpowiada")
Zgodność w Pythonie: wynik True zachowuje działanie dotychczasowego kodu if db.ping(): i assert db.ping(). Przy awarii oba wywołania zgłaszają wyjątek. Kontrakt zatwierdzony w #425 zachowuje wynik sukcesu w Pythonie; C++ używa void.
C++
Biblioteka wymaga C++23. W drzewie RetractorDB jej cele są dostępne na żądanie:
cmake --build build/Debug --target rdb_monitor
build/Debug/api/cpp/rdb_monitor laboratory temperature 10 /path/to/xqry
Projekt może dołączyć źródła bezpośrednio:
add_subdirectory(/path/to/retractordb/api/cpp rdb-api)
target_link_libraries(my_monitor PRIVATE RetractorDB::client)
Po instalacji komponentu API dostępny jest pakiet CMake:
find_package(RetractorDBClient CONFIG REQUIRED)
target_link_libraries(my_monitor PRIVATE RetractorDB::client)
Minimalna subskrypcja:
#include <iostream>
#include "retractordb/client.hpp"
int main() {
retractordb::Client db("laboratory");
auto samples = db.subscribe("temperature", {.limit = 10});
while (auto record = samples.next())
std::cout << record->values.at("v").size() << '\n';
}
SubscribeOptions udostępnia limit, idleTimeout i capacity. next(timeout) zwraca std::optional<Record>; brak wartości oznacza normalny koniec lub jawne zamknięcie. Błędy rzucają retractordb::Error ze stabilnym polem code. Uchwyty subskrypcji są przenoszalne, ale niekopiowalne; destruktor i close() kończą oraz zbierają własny proces potomny.
Client wymaga jawnej nazwy serwera o długości 1..32 znaków: pierwsza jest małą literą ASCII, pozostałe to małe litery ASCII, cyfry, _ lub -. Options::timeout musi być dodatni. Ujemny limit, ujemny idleTimeout albo zerowe capacity subskrypcji są niedozwolone; błędne argumenty zgłaszają std::invalid_argument.
next(timeout) zgłasza Error z kodem read_timeout bez zamykania subskrypcji; można ponowić odczyt z tego samego procesu. Inne błędy transportu lub protokołu zamykają subskrypcję. Po zdarzeniu end klient czeka jeszcze na poprawne zakończenie xqry w budżecie Options::timeout: niezerowy kod wyjścia daje process_exit, a brak zakończenia w terminie process_timeout.
Client również jest przenoszalny i niekopiowalny. Konstruktor i przypisanie przenoszące mają noexcept i są zdefiniowane = default poza nagłówkiem. Przenoszenie przekazuje własność klienta i jego subskrypcji; przypisanie przenoszące najpierw zamyka dotychczasowe subskrypcje obiektu docelowego. Destruktor klienta zamyka należące do niego subskrypcje także wtedy, gdy ich uchwyty nadal istnieją. Akcesory Client::streams(), describe() i subscribe() oraz Subscription::schema(), next(), pid() i endReason() mają [[nodiscard]].
Client::ping() zwraca void po poprawnej odpowiedzi, a przy błędzie rzuca retractordb::Error z zachowanym kodem i opisem przyczyny. Sukces sprawdza się przez zakończenie wywołania bez wyjątku; nie ma wyniku false.
Obiekt po przeniesieniu: obiekt źródłowy Client można bezpiecznie zniszczyć, zamknąć przez close() albo przypisać mu innego klienta. Wywołania ping(), streams(), describe() i subscribe() zgłaszają retractordb::Error z kodem closed. Przypisanie działającego klienta pozwala ponownie używać obiektu. Po zwykłym close() te metody również zgłaszają closed, jeśli przekazane argumenty są poprawne.
Przeniesienie Subscription przekazuje jej proces, schemat i przyczynę końca; przypisanie przenoszące najpierw zamyka poprzedni proces obiektu docelowego. Po oddaniu własności obiekt źródłowy obsługuje next() (zwraca pusty wynik), close(), ponowne przypisanie i destrukcję. schema(), pid() i endReason() wymagają uchwytu, który nie oddał własności. Zwykłe close() zachowuje dostęp do schematu, pierwotnego PID i zapisanej przyczyny końca; next() zwraca wtedy pusty wynik.
Ograniczenia i obsługa błędów
Bufory bibliotek są ograniczone: domyślnie 1024 oczekujące zdarzenia, 1 MiB na wiersz JSONL i 64 KiB zachowanego stderr. Przepełnienie bufora aplikacji daje buffer_overflow i zamyka subskrypcję bez cichego pomijania rekordów. Przepełnienie kolejki po stronie serwera jest ograniczeniem istniejącego IPC i może ujawnić się dopiero jako timeout bezczynności.
Zamknięcie jest idempotentne: biblioteka wysyła SIGTERM do własnego xqry, czeka do sekundy, a w razie potrzeby używa SIGKILL i zbiera proces. Zamknięcie klienta zamyka wszystkie jego subskrypcje; nigdy nie wysyła xqry --kill do serwera.
Kody błędów obejmują między innymi read_timeout, idle_timeout, buffer_overflow, stream_not_found, no_active_plan, server_stopping, server_no_response, client_queue_missing, disconnected, communication_error, protocol_error, spawn_error, process_exit, process_timeout i closed.
Budowanie i testowanie
API jest rozwijane razem z silnikiem, ale pozostaje opcjonalne. Zwykłe ninja, ninja install, ninja test i ninja package nie budują, nie instalują ani nie pakują API.
| Polecenie | Efekt |
|---|---|
ninja install-withapi | Buduje i instaluje silnik oraz komponent api. |
ninja test-api | Buduje klienta testowego i uruchamia ctest -L api. |
cmake -DRDB_WITH_API=ON . | Dołącza komponent api do pakietów CPack i testy API do zwykłego celu test. |
API C++ jest konfigurowane zawsze, ale jego cele mają EXCLUDE_FROM_ALL. xqry ma własną jednostkę kompilacji Boost.JSON, dlatego silnik nie linkuje niczego z katalogu api/. Zależność biegnie wyłącznie od API do publicznego interfejsu procesu xqry.
Testy st_api_fake i st_api_real sprawdzają oba języki. Pierwszy obejmuje typy, NULL, błędne wyjście, przepełnienie i zamykanie procesu. Drugi używa prawdziwego xretractor i sprawdza niezależne subskrypcje, tablice, liczby wymierne, brakujący strumień oraz zatrzymanie serwera.
Testy C++ obejmują też fabrykę klienta, std::vector, przechwycenie w lambdzie, przypisanie przenoszące z aktywnymi subskrypcjami oraz bezpieczne close() i niszczenie obiektu po przeniesieniu. Sprawdzają kod closed ze wszystkich czterech metod klienta po konstrukcji i przypisaniu przenoszącym oraz po jawnym zamknięciu. Oba języki sprawdzają sukces i błędy ping() oraz zachowanie kodów protocol_error, server_no_response i closed; testy Pythona wymagają wyniku True po sukcesie.
st_api_fake sprawdza również niepełny lub zbyt długi wiersz JSONL, błędne zakończenie po zdarzeniu end, przekroczenie czasu zakończenia procesu i ponawianie odczytu po read_timeout. Oba scenariusze sprawdzają odmowę błędnych argumentów C++ oraz przenoszenie subskrypcji, zebranie zastąpionego procesu i zachowanie schematu oraz PID po close().
API Python i Jupyter
Ten rozdział opisuje API osadzonego silnika na master po scaleniu epiku #445 w PR #510 i portu Result z #511 w PR #512, wraz z kontraktem katalogu z #450. Instalację wheel i Jupyter, budowanie biblioteki oraz odbiór notebooków opisują osobne strony. Historia C2/C3 nie zastępuje tego kontraktu. Istniejący wheel może pochodzić ze starszej rewizji; jego wersja pakietu sama nie potwierdza zawartości tych zmian.
Role i zakres
| Interfejs | Zastosowanie | Potrzebuje działającego serwera |
|---|---|---|
retractordb.Engine | Kompiluje RQL i liczy plan wewnątrz procesu Pythona | Nie |
retractordb.Storage, load_descriptor | Czyta istniejące magazyny offline | Nie; aktywny serwer może wykluczać dostęp |
retractordb.client.Client | Obserwuje strumienie działającej instancji przez xqry | Tak |
Engine liczy na osi czasu logicznej, bez zegara czasu rzeczywistego, wątku IPC ani terminala. Nie dołącza do magistrali, nie rezerwuje przestrzeni nazw i nie publikuje swoich strumieni dla xqry. Czas rzeczywisty zapewnia xretractor; strumienie jego serwisu czyta API monitorowania. Biblioteka osadzona nie deklaruje gwarancji czasu rzeczywistego.
Pakiet importuje _core dopiero przy żądaniu API osadzonego. Czysty klient może działać bez rozszerzenia. NumPy jest zależnością biblioteki osadzonej; PyTorch importuje wyłącznie jawnie zaimportowany retractordb.torch. Instalacja klienta pip install ./api/python zastępuje dystrybucję wheel o tej samej nazwie, włącznie z _core; używaj osobnych środowisk.
Kompletny przykład
Przykład tworzy wejście poza katalogiem należącym do silnika, wykonuje plan, sprawdza wartości oraz współdzielenie tablicy przez DLPack. Część PyTorch jest opcjonalna.
from pathlib import Path
from tempfile import TemporaryDirectory
import numpy as np
import retractordb as rdb
with TemporaryDirectory() as directory:
source = Path(directory) / "input.txt"
source.write_text("\n".join(str(value) for value in range(10, 81, 10)) + "\n")
with rdb.Engine() as engine:
engine.compile(f"""
DECLARE a INTEGER STREAM src, 1/2 TEXTFILE '{source}'
SELECT a*2 STREAM dst FROM src
""")
assert engine.run() == 8
assert engine.slots_done == 8 and engine.time == 4
assert [row[0] for row in engine.rows("dst")] == list(range(20, 161, 20))
descriptor = engine.schema("dst")
field = descriptor[0].name
block = engine.to_numpy("dst", fields=[field], dtype="float64")
np.testing.assert_array_equal(block[:, 0], np.arange(20, 161, 20))
window = engine.window("dst", fields=[field], size=4, stride=2)
assert window.shape == (3, 4, 1)
try:
import torch
except ImportError:
torch = None
if torch is not None:
tensor = torch.from_dlpack(window)
assert tensor.data_ptr() == window.to_numpy().__array_interface__["data"][0]
np.testing.assert_array_equal(block[:, 0], np.arange(20, 161, 20))
assert window.shape == (3, 4, 1)
Osiem rekordów daje osiem slotów i czas logiczny 4 przy interwale 1/2. Record, tablica i okno są kopiami wyników; pozostają czytelne po close() silnika.
Engine: cykl życia i wykonanie
| Element API | Kontrakt |
|---|---|
Engine(storage_dir="", lock_dir="", config="") | Własna instancja i Memory Store; domyślnie prywatny katalog tymczasowy |
compile(rql, until_eof=True) | Zamyka poprzedni plan, parsuje, kompiluje i tworzy nowy model |
step() | Zwraca indeks wykonanego slotu od 0 albo None po końcu wejścia |
run(slots=None) | Zwraca liczbę slotów wykonanych w tym wywołaniu; bez budżetu liczy do EOF |
has_plan, failed, end_of_input | Stan planu, zatrzaśnięta awaria slotu oraz koniec wejścia |
slots_done, time | Łączna liczba wykonanych slotów i dokładny czas logiczny Fraction |
storage_dir | Efektywny katalog planu; bez planu katalog domyślny |
streams(), schema(stream), is_declared(stream) | Nazwy strumieni, deskryptor i informacja o deklarowanym źródle |
record_count(stream), retained_from(stream) | Łączny licznik rekordów oraz pierwszy nadal dostępny indeks |
record(stream, index) | Kopia jednego rekordu; ujemny indeks liczy od końca |
rows(stream, first=None, count=None) | Iterator kopii rekordów; domyślnie od najstarszego zachowanego |
close(), with Engine() as engine | Zamyka plan i zwalnia jego zasoby; zwykłe zamknięcie jest idempotentne |
Domyślne until_eof=True zatrzymuje plan po slocie, w którym pierwsze deklarowane źródło się wyczerpało. until_eof=False pozwala źródłom zawijać się po EOF. Plan bez kończącego się wejścia wymaga budżetu, np. run(slots=8), albo przerwania. Nie utożsamiaj slotu z liczbą rekordów każdego strumienia: plan może mieć różne interwały i opóźnione początki.
Nieudana rekompilacja również zamyka poprzedni plan; odmowa nie przywraca go. Po K2/K3 można poprawić żądanie i kompilować ponownie. Awaria podczas slotu ustawia failed; kolejne step() powtarza klasę awarii do rekompilacji. Dotychczasowe wyniki mogą pozostać czytelne po K4. K1 dodatkowo skazuje moduł do restartu interpretera.
compile, step, run i odczyty rekordów zwalniają GIL. run() sprawdza sygnały Pythona co około 50 ms pomiędzy slotami i umożliwia KeyboardInterrupt; to nie jest gwarantowany maksymalny czas przerwania długiego slotu. Diagnostyka silnika trafia do logging.getLogger("retractordb").
Wyjątek z własnego handlera logging jest zgłaszany przez sys.unraisablehook; nie zastępuje pierwotnego błędu kompilacji i sam nie skazuje modułu do restartu. Test test_logging_handler_failure_preserves_the_plan_error_and_next_compile sprawdza, że po takim zdarzeniu można poprawić plan i uruchomić go ponownie.
Katalog magazynu i dostęp offline
Engine() tworzy prywatny katalog, który pozostaje po close() i znika przy zniszczeniu instancji. Jawny storage_dir oraz nadpisująca go dyrektywa RQL STORAGE muszą wskazywać katalog pusty przy pierwszym użyciu albo należący do silnika przez poprawny znacznik .retractordb-embedded. Obcy katalog jest odrzucany. Znacznik nie jest dowodem, że proces właściciela nadal działa.
Jeśli zapis nowo tworzonego znacznika zawiedzie, StorageGuard próbuje usunąć niekompletny znacznik i zwraca IOError z przyczyną. Nie traktuje częściowo zapisanego znacznika jako udanej inicjalizacji katalogu.
Blokada katalogu trwa do zamknięcia magazynów planu. Wyklucza drugi Engine oraz Storage w oznaczonym katalogu, także przez alias ścieżki i z innego procesu. Śmierć procesu zwalnia blokadę. Jawny katalog pozostaje na dysku; rekompilacja może zastąpić jego deskryptory i wyniki. Odmowa preflight zachowuje poprzednie artefakty, lecz zamyka plan; późniejsze błędy I/O nie są transakcyjne.
Wejścia muszą leżeć poza katalogiem wyników; wyjścia pozostają wewnątrz niego. Brak deklarowanego pliku źródłowego jest odrzucany podczas compile() jako IOError z errno=ENOENT lub ENOTDIR, nazwą strumienia i ścieżką w komunikacie; brak prawa odczytu daje IOError z errno=EACCES. Oba przypadki są błędem środowiska K4 również przy wykonaniu przez xretractor: proces kończy się kodem EIO (5 na Linuksie), z --until-eof i bez niego. Usunięcie źródła po kompilacji to osobny przypadek. Jawne DISPOSABLE nadal upoważnia do usunięcia źródła po użyciu.
Otwieranie Storage może odbudować indeks .meta; jest to dostęp offline. Dla katalogu używanego przez serwis podaj jego lock_dir albo config wskazujący TOML z paths.lock_dir; argument ma pierwszeństwo. Konfiguracja jest czytana wyłącznie po jawnym wskazaniu pliku. Bez obu parametrów kontrola zgaduje katalog z TMPDIR i zgłasza UserWarning oraz wpis INFO w loggerze retractordb.
[embedded] lenient_lock_dirs określa katalogi, w których tylko trzymana blokada odmawia dostępu. Bez klucza domyślnym katalogiem łagodnym jest systemowy katalog tymczasowy. Klucz zastępuje tę listę; inne katalogi są sprawdzane ściśle. Kontrola przy otwieraniu nie wyklucza późniejszego startu demona ani serwisu używającego innego katalogu blokad. Prywatny katalog Engine() pomija kontrolę blokad serwisu.
Storage, Descriptor i Record
| Element API | Kontrakt |
|---|---|
load_descriptor(path) | Odczytuje .desc; brak pliku to NoSuchStream, uszkodzony deskryptor to CorruptDescriptor |
Descriptor | Sekwencja Field; size_bytes pomija pola konfiguracyjne, flat_element_count liczy elementy danych |
Field | Właściwości name, length, array_count, type (FieldType) |
| Metody deskryptora | has_field, field_index, byte_offset, field_type_name, storage_policy |
Storage(qry_id, file_name, storage_param="", storage_type="DEFAULT", lock_dir="", config="") | Otwiera istniejący magazyn offline, bez kompilowania planu |
Storage.descriptor, record_count, is_declared, closed | Schemat, licznik, rodzaj źródła i stan uchwytu |
Storage.read(i), storage[i], len(storage) | Kopia rekordu lub liczba rekordów; ujemny indeks od końca |
Storage.close() i context manager | Zamyka magazyn, indeks i blokadę katalogu; odczyt po zamknięciu jest odrzucany |
Record.index, descriptor, record[i] | Indeks, schemat i spłaszczone elementy własnej kopii payload |
Wartości wychodzą jako int, float, str, Fraction dla RATIONAL, krotka dla par i None dla NULL. STRING[N] stanowi jeden element wartości, a tablica numeryczna N elementów. Pola konfiguracyjne deskryptora nie zajmują pozycji w rekordzie. Bezpośredni Storage nie odczytuje źródeł BINFILE, TEXTFILE ani DEVICE; wyniki źródła należącego do planu można czytać przez Engine w granicach jego historii.
Retencja może wygasić indeksy. record_count jest licznikiem logicznym, nie liczbą wszystkich nadal dostępnych rekordów; użyj retained_from. Domyślne rows() i to_numpy() czytają zachowany ogon. Wygasły indeks jest odrzucany zamiast wskazywać inną pozycję pierścienia.
Błędy i granica fatalna
RetractorDBError
+-- ConfigError (także ValueError)
| +-- PlanError
| +-- RQLSyntaxError
| +-- CompileError
| +-- CorruptDescriptor
+-- IOError (także OSError)
+-- InternalError
+-- NoSuchStream
+-- StorageError
| Klasa | Wynik w Pythonie | Stan po błędzie |
|---|---|---|
K1 zwrócone jako Result lub nieoczekiwany wyjątek C++ wychodzący z rdzenia | InternalError | Moduł skazany; chronione wejścia odmawiają do restartu interpretera; close() pozostaje dostępne |
| K2, odmowa planu | PlanError: składnia, kompilacja, uszkodzony deskryptor | Można poprawić dane i spróbować ponownie; nieudany compile() nie pozostawia starego planu |
| K3, odmowa żądania | ConfigError, również ValueError | Instancja pozostaje używalna |
| K4, błąd środowiska | IOError, również OSError | Awaria slotu zatrzymuje plan do rekompilacji; odmowa kompilacji nie tworzy planu |
| K5, niepoprawna wartość danych | None lub NaN | Plan pracuje dalej; ostrzeżenie silnika jest kompilowane poza Release |
| K6, przestarzała składnia | DeprecationWarning z compile() | Plan pozostaje używalny |
| K7, abort lub błąd poza obsługiwaną granicą | Zakończenie procesu | Kernel trzeba uruchomić ponownie |
IOError.errno zachowuje kod systemowy albo używa EIO bez kodu; filename jest ustawiane, gdy wywołanie przyjmowało ścieżkę jako argument. W innych przypadkach ścieżka może być w komunikacie. Błędy nazwy pola/strumienia, indeksu, konwersji tablic i sygnatury mogą dawać standardowe KeyError, IndexError, ValueError lub TypeError; nie każdy wyjątek dziedziczy po RetractorDBError.
Rdzeń zwraca obsługiwalne błędy jako rdb::Result<T>; binding przekłada kategorię Error na powyższe klasy wyjątków Pythona. Błąd I/O przy odczycie deskryptora daje IOError z pierwotnym errno, a nie CorruptDescriptor; ta druga klasa dotyczy błędnej treści. Nieoczekiwany wyjątek C++ z wywołania rdzenia, np. bad_alloc lub length_error, daje InternalError i skaża moduł. Nie przechwytuj InternalError z zamiarem dalszego liczenia w tym samym kernelu.
rdb::fatal() i RDB_ASSERT wywołują osobny, niewracający handler procesu. Domyślnie kończy on hosta przez abort (SIGABRT), także kernel Jupyter; binding nie zamienia tej ścieżki na wyjątek Pythona. xretractor instaluje własny handler kończący proces z kodem 1 i sprzątaniem IPC. Handler jest polityką całego procesu, a nie pojedynczego Engine. RDB_NOEXCEPT_CHECK=OFF nie zmienia tego zachowania. Błędy w funkcji noexcept albo podczas destrukcji również nie mają ogólnej gwarancji przeżycia interpretera.
Niepoprawne wejście nie powinno trafiać do ścieżki fatal: kompilator odrzuca m.in. rozplot & lub % z argumentem równym interwałowi źródła jako CompileError. Można poprawić plan i ponownie użyć Engine. Granicę Result, wyjątku C++ oraz SIGABRT sprawdzają testy podprocesów w test_error_classes.py i test_fatal_paths.py; odmowę rozplotu sprawdzają również regresje ut_compiler.
Własność pamięci, NumPy i DLPack
| Operacja | Kształt i własność |
|---|---|
to_numpy(stream, fields=None, dtype="float64", first=None, count=None) | (rekordy, wartości); nowa tablica, kopia wyników silnika |
window(stream, fields=..., size=..., stride=1, dtype="float32") | (liczba_okien, size, wartości); ciągła tablica należąca do Window |
Window.to_numpy(), np.asarray(window) | Udostępnia tablicę okna bez kolejnej kopii przy zgodnym dtype |
torch.from_dlpack(window) | Współdzieli tę tablicę CPU; nie pamięć silnika |
Kolejność fields określa oś wartości; tablice numeryczne są spłaszczane. STRING, INTPAIR i IDXPAIR nie mają gęstej reprezentacji numerycznej. Typy eksportu to float32, float64, int32, int64. NULL staje się NaN dla float; dla int NULL, nieskończoność i wynik poza zakresem powodują ValueError. Skończone wartości ułamkowe są obcinane w kierunku zera. Projekcja przechodzi przez double, dlatego pełnej dokładności dużych liczb całkowitych szukaj w Record, nie w gęstej tablicy.
size i stride muszą być dodatnie. Dla mniej niż size rekordów powstaje (0, size, wartości). Dla N zachowanych rekordów liczba okien wynosi 1 + (N-size)//stride, gdy N >= size. Okno korzysta z sliding_window_view, po czym kopiuje wybrane okna do ciągłej tablicy. Tablice i tensory pozostają ważne po następnych slotach, zamknięciu i zniszczeniu silnika. Zmiana tablicy okna jest widoczna we współdzielącym tensorze, ale nie modyfikuje wyników silnika.
Urządzenia, PyTorch i wątki
retractordb.torch.as_tensor(window, device="cpu") współdzieli pamięć CPU; jawny inny device wykonuje transfer i kopię. StreamDataset(engine, stream, fields=..., window=..., stride=1, dtype=torch.float32, device="cpu") daje elementy (size, wartości). Każda iteracja odczytuje bieżące wyniki, więc nowe sloty mogą dodać okna do kolejnej epoki.
Używaj DataLoader(..., num_workers=0). Worker jest odrzucany przed dostępem do silnika; fork oraz tworzenie Engine w initializerze workera nie należą do kontraktu tego datasetu. Serializuj wszystkie wywołania jednej instancji, również odczyty, właściwości, compile() i close() podczas run(). GIL nie chroni stanu silnika; równoczesna kompilacja lub wykonanie osobnych instancji nie ma ogólnej gwarancji bezpieczeństwa wątkowego.
CPU/DLPack nie przypina buforów silnika i nie zapewnia przypiętej pamięci hosta dla CUDA. Transfer na CUDA jest osobną operacją. MPS odrzuca float64 przed transferem; wybierz float32. Test CPU tej odmowy nie jest odbiorem sprzętowym MPS. Demonstracja Colab T4 z #448 używa CUDA, fp16 i GradScaler; nie stanowi dowodu dla wszystkich urządzeń. DeviceWindowLoader, odbiór MPS i publikacja PyPI pozostają opcjonalnymi dalszymi zadaniami poza epikiem.
Ograniczenia planu osadzonego
compile() odrzuca DUMP, SYSTEM, :ROTATION oraz źródła DEVICE jako CompileError: wymagają stanu lub fazy wykonania serwisu, których Engine nie ma. Brak pliku wejścia daje opisany wyżej IOError. Push ingest z Pythona i cele mobilne nie są dostępne. Pełny serwis oraz jego konfiguracja pozostają domeną xretractor.
Źródła i testy kontraktu
| Obszar | Źródła w repozytorium silnika | Testy w api/python/tests |
|---|---|---|
| Plan, EOF, rekompilacja i katalog | src/embed/engine.cc, storageGuard.cc, src/python/module.cpp | test_engine.py, C++ ut_embedEngine |
| Deskryptory i odczyt offline | src/python/module.cpp, src/rdb/lib/descriptor.cc | test_descriptor.py, test_storage.py |
| K1-K7 i powtórne użycie | src/include/rdb/error.hpp, src/rdb/lib/error.cc, src/include/fatalError.hpp, src/python/module.cpp | test_error_classes.py, test_fatal_paths.py, test_reentry.py |
| Kopie, okna i urządzenia | retractordb/engine.py, retractordb/torch.py, src/python/module.cpp | test_window.py |
| Izolacja i zgodność logiczna | src/embed/engine.cc, src/retractor/lib/dataModel.cpp | test_isolation.py, test_reference.py |
Ścieżki retractordb/*.py są względem api/python/. Nazwy testów określają pokrycie, nie deklarują wykonania na wszystkich platformach. test_reference.py porównuje wspólny zakres z xretractor -u, włącznie ze schematem, NULL, metadanymi i logicznym harmonogramem; nie mierzy czasu rzeczywistego. Odmowę brakującego źródła sprawdzają osobno test_engine.py, ut_embedEngine i it_untileof_stop-missing-sources (#488). Funkcje tylko serwisowe pozostają poza tym porównaniem. Warunki i wyniki konkretnego odbioru należy zapisać osobno.
Historia integracji osadzonej
Materiał historyczny etapów C2/C3 epiku #446 oraz początków wiązania Python. Zastępuje notatki core-phase-2.md, core-phase-3.md i historyczne części jupyter-integration.md z dawnego katalogu docs repozytorium kodu. Bieżący kontrakt opisuje API Python, a polecenia budowanie biblioteki. #450 później wprowadziło własność katalogu magazynu, a #476/#451 dopełniły politykę błędów i odbiór. Real-time w bibliotece, cele mobilne, ingest, DeviceWindowLoader i sprzętowy odbiór MPS pozostają poza zakończonym zakresem epiku.
Po scaleniu epiku #445 port #511 zastąpił historyczną granicę rzucania błędów przez Result i handler rdb::fatal(). Wydawane programy mają jednolity tryb wyjątków, a RDB_NOEXCEPT_CHECK sprawdza osobno rdzeń. Poniższe opisy C2/C3 zachowują stan tamtych etapów; aktualną granicę odzyskiwania opisuje API Python.
C2: właściciel stanu instancji
Demon konstruował stan raz, więc stan procesu i stan silnika były trudne do odróżnienia. Notebook tworzy i niszczy silnik przy powtórnych wykonaniach komórek. C2 rozdzieliło własność, aby nazwy strumieni w różnych instancjach nie powodowały wspólnych wyników.
| Stan przed C2 | Zmiana albo pozostawiony zakres |
|---|---|
Statyczna mapa rekordów MEMORY w faccmemory.cc | rdb::MemoryStore należy do właściciela; osobne instancje są izolowane |
Statyczna flaga Descriptor::singleLineOutput_ | Formatowanie należy do konkretnego std::ostream, przez slot ios_base::xalloc |
fatalErrorRaised | Pozostał elementem ścieżki zakończenia xretractor; granica rzucania oddziela embedding |
| Domyślny logger spdlog | Konfigurację wykonują launchery lub host modułu, nie instancja silnika |
| Liczniki probe | Znany dług procesu; pomiary nie są wykonywane przez build Python |
pProc, core_mutex, esm::* | Stan serwisu nie został przeniesiony do embedding; pełna przebudowa serwisu pozostała osobna |
Memory Store zachował układ bucketów: dane, mapy NULL, licznik zapisów, rozmiar rekordu i liczbę żywych użytkowników. Writer i reader jednego strumienia nadal współdzielą bucket wewnątrz jednego Store. Konstruktor memoryFile przyjmuje MemoryStore&, a makeAccessor i storage opcjonalny wskaźnik. Brak argumentu wybiera MemoryStore::processDefault(), zachowując zachowanie istniejącego serwisu i xtrdb. Ostatni użytkownik usuwa bucket; instancja o innym rozmiarze rekordu czyści niezgodne dane. Zmienił się właściciel, a nie format danych.
ut_faccmemory sprawdza niezależne Store z tą samą nazwą, współdzielenie w jednym Store, domyślny Store procesu i przekazanie przez storage. Sama sekwencja tworzenia i niszczenia Storage nie dowodziła jeszcze izolacji całego planu.
Flaga formatowania deskryptora wcześniej była procesowa i resetowana przez samo wypisanie. Po C2 rdb::singleLineFormat zmienia stan strumienia przez isSingleLineOutput / setSingleLineOutput; pozostaje jednorazowy, lecz nie wpływa na inny strumień. Binding mógł usunąć obejście save/restore.
Gate test/embedding_boundary.py utrwala granicę: niedozwolony stan procesu, konfiguracja loggera i ścieżki kończące proces nie mogą wracać do warstwy osadzonej poza jawnie kontrolowaną granicą. Gate jest testem struktury źródeł, nie ogólnym dowodem współbieżności.
Pierwsza fasada rdb::embed::Engine posiadała Memory Store i pozwalała otwierać magazyn przez openStorage(). Nie wykonywała jeszcze planu. Probe i stan executora pozostały długiem, a dowód izolacji strumieni VOLATILE powstał dopiero w C3, gdy Store został przekazany do modelu i streamInstance.
C3: plan sterowany przez hosta
retractorcore zawiera parser i kompilator RQL, wyrażenia, query/qTree, dataModel, streamInstance, reguły, dumpManager i oś czasu. Oddzielono go od warstwy serwisowej retractor: executor z zegarem, terminalem, IPC, magistralą i konfigurowaniem procesu. rdbembed łączy fasadę z retractorcore; _core nie linkuje bibliotek serwisu. Reguły DUMP pozostały w rdzeniu, ale fasada odmawia ich użycia, ponieważ nie publikuje globalnego modelu pProc.
Prywatny Plan posiada qTree, kompilator, model, TimeLine i liczniki w kolejności zależności. Destrukcja odbywa się w kolejności odwrotnej. compile() wykonuje parsowanie, kompilację, kontrole magazynu, przygotowanie artefaktów, modelu i osi czasu. step() wykonuje ZERO-step przy pierwszym slocie, wybiera następną chwilę z osi czasu, buduje maskę należnych strumieni i wywołuje dataModel::processRows bez zegara, IPC i terminala.
untilEof oznacza źródła jako ONESHOT przed utworzeniem modelu, jak xretractor -u. Slot wykrywający EOF pozostawia poprawnie policzone rekordy; następne wywołanie sygnalizuje koniec. Domyślny brak zawijania został wybrany dla notebooka traktującego plik jako dataset.
Model i streamInstance otrzymały opcjonalny MemoryStore*. Fasada przekazuje Store swojej instancji; serwis bez argumentu używa domyślnego Store. ut_embedEngine i test Python dwóch silników z taką samą nazwą VOLATILE utrwalają tę izolację.
dumpManager::processStreamChunk najpierw sprawdza księgę zadań. Bez zadań nie potrzebuje pProc; z zadaniem jego brak pozostaje błędem wewnętrznym. Fasada odrzuca DUMP, SYSTEM, ROTATION i DEVICE podczas kompilacji: odpowiednio wymagają modelu serwisu, wykonywałyby shell hosta, wymagają licznika rotacji lub fazy odbioru DEVICE, której step() nie ma. Callback hosta zezwalający na SYSTEM nie został dodany.
Wczesne C3 zastępowało deskryptory deklaracji przy rekompilacji notebooka. Kontrakt tej operacji został później ograniczony w #450 do własnego, zablokowanego katalogu, po preflight. Nie należy traktować starej notatki jako zgody na nadpisywanie obcych katalogów. #451 dodało jawną odmowę brakującego źródła w embedding; ówczesny serwis dawał w tym przypadku NULL. Zmiana #488 ujednolica obsługę: brak źródła jest błędem środowiska K4 także w xretractor, z --until-eof i bez niego. Obecny kontrakt opisują API Python i opcje xretractor.
Odmowy fasady Refused rozróżniały etapy Parse, Check i Request. Granica ThrowOnFatalScope zamieniała K1/K4 na EngineFatal zamiast kończyć hosta. Awaria slotu zatrzaskiwała stan planu. Późniejsze #476 i #491 ustaliły klasę PlanError, wielodziedziczenie ConfigError/IOError, errno oraz skazę całego modułu po K1. Historyczne stwierdzenie „pełna polityka błędów pozostaje do wykonania” dotyczyło momentu C3, nie aktualnego stanu.
record() zwraca kopię, a project() spłaszczone wartości double z NaN dla NULL. Deklaracje czytają historię modelu, a wyniki SELECT jego magazyn. Python dodaje rows, to_numpy, window i Window; okno posiada własną tablicę NumPy i eksportuje jej DLPack. Dane nie przypinają pamięci silnika, więc tensor może przetrwać następny slot.
GIL jest zwalniany podczas pracy rdzenia. Pętla run() odzyskuje go okresowo dla sygnałów Pythona. Moduł przekierowuje diagnostykę do loggera retractordb; statyczne, ukryte linkowanie spdlog ogranicza tę konfigurację do rozszerzenia. C3 nie zapewniło pełnej przebudowy executorsm::run, fazy DEVICE, callbacka SYSTEM ani ogólnej gwarancji współbieżności; globalny core_mutex nadal ogranicza równoległe wykonanie.
Początkowy binding i decyzje dystrybucyjne
Etap 1a objął tylko magazyn, ponieważ parser, wykonanie i procesowy stan wymagały C2/C3. Utrwalił mapowanie FieldType, Field, Descriptor, Storage i Record, odczyty offline oraz wyjątki. Wybór nanobind zamiast pybind11 został potwierdzony tą próbą. Historyczny pomiar na macOS arm64, Apple clang, Debug, nanobind 3.1.0 i Python 3.14 obejmował kompilację module.cpp 1.6 s cold / 0.9 s incremental i moduł 8.8 MB bez strippingu. Są to dane tamtego bindingu, nie porównawczy wynik wydajności silnika ani aktualny rozmiar wheel.
| Etap roadmapy | Zakres i dalsze rozstrzygnięcie |
|---|---|
| J1 | compile, step, iteracja wyników i błędy planu po C2/C3 |
| J2 | NumPy, Window, DLPack i IterableDataset; kopie zamiast bufora silnika |
| J3 | KeyboardInterrupt w run i most do logging |
| J4 | Pakowanie scikit-build-core/cibuildwheel i Linux manylinux; publikacja PyPI pozostaje osobna |
| J5 | Notebook Colab i smoke zainstalowanego wheel; odbiór runtime zapisuje się osobno |
| J6 | Push ingest z Pythona; poza wykonanym zakresem |
Decyzje: nie dodawać twardej zależności torch, aby nie zastępować cudzej instalacji CUDA; w Colab instalować wheel zamiast kompilować sdist; eksportować kopię wyników zamiast przypinać pamięć silnika. Referencyjne około 20 s dla instalacji było celem roadmapy, nie kryterium zamknięcia zadania. Mobilne XCFramework/AAR, embedding real-time, DeviceWindowLoader i odbiór sprzętowy MPS pozostają odrębnymi zadaniami.
Odbiór notebooków i Colab
Notebooki i ich smoke test
Trzy notebooki korzystają z aktualnej składni RQL i hierarchii wyjątków (błędy). Wszystkie zapisane w repozytorium komórki mają puste wyjścia.
Notebook w api/python/notebooks/ | Przebieg |
|---|---|
j0_storage.ipynb | deskryptor, kopia magazynu, wartości NULL, indeks ujemny i CorruptDescriptor z kernelem używalnym po błędzie |
j1_engine.ipynb | TEXTFILE, compile/step/run, rekordy, okna NumPy/DLPack, odmowy planu i rekompilacja |
colab_quickstart.ipynb | instalacja wheel, zaszumiony sygnał z TEXTFILE, AVG(v:100), okna i pętla treningowa PyTorch |
Notebook Colab porównuje średnią kroczącą z NumPy przed importem PyTorch i ponownie po treningu. Bez torch nadal sprawdza sygnał i okna, a następnie zapisuje pominięcie ML. Z torch trenuje na CUDA, gdy jest dostępna, w przeciwnym razie na CPU. T4 używa fp16 z GradScaler; GPU z natywną obsługą bf16, np. L4/A100, używają bf16. Loss kolejnych epok na CUDA jest porównywany z modelem CPU o tej samej inicjalizacji i tych samych batchach (rtol=0.05, atol=0.002). Notebook korzysta z istniejącego API StreamDataset z num_workers=0.
Pierwsza komórka przyjmuje WHEEL jako lokalną ścieżkę lub wzorzec glob albo bezpośredni URL HTTPS wheel, a SOURCE_COMMIT jako pełne SHA źródła z logu budowy wheel. Wheel można przesłać przez panel Files w Colab albo zmienić obie wartości. Skrypt smoke przekazuje RDB_WHEEL i RDB_SOURCE_COMMIT. Instalacja używa interpretera kernela i --no-deps; wersje NumPy i PyTorch przed instalacją i po niej muszą być takie same. Instalacja, pobranie (jeśli występuje) i import mają osobne pomiary czasu. Żaden próg czasu nie decyduje o wyniku. Ostatnia komórka zapisuje rdb-acceptance.json.
Przy pracy lokalnej RDB_PYTHON_MODULE_DIR wskazuje we wszystkich trzech notebookach katalog zbudowanego pakietu (budowanie biblioteki Python); interpreter musi być zgodny z rozszerzeniem. Bez tej zmiennej j0 i j1 wybierają pierwszy w kolejności sortowania build/*/python zawierający rozszerzenie. Notebooki otwiera się z api/python/notebooks albo ustawia RDB_REPO_DIR na korzeń checkoutu. Skrypt smoke ustawia tę zmienną także w kontenerze z checkoutem tylko do odczytu. j0 kopiuje wyłącznie fixtures danych, deskryptora i metadanych, pomijając aktualizację shadow, która zastąpiłaby pierwszy rekord.
docker/wheel/notebook-smoke.sh wykonuje wszystkie trzy notebooki przez nbclient, każdy w osobnym kernelu zarejestrowanym dla wybranego interpretera. Sprawdza ich JSON, odrzuca przestarzałe formy RQL, kończy się błędem przy błędzie komórki i w każdym notebooku sprawdza ścieżkę wybranego _core. pip freeze --all może zmienić się wyłącznie o dodany retractordb. Wyniki obejmują wersje Python/NumPy/PyTorch, nazwę pliku wheel, SHA źródła (podane z logu budowy), SHA-256 wheel, czasy instalacji i importu, czasy komórek, asercje NumPy oraz pomiary epok. Okna/s i średni czas kroku obejmują DataLoader, transfer na urządzenie i optymalizator; postęp silnika i trening referencyjny CPU są mierzone osobno. Pierwsza epoka obejmuje rozgrzewkę. Pomiary opisują tę demonstrację, a nie ogólną wydajność silnika.
Profil wheel tworzy czysty venv Python 3.12 z wersjami z scripts/notebook-versions.sh. Domyślny torch to wariant CPU. Te przypięte lokalne zależności nie deklarują bieżących wersji runtime Colab. Jawny profil --without-torch pomija torch i sprawdza, że pominięcie ML przebiegło poprawnie. Każdy profil potrzebuje osobnego katalogu wyników; wykonane notebooki i acceptance.json pozostają w nim po usunięciu tymczasowego venv. Bez --output-dir skrypt wypisuje zachowany katalog tymczasowy z wynikami.
Ręczna kontrola wydania
Ten krok wykonuje się po zbudowaniu bieżącego wheel (budowanie wheel), przed przekazaniem go użytkownikowi Colab lub dystrybucją. Oba profile zainstalowanego wheel muszą przejść; sam smoke modułu z builda nie spełnia kontroli wydania. Log budowy wheel należy zachować razem z raportem, aby SHA źródła było możliwe do prześledzenia. Build musi pochodzić z wskazanego commita; niezacommitowane zmiany wpływające na wheel trzeba zapisać, a przed wydaniem przebudować artefakt po przeglądzie i commicie.
# Pełne SHA z logu budowy wheel, nie przypuszczenie na podstawie starego wheel.
SOURCE_COMMIT="paste-full-source-SHA-from-build-log"
mkdir -p build/notebook-results/with-torch build/notebook-results/without-torch
docker run --rm -v "$PWD:/src:ro" -v "$PWD/build/notebook-results/with-torch:/results" \
python:3.12-slim bash /src/docker/wheel/notebook-smoke.sh \
--source-commit "$SOURCE_COMMIT" --output-dir /results
docker run --rm -v "$PWD:/src:ro" -v "$PWD/build/notebook-results/without-torch:/results" \
python:3.12-slim bash /src/docker/wheel/notebook-smoke.sh \
--source-commit "$SOURCE_COMMIT" --without-torch --output-dir /results
Bez argumentu wheel w build/wheelhouse/ musi być dokładnie jeden cp312-abi3 dla architektury hosta. Inny artefakt wybiera się jawnym plikiem lub URL HTTPS. PYTHON wybiera inny interpreter Python 3.12. RDB_TORCH_INDEX nadpisuje indeks CPU; RDB_TORCH_INDEX= (pusta wartość) rozwiązuje wersję wheel CPU z PyPI.
Kontrola modułu z builda wymaga istniejącego zgodnego interpretera z NumPy, nbclient, nbformat i ipykernel oraz torch, chyba że ustawiono --without-torch:
PYTHON="$PWD/.venv-jupyter-system-cpu/bin/rdb-python" \
docker/wheel/notebook-smoke.sh --module-dir build/Debug-Python/python \
--output-dir build/notebook-results/local-module
Ten profil niczego nie instaluje i nie mierzy instalacji wheel. Odbiór w rzeczywistym Colab CPU/GPU jest osobnym przebiegiem wykonywanym przez człowieka według protokołu poniżej. Jego datę, runtime i wynik obserwacji restartu raportuje się osobno od wyników kontenera.
Odbiór w kontenerze i w Google Colab
Protokół obejmuje gotowy wheel z pliku albo bezpośredniego URL HTTPS. Przebieg w kontenerze jest dowodem dla zainstalowanego wheel; odbiór w rzeczywistym Colab wymaga osobnych przebiegów CPU i GPU wykonanych przez człowieka. Ten protokół nie deklaruje żadnego wyniku z Colab.
Przygotowanie artefaktu
- Zbuduj wheel Linux x86_64 z zamierzonej rewizji źródeł przez
docker/wheel/build-wheels.sh x86_64. Zachowaj pełne SHA źródła i log budowy. Zapisz niezacommitowane zmiany wpływające na wheel; przed dystrybucją przebuduj z przejrzanego commita. Dla Python 3.12+ użyj naprawionego wheel cp312-abi3. - Zapisz jego nazwę pliku i
sha256sum build/wheelhouse/<nazwa-wheel>.whl. Ten sam wheel służy do odbioru w kontenerze i w Colab; nie starszy plik o tej samej wersji i nazwie. - Uruchom oba profile zainstalowanego wheel w kontenerze z ręcznej kontroli wydania. Zachowaj każdy
acceptance.jsoni trzy wykonane notebooki. Wymagajnotebook-smoke: OK - 3/3 notebooks; profil bez torch musi zapisaćtraining.status = skippedi udane asercje NumPy. Profil domyślny musi zapisać udany trening CPU. Porównaj SHA-256 wheel z krokiem 2.
Rzeczywisty Colab: CPU, następnie GPU
Każdy przebieg wykonuje się w świeżym runtime. Lokalne wykonanie notebooka ani kontener nazwany jak Colab nie kończą tego kroku.
- Prześlij
api/python/notebooks/colab_quickstart.ipynbprzez okno przesyłania notebooka w Colab. Użyj notebooka z tej samej rewizji źródeł co sprawdzany wheel. - W pierwszym przebiegu wybierz runtime CPU. Prześlij wheel przez panel Files do
/content/albo ustawWHEELw pierwszej komórce kodu na bezpośredni URL HTTPS. Ścieżka URL musi zawierać oryginalną nazwę pliku wheel; podpisany query string jest dopuszczalny. UstawSOURCE_COMMITna pełne SHA zapisane przez build. - Uruchom wszystkie komórki bez ręcznej instalacji lub podmiany NumPy i torch. Notebook instaluje wyłącznie
retractordbz--no-deps. Zachowaj wersje przed/po z pierwszej komórki, osobne czasy pobrania, instalacji i importu oraz ścieżkę_core. Porównaj zgłoszone SHA-256 wheel z przygotowanym artefaktem. - Wymagaj ukończenia obu asercji NumPy i komórki treningu. Rzeczywisty runtime Colab z torch musi trenować; niespodziewane pominięcie ML nie jest odbiorem CPU/GPU. Opcjonalną ścieżkę bez torch pokrywa osobno kontener.
- Pobierz
rdb-acceptance.jsoni wykonany notebook. Zapisz wersję i datę runtime Colab, wybór CPU lub GPU oraz to, czy Colab rzeczywiście wymagał restartu.restart_performed=falseopisuje wykonanie notebooka bez przerwy;restart_required=nullcelowo wymaga obserwacji człowieka. Nie zamieniaj tej nieznanej wartości na udowodniony brak restartu bez obserwacji przebiegu. Jeśli restart był wymagany, zachowaj wyjście sprzed restartu i jego powód, a następnie osobno zapisz ukończony przebieg po restarcie. - Powtórz w świeżym runtime GPU (np. T4). Wymagaj
training.device = cuda, rzeczywistej nazwy GPU, przepustowości epok i czasów kroku oraz zgodności loss z referencją CPU. Fallback na CPU nie jest odbiorem GPU. T4 powinien zgłosićtorch.float16z włączonym GradScaler; L4/A100 natywnetorch.bfloat16bez skalowania fp16. Zapisz to, co przydzielony runtime faktycznie udostępnia, łącznie z wersjami torch i CUDA.
Model otrzymuje kopie okien CPU ze StreamDataset, z num_workers=0. CUDA to osobny transfer na urządzenie. Implementacja korzysta z API AMP PyTorch: skalowanie gradientu przy fp16 oraz bf16, gdy runtime zgłasza jego natywną obsługę. Pomiar czasu epok używa synchronizacji CUDA.
Okna/s = przetworzone okna / sekundy pętli treningowej. Średni czas kroku = ten sam czas / liczba batchy. Obie miary obejmują ładowanie, transfery i optymalizację; postęp silnika i trening referencyjny CPU są raportowane osobno. Pierwsza epoka obejmuje rozgrzewkę. Zapisz wszystkie epoki; nie podawaj samej najszybszej jako wyniku. Ten mały model jest demonstracją, a nie ogólnym benchmarkiem silnika. Porównanie loss CUDA i CPU używa tej samej inicjalizacji, kolejności danych i parametrów SGD, z rtol=0.05, atol=0.002. Niespełniona asercja oznacza nieudany przebieg.
Zapisz warunki: przesłanie pliku czy URL, czas pobrania, zimny czy ciepły runtime, wersję Pythona, typ CPU/GPU i to, czy cache pakietów był już wypełniony. Czasy porównuj tylko w porównywalnych warunkach; instalacja w kontenerze nie mierzy Colab.
Opcje wywołania
RetractorDB składa się z trzech narzędzi wiersza poleceń, z których każde pełni odrębną rolę w architekturze systemu:
| Narzędzie | Rola |
|---|---|
xretractor | Proces przetwarzania: kompiluje RQL i realizuje jeden niezależny plan |
xqry | Klient: wyszukuje lub wskazuje instancję i komunikuje się przez jej IPC |
xtrdb | Narzędzie inspekcji: analizuje artefakty binarne i metadane |
Każde z narzędzi opisano w osobnym podrozdziale.
xretractor
Program xretractor jest podstawowym procesem systemu RetractorDB. Kompiluje pliki z zapytaniami RQL i realizuje plan przetwarzania danych. Przygotowany jest do uruchomienia autonomicznego jako proces demona systemd.
Tryby pracy
xretractor uruchamia się w jednym z dwóch trybów:
| Tryb | Opis |
|---|---|
| Przetwarzania | Domyślny - kompiluje zapytania i uruchamia pętlę realizacji zapytań |
Tylko kompilacja -c | Kompiluje zapytania bez uruchamiania pętli; umożliwia wizualizację planu |
Wywołanie -h pokazuje inną listę opcji w zależności od trybu - skróty opcji się nakładają, dlatego należy zwrócić uwagę, w którym trybie dana opcja funkcjonuje.
Tryb przetwarzania (domyślny)
$ xretractor -h
xretractor - compiler & data processing tool.
Usage: xretractor queryfile [option]
Available options:
-h [ --help ] Show program options
-b [ --build-info ] show optimizer build configuration
-c [ --onlycompile ] compile only mode
-q [ --queryfile ] arg query set file
-r [ --quiet ] no output on screen, skip presenter
-s [ --status ] check service status
-o [ --cleanup ] remove leftovers of dead instances and exit
-v [ --verbose ] verbose mode (show stream params)
-x [ --xqrywait ] wait with processing for first query
-n [ --name ] arg instance name; own IPC area and lock
-a [ --autoname ] generate a docker-style instance name
-k [ --noanykey ] do not wait for any key to terminate
-j [ --service ] service mode: log to stderr (journald)
-t [ --realtime ] enable real-time scheduling
-f [ --no-clock ] offline mode: compute slots without waiting
-u [ --until-eof ] forces one-shot all sources
-g [ --config ] arg config file (TOML); overrides search
-m [ --llimitqry ] arg (=0) loop iteration limit, 0 - no limit
Opcje trybu przetwarzania
| Opcja | Znaczenie |
|---|---|
help | Wyświetlenie tekstu podpowiedzi. Lista różni się w zależności od trybu (z -c lub bez). |
build-info | Wypisuje konfigurację optymalizatora, z jaką zbudowano binarkę (flagi RDB_OPT_* oraz RDB_BENCH_PROBE), i kończy działanie bez uruchamiania silnika. Obsługiwana przed wczytaniem i walidacją pliku konfiguracyjnego, więc działa także na hoście z niepoprawnym storage.dir. Wynik jest stabilny i przeznaczony do przetwarzania automatycznego - korzystają z niego scripts/buildrdb.sh oraz test it_optimizer_ablation-build-info. Szczegóły w załączniku o budowaniu produkcyjnym i wariantach diagnostycznych. |
onlycompile | Przełączenie narzędzia w tryb „tylko kompilacja“. Pętla realizacji zapytań nie jest uruchamiana. |
queryfile | Nazwa pliku z zapytaniami do kompilacji i uruchomienia. |
quiet | Pominięcie wyświetlania wyników na ekranie. Przetwarzanie działa normalnie, ale prezenter wyników nie jest uruchamiany. |
status | Sprawdzenie blokady instancji wskazanej przez --name, RDB_NAMESPACE albo historyczną pustą nazwę. Wynik Running oznacza, że inny proces utrzymuje tę samą tożsamość. |
cleanup | Usuwa rozpoznane pozostałości martwych instancji i kończy działanie bez uruchamiania planu. Dostępny także jako -o. Chroni zasoby żywych właścicieli; zakres i ograniczenia opisano poniżej. |
verbose | Wyświetla parametry strumieni oraz dodaje na stderr komunikat o strumieniach rosnących bez ograniczenia na dysku i ostrzeżenia o deklaracjach w przestarzałej formie DECLARE ... FILE (jedno na deklarację, z wierszem planu i wybranym słowem BINFILE, TEXTFILE albo DEVICE). Bez tej opcji ostrzeżeń o formie przestarzałej nie ma. Osobny wpis w dzienniku zależy od poziomu logowania. |
xqrywait | Kompiluje zapytania i wstrzymuje pętlę przetwarzania do zakończenia obsługi pierwszego polecenia klienta. Przy odbiorze przez xqry i ograniczonym przebiegu -m N zapobiega przetworzeniu całego budżetu przed podłączeniem klienta. xqry --select najpierw rejestruje subskrypcję, więc jej kolejka istnieje przed odblokowaniem pętli. Bramkę zwalnia jednak każde obsłużone polecenie, także --hello albo --dir innego klienta; nie oznacza to gotowości wszystkich odbiorców. Sygnał zatrzymania przerywa czekanie bez wykonania kroku zerowego. Przy analizie plików po zakończeniu przebiegu -x nie jest potrzebne. |
name arg | Nadaje instancji stałą nazwę. Nazwa wybiera osobny plik blokady i obszar IPC oraz pozwala kierować polecenia przez xqry --server. Dopuszczalne są najwyżej 32 znaki: małe litery, cyfry, _ i -, przy czym pierwszy znak musi być literą. |
autoname | Generuje nazwę instancji w stylu nazw kontenerów i wypisuje ją przy starcie. Wzajemnie wyklucza się z --name. |
noanykey | Wyłącza przerywanie pętli przetwarzania dowolnym klawiszem. Dodatni limit --llimitqry N również wyłącza to przerywanie, nawet bez --noanykey. Klawisz zatrzymuje przebieg bez limitu, jeśli nie podano tej opcji. Ctrl+C nadal zatrzymuje proces. |
service | Tryb usługowy: dziennik trafia na stderr (przechwytywany przez journald), bez pliku dziennika w katalogu tymczasowym, bez własnego znacznika czasu i bez kodów ANSI. Tryb można włączyć również zmienną środowiskową XRETRACTOR_SERVICE o dowolnej wartości poza pustą i 0 - wygodne w jednostce systemd przez Environment=. |
realtime | Włącza szeregowanie czasu rzeczywistego wątku przetwarzającego: SCHED_FIFO, mlockall oraz przeniesienie wątku komunikacyjnego poza rdzenie przypisane wątkowi przetwarzającemu. Harmonogramu slotów nie zmienia: sen do terminu liczonego od stałej kotwicy obowiązuje w każdym trybie taktowanym (patrz Harmonogram slotów). Wymaga uprawnień CAP_SYS_NICE i CAP_IPC_LOCK (lub root); bez nich wypisuje raport zgodności i pracuje bez tych ustawień. Zalecane w środowisku produkcyjnym przy wymogu deterministycznego czasu reakcji. |
no-clock | Tryb offline: zachowuje racjonalną oś czasu, indeksy logiczne, początki i ogony planu, ale pomija oczekiwanie na zegar ścienny. Termin TIMEOUT każdego źródła DEVICE wynosi wtedy 0. Nie może być łączony z --realtime. |
until-eof | Przełącza deklarowane źródła w tryb ONESHOT i kończy przebieg, gdy pierwsze z nich wyczerpie dane. Dla źródła DEVICE wyczerpaniem jest pierwszy koniec danych po otrzymaniu danych, czyli odejście pisarza. |
config | Ścieżka do pliku konfiguracyjnego w formacie TOML. Pomija standardową kolejność wyszukiwania (/etc/retractor/retractor.toml, następnie $XDG_CONFIG_HOME/retractor/retractor.toml lub ~/.config/retractor/retractor.toml). Brak plików w tych lokalizacjach pozwala użyć ustawień domyślnych; brak pliku wskazanego jawnie przez --config jest błędem. |
llimitqry | Ogranicza liczbę iteracji w pętli realizacji zapytań. Wartość 0 oznacza brak limitu. |
Wiele instancji
Różne nazwane instancje mogą działać równocześnie:
xretractor pomiary.rql --name pomiary --noanykey &
xretractor diagnostyka.rql --name diagnostyka --noanykey &
xqry --bus
Każda otrzymuje własną blokadę i zestaw obiektów IPC. Wspólna magistrala odrzuca jednak plan, który koliduje z żywą instancją nazwą strumienia, zapisywanym plikiem magazynu albo plikiem licznika :ROTATION. Kontrola odbywa się przed usuwaniem artefaktów. Brak --name zachowuje historyczną instancję bezimienną. Po sprawdzeniu wyłączności trybu usługowego instancja o tej samej nazwie co żywy wpis magistrali, w tym druga bezimienna, jest odrzucana kodem ENOLCK (37 na Linuksie) również wtedy, gdy jej plik blokady usunięto z katalogu tymczasowego.
Tryb usługowy stanowi osobną gwarancję: w każdej przestrzeni RDB_NAMESPACE może działać dokładnie jedna instancja usługowa, w domyślnej przestrzeni nazwana service. Szczegóły zawiera rozdział Wiele instancji i magistrala.
Plik blokady instancji musi być zwykłym plikiem z jedną nazwą, należącym do konta, które uruchamia instancję. Dowiązanie symboliczne (także wiszące), drugie twarde dowiązanie, katalog albo FIFO pod tą ścieżką oraz plik innego konta - również przy instancji uruchomionej jako root - zatrzymują start bez zmiany zawartości wskazanego pliku. Komunikat na stderr, widoczny także w Release, podaje ścieżkę i przyczynę, a kod wyjścia 5 (EIO) odróżnia tę odmowę od zajętej tożsamości (ENOLCK, 37 na Linuksie, komunikat is already running). Pozostałości innego konta po awarii instancja nie przejmuje, a --cleanup jej nie usuwa; usuwa ją ręcznie operator z uprawnieniami do katalogu blokad. Odczyt blokad obecności i tożsamości IPC innych kont pozostaje dozwolony.
Sprzątanie pozostałości
xretractor --cleanup
Polecenie nie uruchamia planu. Próbuje zająć blokady rozpoznanych zasobów i usuwa wyłącznie te, których nie utrzymuje żywy właściciel. Ten sam mechanizm działa przy wyjściu instancji.
| Zakres | Działanie |
|---|---|
| Pliki blokad instancji | Przegląd katalogu paths.lock_dir wybranego konfiguracją, domyślnie katalogu tymczasowego procesu. |
| Tożsamości IPC | Przegląd wspólnego /tmp; usunięcie porzuconej blokady oraz odpowiadającej jej kolejki poleceń, segmentu odpowiedzi i muteksu mapy. Obiekty instancji z żywym slotem w magistrali bieżącej przestrzeni pozostają. |
| Magistrala | Usunięcie segmentów bieżącej wersji xrdbbus_v7, których nikt nie trzyma blokadą obecności i w których żaden slot nie należy do żywej instancji. |
Zakres nie jest ograniczony do jednej instancji wskazanej przez --name ani jednej przestrzeni RDB_NAMESPACE. Dostęp do zasobów nadal podlega uprawnieniom systemu plików. Polecenie nie wylicza i nie usuwa kolejek odpowiedzi klientów; nie usuwa też segmentów v5 i starszych, które nie uczestniczą w protokole blokady obecności.
Wynik zawiera liczniki usuniętych blokad instancji, zestawów tożsamości IPC i segmentów, np.:
Removed leftovers of dead instances: 1 instance lock(s), 1 IPC identity set(s), 1 bus segment(s).
Licznik zestawów IPC nie jest liczbą pojedynczych kolejek. Zakończenie polecenia nie dowodzi usunięcia zasobów spoza jego zakresu. Przy niestandardowym katalogu blokad należy wskazać właściwy TOML przez --config.
Przetwarzanie wsadowe bez zegara
Najprostszy przebieg całego pliku bez ręcznego dobierania liczby iteracji ma postać:
xretractor query.rql --no-clock --until-eof --noanykey --quiet
--no-clock usuwa wyłącznie uśpienia. Nie zmienia kolejności slotów ani zawartości artefaktów, dlatego nadaje się do szybkiej weryfikacji po zakończeniu procesu. Może jednak wyprzedzić klienta xqry, więc nie jest właściwym trybem do obserwacji na żywo.
--until-eof sprawia, że źródło sekwencyjne nie wraca na początek pliku. Koniec jest sprawdzany po przetworzeniu slotu, dokładnie przed rekordem, który musiałby już powstać ze syntetycznego NULL za końcem danych. Źródło DEVICE jest czytane na początku slotu, więc jego wyczerpanie jest sprawdzane przed slotem - z tym samym skutkiem. Przy wielu źródłach kończy pierwsze wyczerpane, aby plan nie kontynuował obliczeń z brakującym wejściem. Opcję można łączyć z -m N; działa warunek, który wystąpi wcześniej.
Brak deklarowanego źródła, brak prawa odczytu lub nieudane otwarcie kończy wykonanie błędem środowiska K4 i kodem EIO (5 na Linuksie). Dotyczy to TEXTFILE, BINFILE i DEVICE, także bez -u. Komunikat wskazuje strumień, ścieżkę i przyczynę. Kontrola przed startem pozostawia poprzednie wyniki bez zmian; tryb -c nie wymaga dostępnego wejścia. Szczegóły: kontrola źródeł.
⚠️ Ostrzeżenie Skróty zależą od trybu. W wykonaniu
-foznacza--no-clock, a-uoznacza--until-eof. Przy-cte same litery oznaczają odpowiednio--fieldsi--rulesoraz nie uruchamiają przetwarzania.
NOTE: Równoważność wykonania taktowanego i offline sprawdza
noclock_offline, a zatrzymanie na pierwszym końcu danych i kontrolę zawijania sprawdzauntileof_stop.
Tryb tylko kompilacja (-c)
$ xretractor -h -c
xretractor - compiler & data processing tool.
Usage: xretractor -c queryfile [option]
Available options:
-h [ --help ] show help options
-b [ --build-info ] show optimizer build configuration
-c [ --onlycompile ] compile only mode
-q [ --queryfile ] arg query set file
-r [ --quiet ] no output on screen, skip presenter
-v [ --verbose ] verbose mode (show stream params)
-d [ --dot ] create dot output
-m [ --csv ] create csv output
-f [ --fields ] show fields in dot file
-t [ --tags ] show tags in dot file
-s [ --streamprogs ] show stream programs in dot file
-u [ --rules ] show rules in dot file
-i [ --hideruleprog ] hide rule program in rules (-u) output
-p [ --transparent ] make dot background transparent
-w [ --diagram ] arg create diagram output
-z [ --shmbudget ] show shared memory budget of the compiled plan
-g [ --config ] arg config file (TOML); overrides search
W tym trybie dostępne są opcje tworzenia diagramów i zrzutów diagnostycznych opisywanych szerzej w opracowaniu. -v jest dostępne również przy kompilacji bez uruchamiania planu.
Opcje wizualizacji i diagnostyki
| Opcja | Znaczenie |
|---|---|
help | Wyświetlenie tekstu podpowiedzi (identycznie jak w trybie przetwarzania, lista różni się w zależności od trybu). |
build-info | Znaczenie identyczne jak w trybie przetwarzania - wypisuje konfigurację optymalizatora i kończy działanie. Flaga -c nie ma na wynik wpływu; opcja jest dostępna w obu trybach, aby zrzut konfiguracji dał się pobrać niezależnie od sposobu wywołania. |
onlycompile | Włączony - w tej tabeli opisano opcje obowiązujące przy aktywnej fladze -c. |
queryfile | Nazwa pliku z zapytaniami do kompilacji. |
quiet | Testowanie samego procesu kompilacji bez prezentowania wyników. Pozostałe opcje prezentacji nie są uruchamiane. Opcja dołączona na potrzeby rozwojowe. |
dot | Tworzy plik tekstowy w formacie DOT opisujący hierarchiczne struktury wytworzone przez kompilator. Plik można przekazać do narzędzia Graphviz w celu wygenerowania graficznego opisu zależności. |
csv | Eksportuje hierarchiczne struktury danych do pliku CSV (wartości oddzielone przecinkami). |
fields | Dołącza do wykresu DOT pola i ich typy dla każdego strumienia danych. |
tags | Dołącza do wykresu DOT programy wewnętrznego języka systemu, które tworzą pola poszczególnych zapytań. Musi być wywołana razem z fields - wizualnie łączy pola z ich programami. |
streamprogs | Dołącza do wykresu DOT programy algebry strumieniowej tworzące poszczególne strumienie zapytań. |
rules | Dołącza reguły alarmowania do wykresu. |
hideruleprog | Ukrywa programy opisujące warunki alarmowania (używane razem z rules). |
transparent | Generuje wykres z przezroczystym tłem. |
diagram | Generuje diagramy kulkowe. Argument typ[:ilość_cykli]: 0 wyłącza siatkę czasu, 1 ją włącza; dodatnia całkowita liczba cykli domyślnie wynosi 1. Cały argument musi być poprawną liczbą lub parą liczb; błędny typ, pusta część po dwukropku i niedodatnia liczba cykli dają błąd argumentu. Pusty plan i liczba cykli powodująca przepełnienie siatki również są odrzucane. |
shmbudget | Raportuje stałą rezerwację IPC, pojemność i wolne miejsce systemu plików shm_open (zwykle /dev/shm) oraz koszt jednej kolejki klienta dla każdej delty planu. Pozwala oszacować liczbę równoczesnych subskrypcji przed uruchomieniem serwera. |
config | Wskazuje jawny plik TOML także w trybie -c; ustawienia retencji i budżetu historii obowiązują podczas kompilacji. |
Plik konfiguracyjny (TOML)
Opcja --config (skrót -g) wskazuje plik konfiguracyjny także przy -c; bez niej program przeszukuje warstwowo dwie lokalizacje, w podanej kolejności, a każda kolejna warstwa nadpisuje klucze poprzedniej:
/etc/retractor/retractor.toml- warstwa systemowa,$XDG_CONFIG_HOME/retractor/retractor.toml(lub~/.config/retractor/retractor.toml) - warstwa użytkownika.
Brak wykrytych plików jest stanem poprawnym - program startuje z wartościami domyślnymi. Istniejący plik z błędną składnią TOML zatrzymuje start: program zwraca niezerowy kod wyjścia i raportuje błąd na poziomie ERROR z nazwą pliku oraz przyczyną, także w kompilacji Release. Każda wczytywana warstwa musi być poprawna, nawet jeśli kolejna nadpisałaby jej klucze. Przy jawnie podanej ścieżce (--config) błędem pozostaje również brak pliku. Ten sam loader konfiguracji jest używany przez xqry (opcja --config pod skrótem -e) i xtrdb; te programy również odmawiają pracy przy uszkodzonym pliku. Opcja --help działa w każdym z trzech programów niezależnie od konfiguracji; xretractor pokazuje wtedy błąd w linii Config: pomocy. Sekcje [ipc] i [timing] dotyczą silnika i klienta xqry.
| Klucz | Domyślnie | Znaczenie |
|---|---|---|
storage.dir | (brak) | Domyślny katalog artefaktów. Stosowany tylko gdy zestaw RQL nie zawiera dyrektywy :STORAGE - RQL ma pierwszeństwo. Katalog musi istnieć i być zapisywalny, inaczej program kończy się błędem Configuration error: storage.dir …. |
storage.default_retention | (brak) | Para [pojemność, segmenty], obie dodatnie. Nadaje ograniczoną retencję strumieniom plikowym DEFAULT i DIRECT bez własnego RETENTION, także substratom. Nie zmienia MEMORY, magazynów bez retencji ani jawnej retencji. Niepoprawna wartość daje ostrzeżenie i brak retencji domyślnej. |
storage.ref_dirs | (brak) | Czyta xtrdb. Lista bezwzględnych ścieżek istniejących katalogów, do których pole REF zachowanego .desc może przenieść zapisywalny plik danych. Bez klucza REF wzięty z .desc zapisuje i usuwa tylko w katalogu magazynu; odczyt źródeł BINFILE, TEXTFILE i DEVICE oraz REF z planu nie podlegają ograniczeniu. W xretractor REF zachowanego .desc musi być równy REF planu, więc klucz nie zmienia działania silnika. Niepoprawny wpis zatrzymuje start xtrdb błędem Configuration error: storage.ref_dirs …. |
sources.timeout_s | (brak, czyli 0) | Termin odczytu w sekundach dla źródeł DEVICE bez klauzuli TIMEOUT (→ Odczyt źródła DEVICE i TIMEOUT). Jawna klauzula w RQL wygrywa, także TIMEOUT 0. W trybie --no-clock termin wynosi 0. Nie zmienia BINFILE, TEXTFILE ani timing.query_no_data_timeout_ms. Wartość ujemna, nieliczbowa albo większa od 86400 kończy start błędem Configuration error: sources.timeout_s …. |
ipc.queue_buffer_seconds | 10 | Głębokość kolejki IPC wyrażona w sekundach strumienia; liczba elementów to sekundy / interwał. |
ipc.min_queue_elements | 100 | Dolna granica pojemności kolejki, niezależna od interwału strumienia. |
ipc.client_response_max_fails | 300 | Mnożnik budżetu czasu dla odpowiedzi xqry. Termin jest wyznaczany zegarem monotonicznym jako ta wartość razy interwał odpytywania (10 ms) i obejmuje zarówno oczekiwanie na miejsce w kolejce poleceń, jak i na odpowiedź. |
timing.server_startup_wait_s | 30 | Maksymalny czas oczekiwania xqry --wait-server na gotowość serwera. |
timing.server_startup_poll_ms | 100 | Interwał odpytywania podczas oczekiwania na start serwera. |
timing.query_no_data_timeout_ms | 10000 | Czas braku danych, po którym klient xqry uznaje serwer za martwy. |
scheduling.rt_priority | 50 | Priorytet SCHED_FIFO w trybie --realtime; dopuszczalny zakres 1–99. |
paths.lock_dir | (katalog tymczasowy systemu) | Katalog na pliki blokad instancji. Dla usług systemd zalecane /var/run/retractor lub $XDG_RUNTIME_DIR. Niepusta ścieżka musi być bezwzględna w każdej wczytywanej warstwie; względna zatrzymuje start z błędem ERROR zawierającym nazwę pliku i przyczynę, także w Release. Pusta wartość zachowuje domyślny katalog tymczasowy. Nie zmienia stałego katalogu /tmp blokad tożsamości IPC. |
server.autoname | false | Generuje nazwę, gdy nie podano --name ani --autoname. Jawne --name wygrywa. Wartość false zachowuje historyczną instancję bezimienną. |
service.query_file | (wartość z konfiguracji budowania) | Plik zapytań nadpisywany przy przekazaniu zestawu działającej usłudze. Używany wyłącznie jako zapasowy, gdy usługa nie zaraportowała własnego QUERYFILE w pliku blokady. Musi być zgodny z argumentem ExecStart jednostki systemd - konfiguracja nie zmienia ExecStart. |
service.unrestricted | false | Dopuszcza regułę DO SYSTEM w planie przyjmowanym kanałem xqry --reset. Wartość domyślna odrzuca taki plan w całości (→ xqry). Przy true instancja zostawia ostrzeżenie w dzienniku przy każdym starcie, a każdy, kto potrafi otworzyć jej obiekty IPC, wykona polecenie powłoki na jej koncie. Klucz czytany jest przy starcie procesu, więc ustawia go ten sam autorytet, który pisze plik planu usługi; kanału ad hoc nie otwiera w żadnym wypadku. |
limits.history_memory_mib | 1024 | Łączny budżet historii źródeł DECLARE i magazynów MEMORY w MiB. Przekroczenie odrzuca plan przy starcie, w -c, ad hoc i przy --reset. Wartość musi być dodatnia; niepoprawna daje ostrzeżenie i wartość domyślną. Szczegóły: Granice wymiarów planu. |
Obiekty IPC tworzone przez serwer - segment odpowiedzi, kolejka komend, kolejki subskrypcji i segment magistrali - dostają jawny tryb 0600. Tworzenie kolejek i segmentu odpowiedzi używa create_only; otwarcie istniejącego obiektu wymaga właściciela zgodnego z efektywnym UID procesu oraz trybu 0600. xqry musi zatem działać z tym samym efektywnym UID co serwer, także gdy wywołuje go administrator, na przykład przez sudo -u retractor xqry --server service --dir. Obce obiekty są odrzucane i nie są usuwane podczas sprzątania. Szczegóły kolizji, restartu i magistrali opisuje granica dostępu IPC.
Wartości spoza sensownego zakresu nie zatrzymują usługi: program zapisuje ostrzeżenie w dzienniku i używa wartości domyślnej. Wyjątkami są storage.dir, którego niepoprawność wskazywałaby, że wyniki trafiłyby w niezamierzone miejsce lub nigdzie, oraz sources.timeout_s, którego cicha zamiana na wartość domyślną zmieniłaby sposób czekania na źródła - obie są błędem twardym xretractor. xqry klucza sources.timeout_s nie sprawdza. Błędem twardym, ale xtrdb, jest też niepoprawny storage.ref_dirs: lista uprawnień zapisu nie może zgadywać.
Przykładowy plik:
[storage]
dir = "/var/lib/retractor"
default_retention = [1000, 4]
[sources]
timeout_s = 0.01
[limits]
history_memory_mib = 1024
[ipc]
queue_buffer_seconds = 30
[scheduling]
rt_priority = 60
[paths]
lock_dir = "/var/run/retractor"
[server]
autoname = false
NOTE: Wczytywanie warstw i walidację pokrywa test jednostkowy
ut_appConfig; twarde odrzucenie niepoprawnegostorage.dir, uszkodzonego pliku TOML i względnegopaths.lock_dir- test integracyjnyconfig_storage_validation, a pierwszeństwo i odrzuceniesources.timeout_s- test integracyjnydevice_timeout.
Usługa i wymiana planu
Start bez pliku .rql albo z pustym plikiem tworzy bezczynną instancję z działającym IPC. Pierwszy lub kolejny pełny plan można załadować bez restartu:
xqry --server service --reset plan.rql
Serwer parsuje i kompiluje całą treść, sprawdza zachowane pliki .desc, zgodność magazynów przy :ROTATION oraz kolizje zasobów, rezerwuje nowy zestaw, a następnie przełącza plan na granicy slotu. Błędny składniowo, pusty albo niezgodny z planem deskryptor powoduje odmowę z przyczyną; poprzedni plan i plik startowy usługi pozostają bez zmian. Pusty plik resetu przywraca stan bezczynny. W instancji usługowej serwer próbuje również zapisać zaakceptowaną treść w pliku startowym usługi. Niepowodzenie zapisu jest logowane i nie zatrzymuje nowego planu, lecz po restarcie usługa może wrócić do poprzedniej treści. Odpowiedź OK na reset nie gwarantuje trwałości planu.
Alternatywna ścieżka xretractor nowy-plan.rql wykrywa działającą jednostkę systemd, weryfikuje zestaw, magazyny, deskryptory i licznik rotacji przed atomowym nadpisaniem jej pliku startowego i zleceniem restartu. Odmowa z powodu planu kończy się kodem EPROTO (na Linuksie 71), a z powodu środowiska kodem EIO (5); komunikat zawiera nothing was changed. Działająca usługa zachowuje plan i nie jest restartowana. Jawne wskazanie innej tożsamości przez --name albo --autoname oznacza zamiast tego start osobnej instancji.
Start, dostarczenie planu, reset i import ad hoc używają wspólnej kontroli magazynów przed zmianą planu. Sprawdzane są katalog STORAGE (musi istnieć także dla planu używającego wyłącznie MEMORY), zachowane profile i deskryptory, istnienie, rodzaje i prawa odczytu źródeł oraz możliwość otwarcia wyjściowych plików danych i odpowiednich .shadow. Kontrola otwarcia nie tworzy nowych plików. Niepoprawny .desc daje diagnostykę ze ścieżką, a błąd składni również z wierszem i kolumną. Deskryptory źródeł DECLARE są sprawdzane zawsze; przy starcie i resecie deskryptory wyników i substratów są sprawdzane, gdy :ROTATION zachowuje ich pliki. Import ad hoc sprawdza deskryptory nowych strumieni także bez rotacji i dla MEMORY, ponieważ ich wcześniej nie usuwa.
Odmowa planu a awaria środowiska
| Przyczyna | Reakcja xretractor | Plik planu w jednostce systemd |
|---|---|---|
Błąd planu: składnia, kompilacja, brak katalogu STORAGE, niezgodny zachowany .desc lub wadliwa zawartość licznika | odmowa, EPROTO (71 na Linuksie) | opróżniany przy odmowie startu; kolejny start jest bezczynny |
Błąd środowiska K4: brak źródła DECLARE, odmowa dostępu, awaria I/O, nieczytelny licznik lub dowiązanie zamiast pliku wyjścia (ELOOP) | EIO (5); podczas pracy komunikat FATAL (environment): | zachowany do ponownego startu po naprawie |
Naruszenie niezmiennika silnika, rdb::fatal() lub granica FatalError | EXIT_FAILURE (1), komunikat FATAL: | opróżniany przez procedurę wyjścia |
Rdzeń przekazuje błędy wykonania przez Result. Granica xretractor rozróżnia Errc::IO od błędu wewnętrznego i wykonuje odpowiednią procedurę zakończenia; rdb::fatal() korzysta z handlera zainstalowanego przez launcher. Jednostka systemd od #475 używa także ExecStopPost: po SIGABRT lub OOM kill opróżnia plik planu, ponieważ te zakończenia nie uruchamiają atexit. Zwykła awaria I/O pozostawia plan. Ta polityka wymaga aktualnej jednostki i pomocnika xretractor-stop-post, a nie samej wymiany binarki. Sprawdza ją it_service_abort-run.
Kod EIO oznacza kategorię błędu procesu; przyczyny takie jak EACCES lub ENOSPC są podawane w diagnostyce. Poza jednostką plik .rql operatora pozostaje nietknięty. Tryb -c nie wykonuje kontroli źródeł deklarowanych, plików magazynu ani licznika i nie opróżnia pliku zapytań, także w jednostce. Odmowa żądania resetu lub ad hoc przed jego przyjęciem wraca do klienta, a działający serwer zachowuje plan.
Pomyślna kontrola nie gwarantuje późniejszego otwarcia plików, które mogą w międzyczasie zmienić się na dysku. Odmowa podczas budowy modelu zachowuje klasę przyczyny: błąd planu daje EPROTO, błąd środowiska EIO, a częściowy model nie jest publikowany. Przy resecie zmiana po odpowiedzi OK, lecz przed budową modelu, może zakończyć proces tym samym kodem; poprzedni model jest już wtedy rozebrany. Reset nie zapewnia wycofania tej późnej awarii. Kontrole opisują testy it_storage_refusal-*, it_plan_error_e4-run, it_env_error_exit-run, it_untileof_stop-missing-sources i ut_fatalError.
Dostarczany szablon jednostki systemd ma Restart=on-failure, RestartSec=5, RestartSteps=5 i RestartMaxDelaySec=5min. W wersjach obsługujących te klucze odstęp ponowień rośnie od 5 sekund do 5 minut w pięciu krokach. Szablon nie ustawia StartLimit*, więc nadal obowiązują limity administratora; nie gwarantuje nieograniczonego ponawiania. Zachowanie starszych wersji systemd trzeba sprawdzić na hoście docelowym. Zachowanie planu po awarii środowiska nie jest checkpointem: restart nie gwarantuje odtworzenia stanu ani braku utraty lub powtórzenia danych.
Informacje o wersji
Na końcu każdego komunikatu pomocy wyświetlana jest linia z informacjami o buildzie:
Branch: issue_31-doc:2707ce0,
Code compiler: GNU Ver. 13.3.0,
Build time: 2512211449,
Type: Debug
| Pole | Znaczenie |
|---|---|
Branch | Nazwa odnogi repozytorium i skrót commita (hash), z którego zbudowano program |
Code compiler | Wersja kompilatora GCC użytego do budowy |
Build time | Data i godzina kompilacji w formacie YYMMDDHHMM (tu: 21 grudnia 2025, godz. 14:49) |
Type | Typ buildu: Debug lub Release |
Kolejna linia wskazuje lokalizację pliku dziennika:
Log: /tmp/xretractor.log
Plik /tmp/xretractor.log rejestruje historię wywołań i zdarzeń wewnętrznych systemu. W środowisku produkcyjnym należy zadbać o regularne czyszczenie lub rotację tego pliku.
Linia Config: Defaults oznacza brak wczytanych plików TOML. Jeżeli konfiguracja została wczytana, Config: wypisuje ścieżki plików w kolejności ładowania. Przy błędzie składni planu ładowanego z pliku wpis parsera w dzienniku podaje także ścieżkę tego pliku.
Ostatnia linia zawiera informację o licencji MIT, która umożliwia bezpieczne użycie kodu w zastosowaniach korporacyjnych.
xqry
Program xqry komunikuje się z działającym procesem xretractor przez Boost IPC. Odczytuje bieżące rekordy, pokazuje plan i schematy, dołącza pojedyncze polecenia RQL, wymienia cały plan oraz zatrzymuje wskazaną instancję. Wiele procesów xqry może działać równocześnie, także wobec różnych serwerów.
Uruchomienie
$ xqry -h
xqry - data query tool.
Usage: xqry [option]
Allowed options:
-s [ --select ] arg show this stream
-t [ --detail ] arg show details of this stream
-a [ --adhoc ] arg adhoc query mode
-q [ --reset ] arg replace the whole plan of the target instance
with this RQL file
-m [ --elimitqry ] arg (=0) limit of elements, 0 - no limit
-n [ --null ] if null row appear - skip it in output
-l [ --hello ] diagnostic - hello db world
-k [ --kill ] kill xretractor server
-d [ --dir ] list of queries
-v [ --vars ] list plan variables (VAR) with their current
values
-y [ --yaml ] yaml output format for --dir, --detail, --vars
and --bus
-j [ --jsonl ] versioned JSON Lines API output
-i [ --idle-timeout ] arg (=0) JSONL idle timeout in ms; 0 disables
-r [ --raw ] raw output mode (default)
-g [ --graphite ] graphite output mode
-f [ --influxdb ] influxDB output mode
-p [ --gnuplot ] arg x,y - gnuplot output mode
-z [ --gnuplot-rtl ] gnuplot output: newest samples on the right
-o [ --gnuplot-ohlc ] gnuplot output: row = open, high, low, close,
then the samples of that candle
-e [ --config ] arg config file (TOML); overrides search
-h [ --help ] produce help message
-c [ --needctrlc ] force ctl+c for stop this tool
-w [ --wait-server ] poll until xretractor server is available
-x [ --server ] arg target xretractor instance name
-b [ --bus ] list live xretractor instances and their streams
Wybór instancji
Jawne --server nazwa wybiera instancję bez korzystania z automatycznego routingu:
xqry --server pomiary --dir
xqry --server pomiary --select temperatura
xqry --server pomiary --kill
Bez tej opcji klient czyta magistralę bieżącej przestrzeni nazw: domyślną xrdbbus_v7 albo xrdbbus_v7_<namespace> przy ustawionym RDB_NAMESPACE. Przy jednej żywej instancji wybiera ją automatycznie. Przy kilku instancjach --select i --detail trafiają do właściciela podanego strumienia. Polecenia dotyczące całej instancji (--hello, --dir, --vars, --kill, --reset) są niejednoznaczne i wymagają --server. Zbiorcza lista --bus opisana niżej nie zmienia tego routingu.
Routing ad hoc analizuje źródła z FROM, a dla RULE strumień z ON. Wszystkie muszą należeć do jednego serwera. DECLARE nie zawiera adresata, więc przy wielu instancjach również wymaga --server. Literówka w nazwie i zapytanie przecinające granicę serwerów są odrzucane przed wysłaniem polecenia.
Lista instancji: --bus
xqry --bus bez ustawiania RDB_NAMESPACE wykrywa dostępne magistrale bieżącej wersji i wypisuje osobną sekcję NAMESPACE: dla każdej z co najmniej jedną żywą instancją. Działa tak samo przy ustawionym RDB_NAMESPACE: lista obejmuje wszystkie dostępne przestrzenie nazw, podczas gdy pozostałe polecenia nadal używają bieżącej przestrzeni. (default) oznacza magistralę bez przestrzeni nazw, a (unnamed) - zgodną wstecz instancję uruchomioną bez nazwy. Sekcje są uporządkowane według nazwy magistrali, domyślna jest pierwsza, a instancje w sekcji są sortowane po nazwie.
Klient odczytuje rejestry w pamięci dzielonej bez kontaktowania się z serwerami. Pomija segmenty bez żywych instancji. Uprawnienia obiektów pamięci dzielonej ograniczają wykrywanie do magistral dostępnych dla bieżącego konta.
$ xqry --bus
NAMESPACE: (default)
SERVER | PID | MODE | QUERY | STREAMS
-------+--------+------+--------------------+--------
alfa | 249247 | N | .../plans/alfa.rql | srca
| | | | dsta
MODE: N=normal, R=realtime, F=no-clock, U=until-eof, M=llimitqry, X=xqrywait, S=service
NAMESPACE: bus_probe
SERVER | PID | MODE | QUERY | STREAMS
-------+--------+------+-------+--------
probe | 249249 | N | - | -
MODE: N=normal, R=realtime, F=no-clock, U=until-eof, M=llimitqry, X=xqrywait, S=service
Ścieżka w tabeli jest skracana dla czytelności. --bus --yaml zachowuje pełną ścieżkę i jedną listę servers, w której pole namespace wskazuje magistralę każdej instancji. null oznacza magistralę domyślną, a nazwa przestrzeni jest cytowanym napisem:
---
apiVersion: xqry/v1
servers:
- name: alfa
namespace: null
pid: 249247
modes: N
query: "/home/user/plans/alfa.rql"
streams:
- srca
- dsta
- name: probe
namespace: "bus_probe"
pid: 249249
modes: N
streams: []
Gdy żadna dostępna magistrala nie ma żywej instancji, wynik tabelaryczny na stdout jest pusty, a YAML zawiera servers: []. Komunikat xqry: no live xretractor instance trafia na stderr.
Lista i szczegóły strumieni
--dir wypisuje wyrównaną tabelę:
$ xqry --server alfa --dir
name | duration | size | count | location | cap
------+----------+------+-------+---------------+----
core0 | 1/10 | -1 | 0 | datafile2.dat | 4
str1 | 1/30 | 0 | 0 | | 0
duration jest dokładnym interwałem strumienia, size rozmiarem zapisanych danych, count liczbą rekordów, location plikiem źródła, a cap pojemnością historii wyliczoną przez kompilator. Dla deklarowanego źródła size ma wartość -1.
--detail strumień pokazuje oryginalne zapytanie i pola. Modyfikator --yaml przełącza --dir, --detail, --vars i --bus na dokument apiVersion: xqry/v1; nie jest samodzielnym poleceniem. Nieznany strumień kończy działanie kodem 2.
Odpowiedzi na polecenia są dopasowywane do konkretnego żądania klienta. Budżet czasu ipc.client_response_max_fails obejmuje wysłanie polecenia i odebranie odpowiedzi; pełna kolejka poleceń kończy się odmową po upływie tego terminu. Odpowiedź porzucona przez zabitego klienta może zostać odzyskana bez blokowania kolejnych klientów.
Oczekiwanie na miejsce w kolejce komend używa nieblokujących prób wysłania i wspólnego terminu liczonego zegarem monotonicznym. Chwilowo pełna kolejka może więc przyjąć komendę, jeśli miejsce zwolni się przed terminem; nie jest odrzucana natychmiast. Przypadki obu wyników sprawdza ut_ipcClient.
Dopasowanie odpowiedzi obejmuje PID klienta, znacznik startu jego procesu i numer żądania. Znacznik klient przesyła w db.start; serwer odczytuje go sam tylko dla starszych klientów, które nie podają niezerowej wartości. Ograniczenie widoczności wpisu procesu klienta, np. przez hidepid, nie zmienia więc adresata odpowiedzi nowego klienta. Równoczesne żądania z kilku wątków jednego procesu zachowują własne odpowiedzi: odbiór jednego nie zwalnia odpowiedzi na inne, nadal oczekujące żądanie. Pokrycie stanowią ut_ipcResponses i ut_ipcServer.
Własny klient IPC nie może przesyłać dyrektyw formatu INFO, takich jak linia #include. Serwer odrzuca wiadomość z linią zaczynającą się od # po opcjonalnych białych znakach, zanim parser mógłby odczytać wskazany plik; nie wykonuje polecenia ani nie wysyła odpowiedzi. Znak # wewnątrz wartości, np. operator przeplotu w zapytaniu ad hoc, pozostaje dozwolony.
Zmienne planu: --vars
xqry --server pomiary --vars (krótko -v) wypisuje zmienne VAR w kolejności deklaracji:
name | type | value
------+----------+------
COUNT | INTEGER | 42
GAIN | FLOAT | 0.5
RATIO | RATIONAL | 1/3
type to typ z deklaracji, a value to wartość zatwierdzona na końcu ostatniego slotu; NULL jest drukowane jako null. Odczyt odbywa się między slotami i pokazuje spójny stan wszystkich zmiennych. Przed pierwszym slotem są to wartości z deklaracji. Stałe LET nie są listowane.
Z --yaml odpowiedź ma postać:
---
apiVersion: xqry/v1
variables:
- name: COUNT
type: INTEGER
value: 42
- name: GAIN
type: FLOAT
value: 0.5
- name: RATIO
type: RATIONAL
value: 1/3
Plan bez VAR daje sam nagłówek tabeli i separator, a bezczynna instancja no active plan; oba przypadki mają kod 0. W YAML oba zwracają variables: []. Brak działającego serwera pozostaje błędem IPC. Przy kilku instancjach podaj --server, ponieważ polecenie dotyczy całego planu. --vars --jsonl jest odrzucane kodem 22.
Polecenie tylko czyta; nie ma bezpośredniego przypisania wartości przez xqry. Zmiany zleca reguła DO SET, także dołączona ad hoc. Przyjęty --reset przywraca wartości z deklaracji. Szczegóły opisuje VAR i DO SET. Pokrycie: it_var_xqry-run.
Odbiór danych
| Opcja | Znaczenie |
|---|---|
-s / --select strumień | Subskrybuje bieżące rekordy strumienia. |
-m / --elimitqry N | Kończy po odebraniu N rekordów, o ile serwer nie zakończy strumienia wcześniej; 0 oznacza brak limitu. Przy dodatnim limicie dowolny klawisz nie przerywa odbioru, także bez --needctrlc. |
-n / --null | W formacie raw pomija wypisywanie rekordów, w których wszystkie wartości są NULL; te rekordy nadal zużywają budżet --elimitqry. |
-c / --needctrlc | Wymaga Ctrl+C zamiast zakończenia dowolnym klawiszem. |
Jedna subskrypcja tworzy własną kolejkę odpowiedzi. Po zatrzymaniu lub wymianie planu serwer próbuje wysłać znacznik końca, po czym usuwa nazwę kolejki także wtedy, gdy wysyłanie zawiedzie. Pełna kolejka może nie przyjąć znacznika; porzucona blokada kolejki po śmierci klienta również nie zatrzymuje sprzątania. Odebrany znacznik kończy odbiór; brak znacznika, także po nagłej awarii, jest wykrywany przez timeout timing.query_no_data_timeout_ms. Zachowanie końcowego wysyłania i sprzątania sprawdza ut_ipcServer.
Subskrypcja na granicy epok planu
Subskrypcja jest związana z jedną epoką planu. Jeśli serwer zamknie tę epokę między odczytaniem parametrów strumienia a rejestracją klienta, np. podczas --reset lub zatrzymywania instancji, odmawia rejestracji i usuwa przygotowaną kolejkę odpowiedzi. Nie przenosi spóźnionej subskrypcji do nowego planu, nawet gdy zawiera on strumień o tej samej nazwie.
Jeżeli po wymianie planu strumień nadal istnieje, w formatach prezentacyjnych xqry zgłasza odmowę polecenia show i zapisuje w dzienniku klienta powód, np. plan epoch ended while subscribing to stream 'dst'; repeat the command. W formatach prezentacyjnych wynik to clientQueueMissing, a kod zakończenia odpowiada ENOSR (no_stream_resources). W trybie --jsonl klient emituje zdarzenie error z kodem client_queue_missing i powodem w polu message. Jeśli strumień zniknął z nowego planu, pierwszeństwo ma diagnostyka braku strumienia.
Klient nie ponawia subskrypcji automatycznie. Po zakończeniu wymiany planu należy ponownie wywołać xqry --select strumień, sprawdzając, czy nazwa i schemat strumienia w nowym planie odpowiadają oczekiwaniom.
Odmowę na granicy epok i poprawne działanie ponowionej subskrypcji sprawdza test integracyjny it_subscribe_epoch_race-run.
Błąd odbioru lub renderowania
Wyjątek w pętli odbioru i renderowania danych w formatach prezentacyjnych kończy subskrypcję błędem klienta, także wtedy, gdy część rekordów została już wypisana. Klient zatrzymuje odbiór, czeka na zakończenie wątku odbierającego i zwraca wynik renderFailed. Na standardowym wyjściu błędów pojawia się komunikat select loop failed in the client; reason in the client log, a dziennik klienta zawiera nazwę strumienia i przyczynę wyjątku. Kod zakończenia odpowiada EINTR (interrupted). Otrzymane przed błędem rekordy są wynikiem częściowym i nie oznaczają udanego zakończenia subskrypcji.
Diagnostykę i kod zakończenia tej ścieżki sprawdza test integracyjny it_select_loop_failure-run.
Formaty prezentacyjne
| Opcja | Format |
|---|---|
-r / --raw | Domyślny tekst bez dekoracji. |
-g / --graphite | Wiersze zgodne z Graphite. |
-f / --influxdb | Line protocol InfluxDB. |
-p / --gnuplot x,y | Dane i polecenia do bezpośredniego zasilenia gnuplot. |
-z / --gnuplot-rtl | Modyfikator gnuplot umieszczający najnowsze próbki po prawej. |
-o / --gnuplot-ohlc | Modyfikator gnuplot rysujący wykres świecowy: rekord to otwarcie, maksimum, minimum, zamknięcie i dalej próbki tej świecy. |
Można wybrać tylko jeden format. --gnuplot-rtl i -o / --gnuplot-ohlc wymagają --gnuplot i można je łączyć. W trybie --gnuplot-ohlc pierwszy parametr -p liczy próbki, a nie świece; układ rekordu i reguły rysowania opisuje przykład Wykres świecowy (OHLC). Surowy format przesyła wszystkie elementy pól tablicowych; mapa NULL jest zachowywana per element.
W wyjściu OHLC rekordy bez poprawnych wartości świecy nie tworzą świec, ale nadal mogą tworzyć linię próbek. Gdy w całym aktualnym oknie nie ma poprawnych świec, xqry wysyła tylko serię próbek; gdy nie ma poprawnych próbek, tylko serię świec. Okno bez żadnego poprawnego punktu nie wysyła pustego polecenia plot do gnuplota.
Polecenia ad hoc
--adhoc dołącza dokładnie jedno SELECT, DECLARE albo RULE do aktywnego planu:
xqry --server pomiary --adhoc \
"SELECT AVG(value : 10) STREAM avg10 FROM sensor"
Dyrektywy kompilatora i kilka poleceń w jednym żądaniu są odrzucane. Szczegóły początku logicznego, deklaracji źródeł, reguł i roszczeń zasobów opisano w rozdziale Zapytania Ad hoc.
Wymiana całego planu: --reset
--reset plik.rql przesyła zawartość pliku i zastępuje cały plan wybranej instancji. To inna operacja niż ad hoc: pełny zestaw może zawierać wiele poleceń, reguły i dyrektywy :STORAGE, :SUBSTRAT oraz :ROTATION.
xqry --server service --reset plan.rql
Serwer przed zmianą aktywnego modelu parsuje i kompiluje zestaw, sprawdza zachowane pliki .desc (dla źródeł DECLARE zawsze, dla wyników SELECT i substratów przy :ROTATION), istnienie, rodzaj i prawo odczytu źródeł DECLARE, zgodność zachowanych magazynów, możliwość otwarcia plików wyjściowych na dysku oraz rezerwuje jego nazwy strumieni, pliki magazynu i licznik rotacji. Kontrola plików nie tworzy ich podczas walidacji; odmowa, np. descriptor parse failed ze ścieżką i miejscem błędu albo cannot open output file, nie zatrzymuje starego planu ani nie zmienia pliku startowego usługi. Przyjęty plan jest aktywowany na końcu bieżącego slotu, serwer próbuje zakończyć stare subskrypcje znacznikiem końca na zasadach opisanych w sekcji odbioru danych, a artefakty poprzedniej epoki są sprzątane zgodnie z zasadami startu i rotacji. Pusty plik przełącza serwer w stan bezczynny.
Kontrola plików jest wstępna: między odpowiedzią OK na --reset a rzeczywistym otwarciem magazynu ścieżka może się zmienić. Późny błąd otwarcia podczas wymiany planu nie jest obecnie odsyłany klientowi jako odmowa i może zatrzymać serwer; odpowiedź OK nie gwarantuje powodzenia tej późniejszej operacji.
Jeżeli celem jest instancja usługowa, serwer próbuje także zapisać zaakceptowaną treść do jej pliku startowego. Niepowodzenie zapisu jest logowane i nie zatrzymuje nowego planu, lecz po restarcie usługa może wrócić do poprzedniej treści. Odpowiedź OK nie gwarantuje trwałości planu; szczegóły opisuje kontrakt usługi i wymiany planu.
Reguła DO SYSTEM nie przechodzi tym kanałem
Plan zawierający regułę DO SYSTEM jest odrzucany w całości, z podaniem nazwy reguły i powodu:
$ xqry --reset z-regula-systemowa.rql --server service
xqry: plan reload refused at reset-commit: Rejected: rule 'evil' on stream 'alpha' uses DO SYSTEM; ...
Powód jest ten sam, dla którego odmawia kanał ad hoc: DO SYSTEM wykonuje dowolne polecenie powłoki na koncie instancji, a kanał IPC nie niesie autorstwa, więc nadawcy resetu nie czyni operatorem usługi. Regułę taką wolno zamówić wyłącznie w pliku planu, z którego instancja startuje. Odmowa obejmuje cały zestaw, a nie samą regułę, ponieważ przyjęty tekst jest zapisywany do pliku startowego usługi, którego start już żadnego sprawdzenia nie przechodzi - reguła wycięta w locie wróciłaby uzbrojona po najbliższym restarcie.
Operator, który świadomie oddaje ten kanał, ustawia service.unrestricted = true w konfiguracji TOML (→ xretractor). Instancja zostawia wtedy ostrzeżenie w dzienniku przy każdym starcie, a kanał ad hoc pozostaje zamknięty niezależnie od tej wartości.
JSON Lines dla aplikacji
--jsonl udostępnia wersjonowane wyjście maszynowe dla --hello, --dir, --detail i --select. Wymaga jednoznacznego serwera; aplikacje powinny zawsze podawać go jawnie.
xqry --server laboratory --jsonl --hello
xqry --server laboratory --jsonl --dir
xqry --server laboratory --jsonl --detail temperature
xqry --server laboratory --jsonl --select temperature --elimitqry 10
Każdy wiersz stdout jest kompletnym obiektem JSON z version: 1 i polem event. Obsługiwane zdarzenia to pong, streams, schema, record, end i error. Diagnostyka trafia na stderr. --idle-timeout N podaje w milisekundach dopuszczalny czas bez rekordu dla subskrypcji; zero wyłącza limit.
Polecenia modyfikujące, --bus, YAML, pozostałe formaty wyjścia, --null i --wait-server nie łączą się z JSONL. Pełny kontrakt oraz gotowe klienty Python i C++ opisuje API monitorowania strumieni.
Jedno polecenie naraz
--select, --detail, --adhoc, --reset, --dir, --vars, --bus i --hello są różnymi poleceniami; podanie kilku naraz kończy się kodem 22. --kill może być świadomie połączone z --select -m N albo z --adhoc, aby zatrzymać serwer po wykonaniu operacji.
Czekanie na serwer
--wait-server odpytuje dostępność IPC zgodnie z timing.server_startup_wait_s i timing.server_startup_poll_ms. Przy jawnej nazwie czeka na nią. Bez nazwy ponawia routing: historycznie czeka na instancję bezimienną, a po pojawieniu się jednej nazwanej instancji wybiera ją automatycznie. Niejednoznaczność przy wielu serwerach jest zgłaszana od razu. --bus nie wymaga serwera i ignoruje czekanie.
Gotowość wymaga otwieralnych obiektów IPC i żywej instancji w magistrali. Gdy magistrala jest niedostępna, sprawdzana jest utrzymywana blokada tożsamości IPC. Same obiekty pozostawione po awarii nie oznaczają gotowego serwera.
Typowy wzorzec testowy:
xretractor query.rql --name test --llimitqry 100 --noanykey --xqrywait &
xqry --server test --wait-server --select strumien --elimitqry 10
Informacje o wersji
Informacje pod listą pomocy zawierają nazwę odnogi, skrót commita, wersję kompilatora, czas i typ budowania oraz ścieżkę dziennika. Opis formatu znajduje się w rozdziale xretractor - Informacje o wersji.
xtrdb
Program xtrdb to interaktywne narzędzie do analizy artefaktów i substratów zapisanych przez system RetractorDB. Pracuje głównie w trybie interaktywnym (REPL), ale udostępnia także kilka opcji uruchomienia (np. --help, --noprompt, --storagemap).
⚠️ Ostrzeżenie
Tryb interaktywny i wsadowy
xtrdbodmawiają pracy, gdy w katalogu blokad działa dowolna instancjaxretractor, także nazwana. Przed ich użyciem zatrzymaj te instancje lub poczekaj na zakończenie. Narzędzie czyta ten sampaths.lock_dirz konfiguracji TOML co silnik (domyślnie katalog tymczasowy procesu), przegląda rodzinęxretractor_service*.locki sprawdza, czy blokada jest trzymana. Sam porzucony plik blokady nie powoduje odmowy. Drugim dowodem jest magistrala bieżącej przestrzeniRDB_NAMESPACE: żywy slot instancji powoduje odmowę także wtedy, gdy jej plik blokady usunęło czyszczenie katalogu tymczasowego według wieku, gdy w jego miejscu leży nowy, nietrzymany plik albo gdy serwer pracuje w innymPrivateTmp(#573). Instancję z innej przestrzeniRDB_NAMESPACErozpoznaje tylko plik blokady; tak samo przy braku segmentu magistrali lub gdy nie da się go podłączyć. Przy niestandardowym katalogu uruchomxtrdbz tą samą konfiguracją co serwer. Opcje--helpi--storagemapkończą działanie przed tą kontrolą;--storagemaptylko odczytuje stan składowania.
Kontrola plików blokad otwiera je bez podążania za dowiązaniami i w trybie nieblokującym. Pomija zniknięte wpisy, dowiązania i obiekty niebędące zwykłymi plikami, w tym FIFO; sama obecność takiego wpisu nie potwierdza pracy silnika. Inny błąd otwarcia, np. brak prawa odczytu zwykłego pliku, powoduje odmowę z kodem 1 i komunikatem cannot verify whether xretractor is running. Narzędzie nie uznaje wtedy, że katalog jest wolny, i nie rozpoczyna edycji magazynu. Niezależna kontrola magistrali nadal obowiązuje.
Uruchomienie
$ xtrdb # tryb interaktywny (z promptem)
$ xtrdb -n # tryb wsadowy (bez promptu i bez "ok")
$ xtrdb --noprompt # to samo co -n
$ xtrdb noprompt # zgodność wsteczna (legacy, argument pozycyjny)
$ xtrdb -s plik_danych # pokaż strukturę storage dla wskazanego pliku
$ xtrdb --storagemap plik # to samo co -s
$ xtrdb -h # help i informacje o buildzie, potem zakończ
Tryb -n/--noprompt usuwa kolorowanie, prompt . i komunikat ok - przydatny, gdy wejście pochodzi z pliku lub potoku. Wciąż działa też historyczny wariant pozycyjny noprompt.
$ xtrdb -n < script.xtrdb
Opcja -s/--storagemap uruchamia tylko raport struktury pliku danych i kończy działanie programu (bez wejścia do REPL).
Po uruchomieniu narzędzie wypisuje prompt . i czeka na polecenie. Każde polecenie kończy się naciśnięciem Enter.
Przegląd poleceń
Polecenie help lub h wyświetla listę dostępnych poleceń:
$ xtrdb
.help
exit|quit|q exit
quitdrop|qd exit & drop artifacts (data, .desc, .meta)
open file [schema] open or create database with schema
example: .open test_db { INTEGER dane
STRING name[3] }
storage [path] set storage path for database
policy [name] set storage policy
dropfile [file1] [file2] ... } remove listed file(s), end with }
desc|descc show schema
read|rread [n] read record from database into payload
write [n] from payload send record to database
purge remove all records from database
append append payload to database
set [field][value] set payload field value
setpos [position][number value] set payload field number value
getpos [position] show payload field value
status show current payload status
rox remove on exit flip (data, .desc, .meta)
print|printt show payload
list|rlist [count] print first records
input [[field][value]] fill payload
hex|dec type of input/output of byte/number fields
size show database size in records
cap [value] set device stream backread capacity
dump show payload memory
meta show meta index (null patterns) for open db
metaraw show internal meta file structure
echo print message on terminal
system execute system command
#|rem [text] comment line
help|h show this help
Zarządzanie sesją
| Polecenie | Opis |
|---|---|
exit, quit, q | Zakończ narzędzie. Zapisane rekordy pozostają na dysku, o ile nie włączono usuwania przez rox; zmiany wyłącznie w buforze payload nie są automatycznie zapisywane. |
quitdrop, qd | Zakończ i usuń otwarte pliki artefaktu (dane, .desc, .meta). Plik danych wskazany przez REF z .desc poza katalogiem magazynu i storage.ref_dirs zostaje - usuwany jest tylko .desc. |
Konfiguracja środowiska
| Polecenie | Opis |
|---|---|
storage [ścieżka] | Ustaw katalog roboczy. Kolejne polecenie open szuka pliku w tej ścieżce. |
policy [nazwa] | Ustaw politykę przechowywania (DEFAULT, DIRECT, POSIX, MEMORY, …). Musi poprzedzać open. |
Konfiguracja TOML jest wczytywana ze standardowych lokalizacji: /etc/retractor/retractor.toml, następnie $XDG_CONFIG_HOME/retractor/retractor.toml lub ~/.config/retractor/retractor.toml. xtrdb nie ma opcji --config; przy niestandardowym katalogu blokad lub ustawieniu storage.ref_dirs należy umieścić te klucze w jednej z tych warstw.
Otwieranie artefaktu
open nazwa_pliku
open nazwa_pliku { TYP pole TYP pole ... }
Jeśli plik .desc istnieje - schemat jest z niego odczytany. Jeśli nie istnieje - schemat należy podać w nawiasach {}.
Jeśli otwarcie pliku danych nie powiedzie się, open wypisuje przyczynę (np. cannot open output file) i pozostawia magazyn nieotwarty, zamiast kończyć proces. Gdy próba utworzyła nowy .desc, a otwarcie danych zawiodło, plik deskryptora jest usuwany. Po usunięciu przyczyny można ponowić open.
Pole REF w istniejącym .desc wskazuje plik danych i może prowadzić poza katalog ustawiony poleceniem storage - tak silnik opisuje zewnętrzne źródła BINFILE, TEXTFILE i DEVICE, które xtrdb czyta bez ograniczeń. Magazynu zapisywalnego (DEFAULT, DIRECT, POSIX i pozostałe) z REF poza tym katalogiem open nie otwiera: kończy się odmową z nazwą .desc i pliku, zanim plik zostanie utworzony. Taki zapis dopuszcza klucz storage.ref_dirs konfiguracji TOML - lista bezwzględnych ścieżek katalogów, w których REF z .desc może umieścić plik danych (patrz opcje xretractor). Niepoprawny wpis tej listy zatrzymuje start xtrdb błędem Configuration error: storage.ref_dirs …. REF podany w schemacie open nazwa { … } jest decyzją operatora i nie podlega temu ograniczeniu.
Tablicowe typy pól: STRING name[8] oznacza pole tekstowe o długości 8 bajtów (array multiplicity = 8).
Przykłady:
.open str1 # schemat z pliku str1.desc
.open dump.tmp { INTEGER wartosc } # schemat podany ręcznie
.open wyniki { INTEGER a FLOAT b STRING name[8] }
Odczyt i zapis rekordów
| Polecenie | Opis |
|---|---|
read N | Odczytaj rekord N (0-based) z pliku do bufora payload. |
rread N | Jak read, ale odczytuje od końca pliku (reverse read). |
write N | Zapisz bieżący payload do rekordu N w pliku. |
append | Dołącz bieżący payload jako nowy rekord na końcu pliku. |
purge | Usuń wszystkie rekordy z pliku (skróć plik do 0 rekordów). |
Indeks poza zakresem magazynu wynikowego, także pustego, jest odrzucany przed odczytem: read i rread wypisują record out of range - read command, pozostawiając payload i jego poprzedni stan bez zmian. list i rlist wypisują record out of range - list command i przechodzą do następnego indeksu. Jeżeli sprawdzenie zakresu przepuści żądanie, ale sam odczyt zwróci brak rekordu lub błąd, stan payloadu zmienia się na error; list i rlist wypisują wtedy fetch error. Dla źródeł deklarowanych read i rread pomijają wstępną kontrolę zakresu i korzystają z wyniku odczytu źródła. Stan można sprawdzić poleceniem status.
Udane write N lub append ustawia stan payloadu na stored. Próba append do zadeklarowanego źródła BINFILE, TEXTFILE albo DEVICE, które obsługuje tylko odczyt, ustawia stan error: dane źródła i liczba jego rekordów pozostają bez zmian, a xtrdb nadal przyjmuje polecenia. Stan payloadu raportowany przez status jest oddzielny od kodu zakończenia procesu; taka odmowa nie wymusza zakończenia z błędem.
Błędy zapisu zwracane przez warstwę magazynu, w tym błędy wejścia/wyjścia, również ustawiają stan error: write wypisuje write: ..., a append - append: ...; terminal nadal przyjmuje kolejne polecenia. Skrypt wsadowy powinien sprawdzać diagnostykę i stan payloadu, ponieważ kod zakończenia procesu 0 nie potwierdza powodzenia każdej komendy.
Kontrakt stanu zapisu i odmowy dopisania sprawdza test integracyjny it_xtrdb_write_status-run.
Przeglądanie zawartości
| Polecenie | Opis |
|---|---|
list N | Wypisz N pierwszych rekordów (od początku), jeden wiersz = jeden rekord. |
rlist N | Jak list, ale odczytuje od końca pliku. |
print | Wypisz bieżący payload w formacie wieloliniowym. |
printt | Wypisz bieżący payload w jednym wierszu. |
size | Wypisz liczbę rekordów i rozmiar jednego rekordu w bajtach. |
dump | Wypisz surowe bajty bieżącego payload w formacie hex. |
desc | Wypisz schemat pól otwartego artefaktu (wieloliniowy). |
descc | Wypisz schemat w jednym wierszu (compact). |
Edycja payload
| Polecenie | Opis |
|---|---|
set pole wartość | Ustaw pole o podanej nazwie w buforze payload. |
setpos N wartość | Ustaw pole o indeksie N (0-based) w buforze payload. |
getpos N | Wypisz wartość pola o indeksie N z bieżącego payload. |
input | Interaktywne wypełnienie payload - wpisz wartości po kolei dla każdego pola. |
status | Wypisz stan payload: clean, fetched, changed, stored, error. |
hex / dec | Przełącz format wejścia/wyjścia pól liczbowych między szesnastkowym a dziesiętnym. |
Metadane null (.meta)
| Polecenie | Opis |
|---|---|
meta | Wypisz indeks null i przerw w transmisji z pliku .meta - opisowo (segmenty z liczbą rekordów i wzorcem null). |
metaraw | Wypisz surową strukturę binarną pliku .meta - każdy wpis RLE z polami count, gap, bitsetHex. |
meta wyświetli segmenty z informacją o brakach (null) i przerwach w transmisji (gap). metaraw pokaże surową strukturę binarną pliku .meta.
Pozostałe polecenia
| Polecenie | Opis |
|---|---|
rox | Przełącz flagę „remove on exit“ - po zakończeniu narzędzia usuwa dane, .desc, .meta; plik danych spoza katalogu magazynu i storage.ref_dirs zostaje jak przy quitdrop. |
cap N | Ustaw pojemność bufora cofania (backread) dla urządzeń strumiennych. |
dropfile f1 f2 … } | Usuń wymienione pliki. Lista kończy się tokenem }. |
echo tekst | Wypisz tekst na terminal (przydatne w skryptach). |
system polecenie | Wywołaj polecenie powłoki. |
# lub rem | Linia komentarza (ignorowana). # nie wypisuje nawet promptu. |
Przykłady użycia
Podgląd artefaktu
$ xtrdb
.storage temp
.open str1
.size
.list 10
.quit
Odczyt pliku DUMP bez deskryptora
Pliki zrzutu tworzone przez DO DUMP nie mają pliku .desc - schemat należy podać ręcznie:
$ xtrdb
.open wyniki_alarm_dump.tmp { INTEGER wartosc }
.size
.list 6
.quit
Zrzut nie ma też pliku .meta, więc polecenia meta i metaraw nie mają w nim czego pokazać. Znaczy to, że wypisane wartości są wszystkim, co plik niesie: zero w zrzucie może być prawdziwym zerem, polem NULL albo rekordem, którego silnik nie miał, a przerwa w transmisji nie ma tam żadnego znacznika. Kontrakt zrzutu opisuje Realizacja alarmowania.
Skrypt wsadowy
xtrdb noprompt << 'EOF'
storage /var/retractor
open sensor_dump.tmp { INTEGER a FLOAT b }
list 20
quit
EOF
Inspekcja metadanych null
.open str1
.meta
.metaraw
Geneza systemu
Ponad dwadzieścia lat temu pracowałem w pewnym instytucie naukowym w Zabrzu. Zajmowałem się m.in. budową systemu nadzoru neonatologicznego. Stosunkowo niedawno ukończyłem studia, moja głowa nadal była wypełniona teorią dotyczącą budowy systemów opartych na centralnej bazie danych. Budując system monitorowania stwierdziłem – zrobię go tak jak sztuka każe – oparty na relacyjnej bazie danych. To nie był dobry pomysł. Trafiłem na problem ogólnej wydajności takiego rozwiązania. Rejestrowane sygnały cechowały się wysoką granulacją. Dodatkowo, dostępne systemy baz danych nie były przygotowane na ciągły i nieskończony napływ danych.
Rok 2003 był czasem, w którym bardzo obiecująco prezentowały się w literaturze naukowej tzw. bazy strumieniowe. Po analizie stwierdziłem, że to chyba najbliższa dziedzina w tym czasie, która odpowiada temu, czego potrzebuję. Przyjąłem założenie, że tworzę strumieniową bazę danych do przetwarzania sygnałów. Decyzja z czasem okazała się nie do końca zgodna z prawdą. Systemy strumieniowe przyszły i poszły – ale potrzeba systemów przetwarzających szeregi czasowe pozostała. Systemy strumieniowe przeobraziły się w systemy przetwarzające serie czasowe – Time Series Databases. Do dnia dzisiejszego systemy baz danych przetwarzające serie czasowe znajdują zastosowanie w systemach monitorowania.
Opracowany system nadzoru neonatologicznego obsługiwał kilkanaście pulsoksymetrów. Na sali nadzoru leżało kilkanaście noworodków wymagających ciągłego nadzoru. Każdy noworodek podłączony był m.in. do pulsoksymetru. Każdy pulsoksymetr monitorował rytm serca oraz zawartość tlenu we krwi noworodka. Noworodki się wierciły, sondy odpadały, pulsoksymetry podnosiły alarm co chwilę raportując różnego typu problemy. W takim szumie informacyjnym jeden z noworodków mógł się dusić. Nie działo się to nagle – ale powoli, można było to rozpoznać w szerszym horyzoncie czasowym. Ten jeden przypadek wymagał jednak natychmiastowej reakcji. Równocześnie i do tego bardzo głośno sygnalizowało dźwiękiem kilka urządzeń - a ten jeden z noworodków, ten, który potrzebował pomocy, łapał powietrze cichutko w rogu sali. Tak mniej więcej można opisać skalę problemu. Budowany system umożliwiał jednym rzutem oka stwierdzić, czy wycie urządzenia na sali nadzoru to efekt zsunięcia się czujnika, chwilowy problem czy może coś poważniejszego. Zmieniając skalę czasową można było od razu zidentyfikować problem. Szybka ocena zagrożenia w oparciu o wskazania systemu monitorującego w takim przypadku ratuje zdrowie i życie.
System monitorowania powstał i został wdrożony u klienta w jednym z Warszawskich szpitali. Byłem na miejscu i widziałem, jak działa. Niestety wewnątrz nie było systemu zarządzania danymi, który opisywałem w publikacjach naukowych. Rozwiązanie opracowałem ręcznie bez implementacji języka zapytań, algorytmów i mechanizmów zarządzania. Termin i ograniczone zasoby wymagały dowiezienia tematu na czas. Publikacje, które wtedy powstały opisywały szlachetne potrzeby i założenia – jednak praktyka była inna. Trzeba było dostarczyć produkt a czasu nie było.
Tak przedstawia się w ogólnym zarysie generyczna przyczyna, z której wynikła potrzeba stworzenia systemu zarządzania danymi dla potrzeb przetwarzania sygnałów. Z czasem doszły kolejne obszary zastosowań wynikające z rozszerzających się obszarów rozwojowych związanych z telemetrią, monitorowaniem oraz rozbudową systemów IoT.
W skrócie
-
Początek XXI wieku - Zabrze
System nadzoru neonatologicznego oparty na relacyjnej bazie danych. Sygnały o wysokiej granulacji i ciągły napływ danych ujawniają ograniczenia wydajności.
-
2003 - bazy strumieniowe
Strumieniowe bazy danych jako najbliższa dziedzina. Założenie: strumieniowa baza danych do przetwarzania sygnałów.
-
Wdrożenie - szpital w Warszawie
System monitorowania działa u klienta, ale bez języka zapytań i mechanizmów zarządzania danymi opisywanych w publikacjach - termin wymusił rozwiązanie ręczne.
-
2019 - repozytorium RetractorDB
Pierwszy commit repozytorium (grudzień 2019): początek implementacji systemu zarządzania danymi dla przetwarzania sygnałów.
-
Dziś - telemetria, monitorowanie, IoT
Systemy strumieniowe przeobraziły się w bazy serii czasowych, a obszar zastosowań rozszerzył się na telemetrię i systemy IoT.
Dlaczego wybrano taką nazwę dla systemu?
Retraktory w medycynie to cała grupa narzędzi chirurgicznych. Retraktory, znane są również jako haki chirurgiczne lub rozwieraki. Są to narzędzia umożliwiające odsuwanie lub łącznie ze sobą struktur anatomicznych (np. ran, mięśni, kości, itd…). Znajdują zastosowanie z reguły podczas operacji lub innego zabiegu. Niektóre, te bardziej pomysłowe noszą nazwy swoich twórców.
Na zasadzie analogii postanowiłem że nazwę swoje narzędzie retraktorem. RetractorDB ma za zadanie rozdzielać, łączyć oraz umożliwiać realizację obliczeń na seriach czasowych w czasie rzeczywistym, w biegu operując na danych efemerycznych, artefaktach lub substratach (patrz podrozdział pt. Artefakty, Substraty, Efemerydy).
ℹ️ Info
Definicja (Retrakcja i Retraktor danych): Zastosowanie aparatu numerycznego do wydobycia, przetworzenia a następnie zwrócenia danych zawartych w seriach czasowych lub sygnałach cyfrowych nazywamy retrakcją danych. Narzędzie służące do realizacji tego procesu nazywamy Retraktorem danych.
Kolorowanie składni RQL
Pliki zapytań RetractorDB mają rozszerzenie .rql. Repozytorium dostarcza gotowe definicje kolorowania składni dla trzech środowisk: Visual Studio Code, Vim oraz narzędzia bat/batcat. Wszystkie potrzebne pliki znajdują się w katalogu scripts/ projektu.
Visual Studio Code
Rozszerzenie rql-vscode dodaje do VS Code pełną obsługę języka RQL: kolorowanie składni, rozpoznawanie rozszerzenia .rql oraz ikonę pliku.
Instalacja z repozytorium GitHub:
git clone https://github.com/michalwidera/rql-vscode.git
cd rql-vscode
npm install
npm run compile
code --install-extension *.vsix
Jeżeli repozytorium zawiera gotowy plik .vsix, można pominąć kompilację i zainstalować go bezpośrednio:
code --install-extension rql-vscode-*.vsix
Po instalacji VS Code automatycznie rozpozna pliki .rql i zastosuje kolorowanie składni. Brak konieczności modyfikacji ustawień użytkownika.
Przykład podświetlonego zapytania w VS Code:
STORAGE 'temp'
DECLARE a INTEGER STREAM core0, 0.1 DEVICE '/dev/urandom'
# Wybierz kolumnę i jej połowę
SELECT core0[0], core0[0] / 2 STREAM str1 FROM core0
Rys. 64. Podświetlenie składni RQL w edytorze Visual Studio Code
Jak widać na Rys. 64, słowa kluczowe (STORAGE, DECLARE, SELECT, FROM) są podświetlane jako komendy, a typy danych (INTEGER) jako typy. W aktualnym RQL # rozpoczyna komentarz tylko jako pierwszy niebiały znak całego wiersza; wewnątrz klauzuli FROM zawsze jest operatorem przeplotu. Komentarz kończący wiersz zaczyna się od //, a komentarz blokowy ma postać /* ... */. Definicja kolorowania powinna zachowywać to rozróżnienie.
Vim
Repozytorium zawiera dwa pliki Vima w katalogu scripts/.vim/:
| Plik | Opis |
|---|---|
scripts/.vim/syntax/rql.vim | Definicja grup składniowych i ich przypisań kolorystycznych |
scripts/.vim/ftdetect/rql.vim | Automatyczne wykrywanie typu pliku po rozszerzeniu .rql |
Instalacja przez buildrdb.sh
Najwygodniejsza metoda - skrypt kopiuje oba pliki do odpowiednich podkatalogów ~/.vim/:
scripts/buildrdb.sh vimsyntax
Skrypt tworzy brakujące katalogi i informuje o lokalizacji docelowej:
-- RetractorQL vim syntax installed to /home/user/.vim
Instalacja przez CMake
Cel vimconf z scripts/CMakeLists.txt kopiuje cały katalog .vim do katalogu domowego:
cmake --build build --target vimconf
Instalacja ręczna
mkdir -p ~/.vim/syntax ~/.vim/ftdetect
cp scripts/.vim/syntax/rql.vim ~/.vim/syntax/
cp scripts/.vim/ftdetect/rql.vim ~/.vim/ftdetect/
Po instalacji Vim automatycznie aktywuje kolorowanie dla każdego pliku z rozszerzeniem .rql. Plik ftdetect/rql.vim zawiera jedną linię:
au BufRead,BufNewFile *.rql set filetype=rql
Podświetlane elementy
| Grupa Vima | Przykłady |
|---|---|
Keyword | SELECT, DECLARE, STREAM, FROM, BINFILE, TEXTFILE, DEVICE, FILE, RULE, ON, WHEN, DO |
PreProc | STORAGE, ROTATION, SUBSTRAT |
Operator | AND, OR, NOT |
Constant | MEMORY, POSIX, DIRECT, GENERIC |
Type | INTEGER, FLOAT, BYTE, CHAR, UINT, STRING, DOUBLE |
Function | MIN, MAX, AVG, SUMC, Sqrt, Abs, Length, null2zero |
Comment | # komentarz, // komentarz, /* blok */ |
String | 'ścieżka/do/pliku.dat' |
Number | 42, 3.14, 1/2, 1e5 |
Przykład pliku zapytania z zaznaczonymi fragmentami:
DECLARE a UINT STREAM core0, 1 TEXTFILE 'datafile1.txt'
DECLARE a UINT STREAM core1, 2 TEXTFILE 'datafile2.txt' ONESHOT
SELECT str4[0] STREAM str4 FROM core0#core1
RULE regulation1 \
ON str4 \
WHEN str4[0] = 20 OR str4[0] = 23 \
DO SYSTEM 'echo "test"'
Widok tekstu w edytorze vim przedstawia Rys. 65.
Rys. 65. Podświetlenie składni RQL w edytorze vim
bat / batcat
Narzędzie bat (na niektórych dystrybucjach dostępne jako batcat) to ulepszony zamiennik cat z wbudowaną obsługą podświetlania składni. Obsługuje definicje syntaktyczne w formacie Sublime Text 3, które repozytorium RetractorDB dostarcza pod ścieżką scripts/sublime/retractorql.sublime-syntax.
Wymaganie wstępne
Upewnij się, że bat jest zainstalowany:
# Debian/Ubuntu
sudo apt-get install bat
# Sprawdzenie polecenia (może być bat lub batcat zależnie od dystrybucji)
command -v batcat || command -v bat
Instalacja przez buildrdb.sh
scripts/buildrdb.sh batsyntax
Skrypt samodzielnie wykrywa polecenie (bat lub batcat), kopiuje plik składni do właściwego katalogu konfiguracyjnego i przebudowuje pamięć podręczną syntaktyk:
-- RetractorQL syntax installed to /home/user/.config/bat/syntaxes
Instalacja ręczna
# Wykryj nazwę polecenia
BAT=$(command -v batcat || command -v bat)
# Utwórz katalog na definicje syntaktyk
mkdir -p "$($BAT --config-dir)/syntaxes"
# Skopiuj definicję
cp scripts/sublime/retractorql.sublime-syntax "$($BAT --config-dir)/syntaxes/"
# Przebuduj pamięć podręczną
$BAT cache --build
Użycie
Po instalacji bat automatycznie koloruje pliki .rql:
bat query.rql
Rozpoznawane jest też rozszerzenie .desc (pliki deskryptorów strumieni). Można wymusić podświetlanie ręcznie, jeśli plik ma inne rozszerzenie:
bat --language rql dowolny-plik.txt
Weryfikacja instalacji - dostępne języki:
bat --list-languages | grep -i rql
# RetractorQL:rql,desc
Przykład wywołania
Dla pliku query.rql zawierającego:
STORAGE 'temp'
DECLARE a INTEGER STREAM core0, 0.1 BINFILE 'datafile2.dat'
SELECT str1[0] STREAM str1 FROM core0
RULE testrule1 ON str1 WHEN str1[0] < 15 DO DUMP -5 TO 5
RULE testrule2 ON str1 WHEN str1[0] > 11 DO DUMP -5 TO 5 RETENTION 100
RULE testrule3 \
ON str1 \
WHEN str1[0] = 13 OR str1[0] = 11 \
DO SYSTEM 'echo "systemcall"'
Wywołanie bat query.rql wyświetli zawartość pliku z numeracją linii i podświetleniem składni w terminalu, gdzie słowa kluczowe, typy, komentarze i literały łańcuchowe będą miały odrębne kolory zgodne z aktywnym motywem bat (Rys. 66).
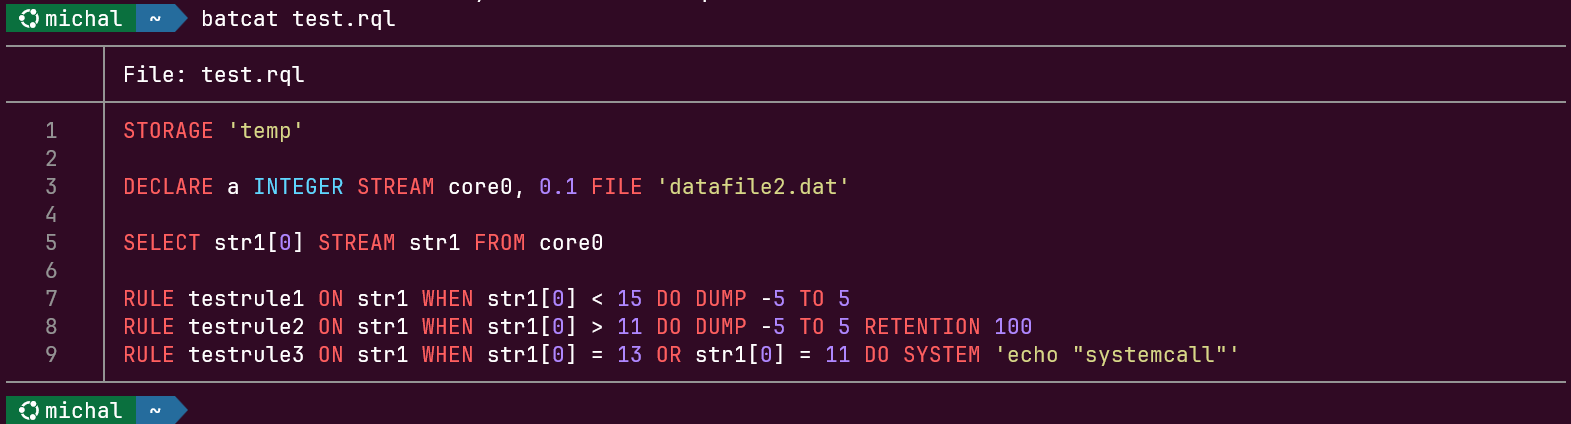
Rys. 66. Podświetlenie składni RQL w terminalu - polecenie batcat
Testy integracyjne
Testy integracyjne weryfikują zachowanie systemu jako całości - uruchamiają rzeczywiste binaria (xretractor, xqry, xtrdb) i porównują ich wyjście z wzorcami lub sprawdzają konkretne właściwości plików wynikowych. Testy jednostkowe używają frameworka GTest do sprawdzania klas i funkcji bibliotek rdb i retractor (np. payload, descriptor, crsMath, compiler). Zależnie od badanego kontraktu również tworzą pliki, procesy potomne i obiekty IPC; sam podział na testy jednostkowe i integracyjne nie wyznacza zakresu używanych zasobów.
Przy budowaniu GCC w konfiguracji Release z aktywnym IPO (RDB_USE_IPO=ON, RDB_BENCH_PROBE=OFF i pozytywny wynik kontroli obsługi IPO) biblioteki zawierają zarówno kod maszynowy, jak i reprezentację do LTO (-ffat-lto-objects). Testy jednostkowe są linkowane z -fno-lto i wykonują zwykły kod maszynowy tych bibliotek; nie sprawdzają wyniku optymalizacji podczas linkowania. Wydawane programy zachowują LTO, więc kod po tej optymalizacji jest sprawdzany przez testy integracyjne uruchamiające te programy. Rozdzielenie ustalają główny CMakeLists.txt i test/UnitTest/CMakeLists.txt przez RDB_UT_WITHOUT_IPO. Nie zmienia ono konfiguracji Debug, a dla kompilatorów innych niż GCC pozostaje dotychczasowe ustawienie IPO testów jednostkowych.
W katalogu build/Debug/ polecenie ninja test uruchamia zwykły zestaw bez etykiety valgrind, a przy domyślnym RDB_WITH_API=OFF także bez api. Samo ctest wybiera wszystkie zarejestrowane grupy, w tym Valgrind i API. ninja test-valgrind wybiera etykietę valgrind, a ninja test-api buduje i uruchamia klientów monitorujących. Pojedynczy test można wybrać przez ctest -R '^nazwa$' -V; CTest dobiera także wymagane oprawy (FIXTURES_REQUIRED). Przed przebiegiem należy odbudować badane cele, sprawdzić katalog źródłowy zapisany w CMakeCache.txt, komendę z ctest -N -V i efektywny PATH. Wybrane programy oraz kopie skryptów i danych w drzewie budowy muszą być zgodne bajtowo z właśnie zbudowanymi celami i bieżącymi źródłami. Szczegóły zawiera test/CLAUDE.md w repozytorium kodu.
Wszystkie scenariusze znajdują się w jednym katalogu test/IntegrationTest. CMake przydziela większości katalogów jedną z szesnastu przestrzeni RDB_NAMESPACE oraz odpowiadającą jej blokadę zasobu. Rozdziela to magistralę, nazwę instancji, obiekty IPC i plik dziennika bez zmiany zapytań ani wzorców. Testy jednego katalogu pozostają wzajemnie wykluczone, ale różne katalogi mogą uruchamiać serwery równolegle. RUN_SERIAL zachowują scenariusze badające produkcyjną tożsamość globalną, współpracę wielu serwerów oraz sprzątanie pozostałości (leftover_sweep), które mogłoby zostać wykonane przez równoległą instancję przed sprawdzeniem asercji.
Blokada RESOURCE_LOCK wyklucza także katalogi, które otrzymały ten sam slot puli; nie ustala jednak kolejności wykonania. Testy jednostkowe mają oddzielne oprawy przygotowania dla zwykłego przebiegu i Valgrinda. Przy pełnym ctest przygotowanie wariantu Valgrinda czeka na zwykły test, aby nie skasować jego metadanych. Przestrzenie nazw pozwalają na równoległość wewnątrz jednego przebiegu CTest; nie izolują dwóch niezależnych przebiegów, które mogą użyć tych samych slotów i instalacji. Na jednej maszynie należy prowadzić tylko jeden przebieg budowania, instalacji lub testów naraz.
Pula ogranicza liczbę przestrzeni, lecz nie rezerwuje pamięci współdzielonej. W obecnym układzie jeden serwer z własną magistralą zajmuje około 5,1 MiB w /dev/shm (magistrala, kolejka poleceń i segment odpowiedzi); 16 takich serwerów może potrzebować około 83 MiB, poza obiektami testów jednostkowych. Kontener z limitem 64 MiB nie mieści pełnej puli. Przy błędach shared memory too small lub No space left on device trzeba zwiększyć dostępną pamięć współdzieloną albo zmniejszyć równoległość; samo rozdzielenie nazw nie rozwiązuje braku pojemności.
Skrypty korzystają z portable.sh, m.in. do pomiaru rozmiaru plików, limitów czasu i odczytu wartości binarnych. file_size zwraca 0 także dla nieistniejącego pliku, więc równość rozmiarów nie dowodzi istnienia ani zgodności danych. Oczekiwane artefakty wymagają kontroli obecności i treści, np. przez cmp lub niezależną wyrocznię. Analogicznie kontrola stanu IPC musi dotyczyć własnej przestrzeni testu: zmiany obiektów sąsiada nie świadczą o braku izolacji. Test Python api/python/tests/test_isolation.py porównuje stan swojej przestrzeni przed kompilacją, po wykonaniu, zamknięciu i wyjściu procesu, także po SIGKILL, przy działającym serwerze referencyjnym.
Poniższe tabele opisują zamiar każdego scenariusza. Nie są inwentarzem wykonywalnym: jeden katalog rejestruje zwykle kilka wpisów ctest (warianty -run, -compile, -vg, warianty nazwane), a lista rośnie z każdym wydaniem. Aktualny stan zwraca ctest -N w katalogu build/Debug.
Po scaleniu drzew wszystkie testy integracyjne mają prefiks it_; dawny prefiks pt_ nie opisuje już osobnej klasy. Testy skryptowe używają st_, a testy klientów monitorujących etykiety api. Osadzany binding Pythona ma osobną etykietę python: przy RDB_PYTHON=ON wpis python_stage odświeża pakiet, a python_binding uruchamia pytest w zwykłym ninja test. Nie należą one do ninja test-valgrind. Dwa strażniki nadrzędne - harness_guard-selftest i harness_command_integrity - sprawdzają, że wrapper rzeczywiście uruchomił polecenie pod testem i nie zamaskował jego kodu wyjścia.
Opisy Valgrinda dotyczą standardowego przebiegu na Linuksie. Rozwojowy port Apple uruchamia testy bez tego opakowania i wymaga osobnego budowania z sanitizerami; nazwa -vg nie potwierdza kontroli pamięci. Zakres testów i jawnego test-api opisuje środowisko rozwojowe Apple. Testy jednostkowe test_busFallback.cpp sprawdzają także utrzymanie zamka przez zatrzymanego żywego właściciela i odzyskanie po jego śmierci.
Scenariusze wykonawcze i usługowe
| Nazwa testu | Opis |
|---|---|
Data | Wspólny zestaw danych i zapytań dla scenariuszy przekrojowych: waterfall (przebieg pełnego planu przez -m 10 i posprzątanie artefaktów), workflow (zapytanie referencyjne, porównanie dwóch strumieni wynikowych) oraz all-operators (ten sam przebieg dla zapytania używającego kompletu operatorów algebry). Patrz: Przetwarzanie i dystrybucja danych. |
ipc_identity_lock | Zajęta tożsamość IPC odrzuca start przed zmianą magazynu; dwa serwery z tą samą jawną nazwą nie mogą przejąć wspólnego IPC mimo różnych TMPDIR i przestrzeni magistrali. Pierwszy serwer nadal odpowiada. Blokadę zajmuje protokołem silnika (stillLinked z ponowieniami), bo gołe open() + flock() przegrywało z zamiatarką sąsiedniego testu. Każda nieudana kontrola zrzuca stan w chwili awarii - zawartość /dev/shm z i-węzłami, blokady z właścicielami z /proc/locks, tablicę procesów i ogon logu silnika - dlatego test biegnie równolegle, bez RUN_SERIAL. |
leftover_sweep | Sprzątanie po zwykłym wyjściu, restarcie po SIGKILL, wyjściu innej instancji i jawnym --cleanup. Sprawdza zachowanie zasobów żywego serwera. Działa szeregowo, aby równoległy proces nie usunął badanych pozostałości. |
agse1 | Operator okna @(krok, szerokość) - krok liczony w płaskich elementach źródła; dodatnia szerokość @(1,4) układa okno od najnowszego elementu, a ujemna @(1,-4) odwraca jego kolejność. Patrz: Ruchome okno danych AGSE. |
agse_array | AGSE nad liczbowym polem tablicowym i równoważnym schematem skalarnym: każdy płaski element musi wejść do okna w tej samej kolejności. Patrz: Operatory agregujące, Przebiegi kompilacji. |
agse_volatile | Okno AGSE nad strumieniem VOLATILE (bufor MEMORY) musi widzieć cały zakres okna. Przy zbyt małej pojemności bufor kołowy nadpisuje najstarsze pole i okno czyta w jego miejsce rekord najnowszy. Patrz: Klauzula VOLATILE, Ruchome okno danych AGSE. |
array_derived | Równoważność liczbowego T[N] i jawnych pól skalarnych przez kopię, przesunięcie, AGSE, redukcję SUMC, przeplot oraz mieszany przeplot; obejmuje też mapowanie NULL. Patrz: Operatory agregujące, Przebiegi kompilacji. |
client_tty_keystroke_immunity | Bajt oczekujący na pseudoterminalu nie może skrócić odbioru xqry --elimitqry N; klient ma odebrać cały budżet rekordów i dopiero potem wykonać połączone --kill. |
config_storage_validation | Twarde odrzucenie niepoprawnego storage.dir w pliku TOML: wariant nonexistent (katalog nie istnieje) i unwritable (brak prawa zapisu). W obu program kończy się kodem niezerowym i komunikatem Configuration error: storage.dir …. Wariant config-errors sprawdza wykrytą warstwę z błędną składnią TOML i ze względnym paths.lock_dir w xretractor, xqry i xtrdb (kod niezerowy, nazwa pliku i przyczyna na stderr), brak pliku jako kontrolę dodatnią, jawne --config oraz działanie --help mimo uszkodzonej konfiguracji. Patrz: Opcje wywołania - xretractor, Plik konfiguracyjny. |
deinterleave_roundtrip | Bitowa weryfikacja tożsamości okrężnej przeplot–rozplot: a2 i b2 odtwarzają składowe dokładnie, od rekordu zerowego, bez rekordu-zastępnika. Wzorce wyprowadzone z definicji formalnych, nie z wyjścia silnika. Patrz: Ogony, początki logiczne i obserwowalność operatorów. |
device_timeout | Odczyt źródła DEVICE bez blokowania, z FIFO jako kontrolowanym źródłem: jawna klauzula TIMEOUT w wydruku -c, ostrzeżenie o terminie dłuższym od szybkości, odmowa TIMEOUT przy przestarzałym FILE i ujemnego [sources] timeout_s; pierwszeństwo terminu (RQL, konfiguracja, 0, tryb -f); te same bajty jako BINFILE i jako DEVICE dają te same wyniki za operatorami wielotaktowymi; FIFO bez pisarza bez zawieszenia, z rekordami NULL; --until-eof kończy się na odejściu pisarza bez rekordu NULL zza końca; xqry odpowiada w trakcie czekania na źródło; TIMEOUT przechodzi przez import ad hoc i --reset. Wariant -vg- pod Valgrindem. Patrz: Polecenie DECLARE. |
ecg_qrs | Pełne wykonanie przykładowego potoku EKG w zwartej postaci: okna bezpośrednio w FROM, rozwinięcie [_] według ich szerokości i reduktory funkcyjne. Test kontroluje origin= i tail= w planie oraz 4830 rekordów deterministycznej treści czterech strumieni pośrednich i końcowych. Patrz: Wizualizacja EKG MIT-BIH, Przetwarzanie symbolu _, Ogony, początki logiczne i obserwowalność operatorów. |
agse2 | Kombinacje okna @(n,m) na strumieniu 3-polowym, wyrównanie i rate-conversion przy proporcjach 1:1, 1:2, 2:3, 2:4. Patrz: Ruchome okno danych AGSE. |
agse3 | Operator @(n,m) gdy output rate jest niższy niż input rate (source rate 0.1) - okna @(3,2), @(3,3), @(3,-3). Patrz: Ruchome okno danych AGSE. |
consistency | Spójność odczytu: dwa strumienie czytają to samo źródło; ich różnica musi być stale równa 100. Patrz: Przepływ danych i sterowania. |
fatal_exit_path | Błąd krytyczny podczas startu i w wątku komunikacyjnym kończy proces statusem 1, usuwa IPC oraz blokadę usługi i nie przechodzi w SIGSEGV ani SIGABRT. Patrz: Przepływ danych i sterowania. |
fncall_runtime_case | Wykonanie funkcji matematycznych zapisanych formami dopuszczonymi przez gramatykę, w tym Sqrt, Ceil i Floor; test sprawdza wartości w runtime, nie tylko poprawną kompilację. Patrz: Wyrażenia pól i funkcje skalarne. |
index_wildcard_mixed | Rozwinięcie [_] jako jednej pozycji mieszanej listy SELECT: zachowanie kolejności pól przed i po rozwinięciu, dwa niezależne rozwinięcia oraz zgodność układu payloadu z ręcznym wzorcem. |
adhoc_parse_error | Błędna składnia, kilka instrukcji, literał poza zakresem, zerowy interwał i inne niepoprawne wartości są odrzucane z powodem bez zatrzymania serwera ani zmiany planu. Dotyczy to także deklaracji LET i odwołań ?NAZWA, których kanał ad hoc nie przyjmuje. |
adhoc_rule | Dołączenie RULE ... DO DUMP w locie, granica dostępnej historii oraz odrzucenie DO SYSTEM i zbyt głębokiego zakresu dla magazynu MEMORY. |
issue202_hash_shift_e2e | Wykonawcza weryfikacja tożsamości (A>2)#(B>1) = (A#B)>3 dla ΔA=0,1 i ΔB=0,2: niezależne źródła tekstowe, identyczność fizycznych strumieni matched i CC oraz porównanie z sekwencją wyliczoną z formuły przeplotu. Patrz: Substraty. |
issue113_meta_internal | Struktura pliku sidecar .meta: rozmiar nagłówka (8 B), rozmiar wpisu (18 B), interwał próbkowania, bitsety null dla rekordów z null i bez. Patrz: Format zapisu danych - Pliki. |
issue113_meta_xtrdb | Weryfikacja przez xtrdb że po uruchomieniu xretractor+xqry plik .meta powstaje i jest raportowany poprawnie (meta: temp/str_null.meta). Patrz: Format zapisu danych - Analiza artefaktów. |
issue113_null_skip | Flaga -n w xqry - wiersze w całości null są pomijane; bez flagi wszystkie wiersze (łącznie z all-null) muszą być obecne. Patrz: Opcje wywołania - xqry. |
issue113_null_xqry | Null przesyłane przez IPC: wartości null z pliku źródłowego wyświetlane jako null w wyjściu xqry. Patrz: Opcje wywołania - xqry. |
issue121_isnull | Funkcja isnull(field) - zwraca 1 gdy pole jest null, 0 gdy nie jest. Patrz: Wyrażenia pól i funkcje skalarne. |
issue121_null_propagation | Propagacja wartości null przez SELECT do strumienia wynikowego. Patrz: Polecenie SELECT. |
issue128_numeric_to_string | Konwersja INTEGER/FLOAT do STRING funkcją to_string() z deklaracją szerokości pola; weryfikacja deskryptora wynikowego. Patrz: Wyrażenia pól i funkcje skalarne. |
issue128_string_to_numeric | Konwersja STRING do typów numerycznych: to_integer(), to_float(), to_double(); propagacja null przez konwersję. Patrz: Wyrażenia pól i funkcje skalarne. |
issue167_dedup_cascaded | Kaskadowe wchłanianie substratów przez deduplicateSubstrats() - wieloetapowe przepisywanie tokenów PUSH_ID. Patrz: Substraty. |
issue167_dedup_field_names | Deduplikacja substratów bez porównania nazw pól schematu - scalanie gdy typy pól są równoważne, niezależnie od nazw. Patrz: Substraty. |
issue167_dedup_nonzero_offset | Aktualizacja PUSH_ID w lSchema konsumenta przy niezerowym offsecie wchłanianego substratu; pokrycie ścieżki w compiler.cpp. Patrz: Substraty. |
issue167_dedup_positive | Podstawowy przypadek deduplikacji: substrat scalany z nazwanym strumieniem o równoważnym programie i typach pól. Patrz: Substraty. |
issue167_triarg | Wieloargumentowe wyrażenia strumieniowe: s1+s2+s3, (s1#s2)#s3, s1+(s2#s3), s1+s2+s3+s4; substraty pamięciowe i dyskowe. Patrz: Substraty, Sekwencjonowanie operacji. |
issue217_client_diag_stderr | Diagnostyka xqry musi trafiać na stderr, a nie na stdout. Wywołanie przy braku serwera kończy się kodem niezerowym i niepustym stderr - bez tego przekierowanie >/dev/null 2>err czyniło każdą awarię klienta niewidoczną. Patrz: Opcje wywołania - xqry. |
issue227_join_alignment | Rozdzielenie początku logicznego od ogona. Wariant run sprawdza wypisywane przez kompilator origin= i tail= oraz treść złączenia okna z jego źródłem; wariant adhoc-origin - że zapytanie dołożone w locie zaczyna od slotu, w którym zobaczył je runtime. Wartości oczekiwane wyprowadzone z definicji operatorów. Patrz: Ogony, początki logiczne i obserwowalność operatorów, Zapytania Ad hoc. |
issue42_rule | Polecenie RULE - warunkowe akcje DUMP i SYSTEM wyzwalane na wartościach strumienia; uruchamia xretractor i odczytuje wynik przez xtrdb. Osobny wpis -dump rozkłada pliki temp/str1_*_dump*.tmp na wartości INTEGER i porównuje je ze wzorcem - przypina stan faktyczny, razem z wiodącymi zerami, które DO DUMP -5 zapisuje nad strumieniem młodszym niż sześć rekordów. Patrz: Polecenie RULE. |
k19_boundaries | Granice obserwowalności operatorów: okno do przodu i wstecz, różnica o interwale równym i dwukrotnym, redukcja .sumc. Rozróżnia prawdziwy NULL wewnątrz pełnego okna od wewnętrznego rekordu all-null zwracanego jako bezpiecznik przy odczycie poza historią. Patrz: Ogony, początki logiczne i obserwowalność operatorów. |
k24_capacity | Głębokość historii dla operatorów czytających w przód. Różnice o ilorazie całkowitym ≥ 3 dawały wcześniej strumień poprawnej długości złożony wyłącznie z rekordów all-NULL (cichy defekt), a łańcuch okna, przesunięcia i przeplotu kończył się przerwaniem procesu w storage::revRead. Patrz: Przebiegi kompilacji. |
k24h10_exact_tails | Granice emisji dla różnicy oraz obu rozplotów, także nad źródłami o niezerowym ogonie. Liczba i treść rekordów chronią dokładne reguły fazowe przed przedwczesną lub opóźnioną emisją. Patrz: Ogony, początki logiczne i obserwowalność operatorów. |
let_constants | Stałe LET i odwołania ?NAZWA we wszystkich kontekstach liczbowych. Para planów „literały / LET” daje bajtowo równe wydruki xretractor -c (tekst, CSV, DOT) oraz bajtowo równe pliki strumieni, deskryptory i zrzuty DUMP po przebiegu na tych samych danych. Patrz: Polecenie LET. |
let_typed | Jawny typ stałej LET (#547). Stała DOUBLE nad polem DOUBLE obok stałej 0.1 bez adnotacji (FLOAT) - różnica widoczna w osobnym polu; stała RATIONAL w wyrażeniu nad polem INTEGER daje pole RATIONAL; stała UINT 3000000000 w RULE ... WHEN nad polem UINT, z licznikiem VAR trafień. Wartości i typy pól z .desc wobec wyroczni oracle.py. Patrz: Polecenie LET. |
var_read | VAR bez SET jest równoważna LET w wyrażeniach skalarnych; typy, programy i wyniki pozostają zgodne. |
var_set | Histereza, licznik, EMA i przeskalowane uc10/uc11/uc12/uc14 porównywane z niezależną wyrocznią Pythona od początku przebiegu; zapis od następnego slotu, konflikty według kolejności reguł, NULL i dwa identyczne przebiegi offline. |
var_reset | Utrata stanu zatrzasku po ponownym wczytaniu planu i powrót dopiero po nowym przekroczeniu progu. |
var_adhoc | Odczyt VAR i dołączanie DO SET w locie, pierwszeństwo późniejszej reguły, odmowy bez zmiany stanu oraz reset bez przecieku nazw i wartości. |
var_xqry | xqry –vars przed pierwszym slotem i po SET; INTEGER, FLOAT, RATIONAL, NULL, YAML, odmowa JSONL oraz puste listy dla planu bez VAR i instancji bez planu. |
var_typed | Jawny typ VAR: licznik UINT zerowany literałem, akumulator DOUBLE nad polem DOUBLE i próg RATIONAL przywracany literałem 0.1 (dokładnie 1/10), porównane z wyrocznią Pythona; dwa przebiegi bajtowo równe i typy z adnotacji w xqry –vars. |
noclock_offline | Równoważność artefaktów i logicznej osi czasu między wykonaniem taktowanym a --no-clock, razem z odrzuceniem połączenia --no-clock --realtime. Patrz: Opcje wywołania - xretractor. |
multiserver_named | Dwie nazwane instancje, rozłączne blokady i IPC, wszystkie formy --name, automatyczne nazwy oraz niezależne zatrzymanie. |
multiserver_no_clobber | Przegrany start tej samej instancji nie kasuje artefaktów właściciela i raportuje jego PID. |
multiserver_routing | Automatyczny routing strumieni, ad hoc i RULE, odmowa przekroczenia granicy serwerów, lista magistrali oraz oczekiwanie na właściwą instancję. |
multiserver_uniqueness | Atomowa unikalność nazw strumieni, plików magazynu i licznika rotacji przy starcie, ad hoc, dostarczaniu do usługi i konkurencyjnych uruchomieniach. |
null_divide_by_zero | Dzielenie przez zero jest wartością pochłaniającą: strumień oddaje NULL i pracuje dalej. Istotą testu jest rekord następujący po dzieleniu - gdyby brak wyniku był obsługiwany wyjątkiem, nigdy by nie powstał. Patrz: Wyrażenia pól i funkcje skalarne. |
issue56_timeshift | Operator filtra > na połączonych strumieniach - do wynikowego strumienia trafiają tylko rekordy spełniające warunek. Patrz: Polecenie SELECT - Sekwencjonowanie. |
issue61_tmpmem | Substrat pamięciowy SUBSTRAT 'memory' - dane pośrednie przechowywane w RAM zamiast na dysku. Patrz: Typy STORAGE. |
issue6_adhoc | Tryb zapytania ad-hoc: xqry -a 'SELECT ...' - definicja i wykonanie zapytania w locie bez pliku .rql. Patrz: Zapytania Ad hoc. |
operations | Operator # (HASH merge) dwóch strumieni o różnych rate - weryfikacja stosunku liczby rekordów w wyjściu. Patrz: Sekwencjonowanie operacji przeplotu. |
optimizer_ablation | Wariantowe budowanie z wyłączanymi regułami optymalizatora. build-info sprawdza tożsamość zgłaszanej konfiguracji binarki, plan - kształt planu, a pozostałe warianty (semantic, factor-*, dedup-*) porównują wynik wykonania między konfiguracjami. Każda dopuszczalna konfiguracja optymalizatora musi zachować obserwowalny wynik. Patrz: Budowanie produkcyjne i warianty diagnostyczne. |
packaging | Kontrola dokładnej zawartości pakietu DEB (jeśli dostępne jest dpkg-deb): trzy binaria, jednostka systemd, licencja, domyślny TOML i przykłady konfiguracji. Osobno kontroluje portable TGZ: trzy binaria, licencję i domyślny TOML, ze ścieżkami względnymi i bez usługi. Pakiet źródłowy jest wyłączony i nie jest badany. Patrz: Budowanie produkcyjne i warianty diagnostyczne. |
r1_identity_nulls | Tożsamość R1 dla planu przepisanego, nieprzepisanej lewej strony i jawnej prawej strony: równość origin=, payloadu oraz mapy NULL w .meta. Strona nieprzepisana ma ogon ściśle większy - R1 zachowuje ciąg rekordów, nie opóźnienie - więc jej porównanie obejmuje wspólny prefiks. Przypadek ΔA/ΔB=3/2 chroni maksimum fazowe własnego ogona #. Patrz: Substraty. |
replay_stability | Powtórzenie tego samego planu na tych samych danych musi wytworzyć identyczny zestaw niepustych artefaktów: payloady, deskryptory, mapy NULL i pliki cienia; z metadanych pomijany jest wyłącznie 8-bajtowy nagłówek zarezerwowany. Patrz: Odtwarzanie strumienia, Format zapisu danych. |
rotation_test | Mechanizm rotacji plików binarnych strumieni (ROTATION) - liczba plików po dwóch cyklach xretractor -m 2. Patrz: Mechanizm rotacji. |
select_cse_commutative_add | Współdzielenie równoważnych obliczeń SELECT dla a+b i b+a: jeden STREAM_SELECT_*, zachowanie osobnych publicznych artefaktów i deskryptorów, identyczność danych oraz metadanych NULL. Test chroni też SELECT *, kolejność projekcji i kontrprzykład ze zmianą grupowania trzech źródeł. Patrz: Substraty. |
service_delivery | Przekazanie zestawu do działającej usługi: właściwy wybór celu, zapis planu startowego, odmowa przy kolizji z inną instancją oraz uruchomienie osobnej instancji po podaniu --name lub --autoname. |
service_idle | Tryb usługowy i bezczynny: start bez pliku .rql przechodzi czysto, a dziennik trafia na stderr w formacie sd-daemon (prefiks priorytetu, bez znacznika czasu). Dwa warianty włączenia - flagą --service i zmienną XRETRACTOR_SERVICE. Patrz: Perspektywa ogólna, Opcje wywołania - xretractor. |
service_reset | Dwufazowe zastąpienie pełnego planu, zachowanie starego planu po odmowie, przejście do i ze stanu bezczynnego oraz zapis planu startowego usługi. Obejmuje też granicę DO SYSTEM: plan z taką regułą jest odrzucany w całości, odmowa nazywa regułę i powód, reguła się nie wykonuje, a stary plan liczy dalej - i ten sam plan wchodzi, wraz z działającą regułą, gdy konfiguracja unrestricted.toml ustawia service.unrestricted = true. |
service_reset_double | Dwie kolejne wymiany planu tej samej instancji i poprawne odtworzenie zasobów kolejnej epoki. |
service_reset_race | Konkurencyjne resetowanie i polecenia klienta nie widzą częściowo rozebranego ani częściowo aktywnego planu. |
show_handler_failure | Awaria serwerowej obsługi subskrypcji show dociera do klienta jako bezpośrednia przyczyna odmowy, zamiast ujawnić się dopiero jako timeout oczekiwania na kolejkę odpowiedzi. |
simple | Dymny test arytmetyki na połączonych strumieniach (core0 rate 0.1 + core1 rate 0.2) z odczytem przez xtrdb. Patrz: Polecenie SELECT. |
simple_max | Zgodna wstecz, wygaszana notacja .max - wartość maksymalna i złączenie z oryginalnym strumieniem. Patrz: Operatory agregujące. |
slot_schedule | Harmonogram slotów względem stałej kotwicy, mierzony po chwilach pojawiania się rekordów w magazynie: praca slotu krótsza od okresu (czekanie na pusty DEVICE i reguła DO SYSTEM) nie powoduje narastania opóźnienia, także z --realtime; po pojedynczym przestoju zaległe sloty idą bez snu, wykonanie wraca na pierwotną siatkę, a artefakty BINFILE i DEVICE są bajtowo równe przebiegowi --no-clock; nowa epoka po --reset ma własną kotwicę; import ad hoc nowej szybkości nie przesuwa osi; SIGTERM w trakcie snu kończy przebieg od razu, bez slotu przed terminem. Wariant -vg- pod Valgrindem (dryf i nadrabianie, okres 1/4 s). Patrz: Algorytm przeglądu drzewa zapytań. |
source_kinds | Rodzaj źródła ze słowa kluczowego, nie ze ścieżki: BINFILE 'ascii.txt' czyta surowe bajty, TEXTFILE 'values.dat' parsuje tekst z tokenem NULL, DEVICE na FIFO o nazwie .txt czyta surowe bajty, a bajt zero nie jest NULL. Odmowy rodzaju pliku (FIFO bez pisarza, urządzenie znakowe, zwykły plik dla DEVICE) z kodem 71 i bez zawieszenia. Forma przestarzała FILE daje bez --verbose wyjście identyczne z jawnymi słowami, a z --verbose jedno ostrzeżenie na deklarację - także przy imporcie ad hoc. Deskryptor źródła: dawny TYPE DEVICE pliku binarnego zastępowany, zmiana rodzaju albo ścieżki odrzucana. Wariant -vg- pod Valgrindem. Patrz: Polecenie DECLARE. |
stream_generator | Generator SELECT ... STREAM cell[N]: wykonanie rodziny odpowiada ręcznie rozpisanym strumieniom, instancje mają nazwy cell$0…cell$(N-1), a sprzątanie usuwa artefakty całej rodziny. Patrz: Polecenie SELECT - Generatory strumieni. |
string_field_passthrough | Tekst bez cudzysłowów ze źródła TEXTSOURCE, wyrównanie sąsiednich pól, przycięcie do STRING[N], propagacja typu i rzeczywista wartość Length. Patrz: Wyrażenia pól i funkcje skalarne, Przebiegi kompilacji. |
tty_keystroke_immunity | Bajt oczekujący na pseudoterminalu nie może skrócić wykonania xretractor --llimitqry N; przebieg pod TTY ma wytworzyć tyle samo danych co przebieg bez terminala. |
untileof_stop | --until-eof odpowiada ręcznie ograniczonemu źródłu ONESHOT, nie zawija pliku i przy wielu źródłach zatrzymuje się na pierwszym wyczerpanym. Wariant it_untileof_stop-missing-sources (#488) sprawdza TEXTFILE, BINFILE i DEVICE: brak pliku lub katalogu nadrzędnego, składnik ścieżki niebędący katalogiem, zerwane dowiązanie oraz brak uprawnień (dla konta bez uprawnień roota). Z -u i w przebiegu ograniczonym -m wymaga zakończenia kodem EIO w limicie 5 s, komunikatu z przyczyną, niezmienionych poprzednich wyników i braku serii ostrzeżeń odczytu. Sprawdza też -c bez dostępnego źródła oraz zniknięcie wejścia po kontroli wstępnej, przed budową modelu: kod EIO bez zapisanych rekordów wyniku. Patrz: Opcje wywołania - xretractor. |
wide_from_names | Szeroka klauzula FROM po przekroczeniu progu 200 bajtów używa stabilnej skróconej nazwy substratu, nie przekracza NAME_MAX, zachowuje deduplikację i wykonuje redukcję SUMC nad oknem poprawnie. Patrz: Substraty. |
window_aggregate | Agregaty MIN/MAX/AVG/SUMC(wyrażenie : W) po historii rekordów: wartości, typy, brzegi, tablice, wyrażenia, wspólne grupy, NULL, null2zero i propagacja schematu przez kopię. Patrz: Operatory agregujące. |
xqry_array_row | Pełna serializacja liczbowego pola tablicowego przez xqry: wszystkie elementy i ich kolejność w formatach raw, Graphite oraz InfluxDB, bez ograniczenia liczby wartości do liczby wpisów deskryptora. Patrz: Opcje wywołania - xqry, API monitorowania strumieni. |
xqry_elem_limit | Parametr -m N w xqry - limit liczby odebranych rekordów do dokładnie N, niezależnie od długości źródła. Patrz: Opcje wywołania - xqry. |
xqrywait_gate | Bramka --xqrywait nie gubi pierwszego polecenia, nie zeruje budżetu --llimitqry i daje się przerwać sygnałem przed nadejściem klienta. |
Nowsze scenariusze regresyjne
| Nazwa testu | Opis |
|---|---|
adhoc_register_rollback | Wymuszony błąd statusowy i osobny wariant -throw z wyjątkiem po imporcie przywracają plan i roszczenia magistrali; klient otrzymuje przyczynę, serwer nadal liczy, a ponowione zapytanie daje dane. |
hash_string | Przeplot pól STRING o różnych szerokościach i pól INTEGER/DOUBLE, w obu kolejnościach źródeł oraz przez ad hoc. Wariant -adhoc-zero-step dołącza źródło przed krokiem zerowym przez bramkę -x i sprawdza inicjalizację jego bazy logicznej. |
expr_corpus | Plany wyrażeń, w tym typy mieszane, napisy i granice przepełnienia, sprawdzają wartości i typy wobec wzorców oraz niezależnej wyroczni. Wyrocznia czyta także binarne FLOAT/DOUBLE i zawartość zrzutów DUMP; own_rules obejmuje prawdziwe i fałszywe warunki reguł, precyzję liczb rzeczywistych oraz granice UINT. |
ipc_client_killed_reading | Śmierć klienta podczas odczytu odpowiedzi nie blokuje kolejnych komend. |
issue252_missing_stream | Żądanie nieznanego strumienia zwraca odmowę, a serwer nadal emituje rekordy. |
rule_string_compare | Porównania napisów oraz warunek z samym napisem w RULE WHEN uruchamiają reguły we właściwych slotach. |
xtrdb_engine_guard | xtrdb odmawia przy żywej instancji nazwanej, także z własnym paths.lock_dir, lecz dopuszcza porzucony plik blokady. FIFO w katalogu blokad nie zawiesza narzędzia. Nieczytelny plik powoduje odmowę cannot verify bez zmiany magazynu; ten przypadek jest jawnie pomijany dla roota. |
xtrdb_lost_lock | xtrdb odmawia przy żywym silniku, którego plik blokady skasowano lub podmieniono, i pisze ponownie po jego zatrzymaniu (#573). |
expr_result_types | Typy i rozmiary pól wynikowych, wartości ułamkowe, NULL oraz kopiowanie schematu przez SELECT *. |
field_ref_outside_from | Odrzucenie odwołania do pola strumienia spoza FROM i poprawność odwołania przez pole strumienia wynikowego. |
reducer_field_ref | Odrzucenie nazwy reduktora jako pola w SELECT oraz odczyt wyniku przez zmaterializowany strumień. |
reducer_float_max_avg_count | MAX nad ujemnymi FLOAT i DOUBLE oraz AVG nad rekordami o 256 i 257 polach. |
self_ref_field_shape | Typ pola wskazanego własną nazwą strumienia pochodzi z odpowiedniego slotu rekordu FROM. |
self_ref_simplify_synth | Typy slotów wejściowych okna i reduktora chronią obliczenia FLOAT przed błędnym uproszczeniem stałych. |
self_ref_simplify_type | Odwołanie własną nazwą w wyrażeniu podlegającym uproszczeniu używa typu slotu FROM, a nie typu pola wyjściowego. |
silent_arith_overflow | Przepełnienie arytmetyki INTEGER i RATIONAL w wyrażeniach i reduktorach daje NULL zamiast zawiniętej liczby. |
synth_node_output_shape | Typy pól wyjściowych po oknie, redukcji i złączeniu odpowiadają rzeczywistym slotom wejściowym. |
xqrywait_first_row | Pierwszy rekord nie ginie między otwarciem bramki --xqrywait a utworzeniem kolejki subskrypcji xqry. |
Scenariusze kompilacyjne i offline
Poniższe katalogi rejestrują przede wszystkim warianty kompilacji, prezentacji planu albo operacji na artefaktach. Część z nich jest ta sama co w tabeli wykonawczej, ponieważ jeden CMakeLists.txt może rejestrować kilka niezależnych wpisów CTest.
| Nazwa testu | Opis |
|---|---|
Data | Kompilacyjna strona wspólnego zestawu Data (pliki dzielone z wariantem sekwencyjnym): on-query - kompilacja zapytania referencyjnego, presenter - prezentacja planu po tej kompilacji, banned-artifacts - strażnik sprawdzający, że w katalogu instalacyjnym nie powstał artefakt o zakazanej nazwie kolidującej z narzędziami systemowymi. Patrz: Kompilacja i budowa planu. |
dsp | Regresja kompilacyjna dla zwartego potoku filtra FIR: okno source@(1,25) bezpośrednio w FROM, 25-elementowe rozwinięcie source[_] * filter[_], redukcja SUMC(accRow) oraz złączenie sygnału i wyjścia. Patrz: Implementacja filtru sygnałowego, Przetwarzanie symbolu _. |
issue113_meta | Operacje xtrdb po dwóch append - lista rekordów i hexdump pliku binarnego porównywane ze wzorcem. Patrz: Format zapisu danych - Analiza artefaktów. |
issue113_meta_autocreate | Automatyczne tworzenie pliku sidecar .meta po pierwszym append; rozmiar >16 B; xtrdb raportuje poprawną ścieżkę. Patrz: Format zapisu danych - Pliki. |
issue113_null_txtsrc | Komendy rread/getpos w xtrdb na strumieniu TEXTSOURCE zawierającym null. Patrz: Format zapisu danych - Analiza artefaktów. |
issue153_storagemap_meta_cases | Mapa składowania xtrdb -s dla pliku zwykłego i retractordb-style: znaczniki slotów, lista segmentów, pliki rotowane, referencje .meta/.shadow. Patrz: Narzędzie inspekcji xtrdb -s. |
issue202_hash_shift_factorization | Algebraiczna optymalizacja (A>i)#(B>k) do (A#B)>(i+k) dla i·ΔA=k·ΔB oraz ochrona przypadku niedopasowanego. Patrz: Substraty. |
issue31_doc | Generowanie grafów DOT/SVG przez xretractor -c -d ... dla przykładów dokumentacyjnych na trzech poziomach szczegółowości. Patrz: Debugowanie kompilacji. |
issue42_rule | Kompilacja składni RULE - tylko etap -c, bez uruchamiania serwera. Patrz: Polecenie RULE. |
issue56_timeshift | Kompilacja operatora filtra > - tylko etap -c. Patrz: Polecenie SELECT - Sekwencjonowanie. |
issue61_tmpmem | Kompilacja zapytania z SUBSTRAT 'memory' - tylko etap -c. Patrz: Typy STORAGE. |
issue95_loopInCompile | Wykrywanie cykli w grafie zapytań przez kompilator - oczekiwany błąd “Circular dependency” i niezerowy kod wyjścia. Patrz: Wykrywanie pętli w kompilacji. |
issue96_no_substrat_reduction | Strumienie zdefiniowane przez użytkownika o identycznej strukturze NIE są scalane; scalaniu podlegają tylko automatyczne substraty. Patrz: Substraty. |
issue96_substrat_reference | Wygenerowany substrat współdzielony przez dwa strumienie użytkownika - poprawne referencje w drzewie zależności. Patrz: Substraty. |
Pattern1 | Kompilacja operatora # (HASH-merge), selekcji pól z przesunięciem i łączenia strumieni +. Patrz: Sekwencjonowanie operacji przeplotu i sumowania. |
Pattern2 | Kompilacja zapytań na strumieniach BYTE z /dev/urandom: SELECT, arytmetyka, łączenie strumieni. Patrz: Polecenie SELECT. |
Pattern3 | Kompilacja SELECT * (unfold) z deklaracją pliku wyjściowego i retencją. Patrz: Rozwijanie symbolu *. |
Pattern5 | Operacje xtrdb na rekordzie wielotypowym (STRING, INTEGER, BYTE, FLOAT): append, read, list/rlist, input, write. Patrz: Analiza artefaktów. |
Pattern6 | Kompilacja operatora okna @(n,m) do przodu @(1,10) i wstecz @(1,-10) + valgrind bez wycieków. Patrz: Ruchome okno danych AGSE. |
Pattern7 | Kompilacja z identycznymi nazwami pól w wielu strumieniach (issue #17) - poprawna identyfikacja pola przez indeks strumienia. Patrz: Polecenie DECLARE, Aliasowanie. |
retention | Operacje xtrdb na pliku z parametrem RETENTION: open, purge, append, list, write dla konkretnego rekordu. Patrz: Format zapisu danych - Mechanizm rotacji. |
simple | Kompilacja podstawowego zapytania arytmetycznego + graf DOT + valgrind; korzysta z danych IntegrationTest/simple. Patrz: Polecenie SELECT. |
simple_max | Kompilacja zapytania z .max + graf DOT + valgrind; korzysta z danych IntegrationTest/simple_max. Patrz: Operatory agregujące. |
subquery | Kompilacja zagnieżdżonych podzapytań: (a#b)>1 (hash-merge wewnątrz filtru) i (a>1)#b (filtr wewnątrz hash-merge). Patrz: Budowa drzewa zależności. |
txtsrc | Operacje xtrdb descc/rread/printt na strumieniu TEXTSOURCE (plik tekstowy jako źródło danych). Patrz: Format zapisu danych. |
Literatura
1. S. Beatty, “Problem 3173” American Mathematical Monthly, vol. 33, p. 159, 1926.
2. A.S.Fraenkel, „The bracket function and complementary sets of integers“ Canadian Journal of Mathematics, tom 21, pp. 6-27, 1969. (link)
3. M. Widera, „Deterministic method of data sequence processing“ Annales UMCS, Sectio AI Informatica, tom IV, pp. 314-331, 2006 (link); wersja polska: „Deterministyczna metoda przetwarzania ciagow danych“ w XXI Autumn Meeting of Polish Information Processing Society, Conference Proceedings, pp. 243-254, 2006. (pdf)
4. Z. W. Zen, „Classified publications on covering systems“ updated 2006. [Online]. Available: http://maths.nju.edu.cn/~zwsun/. (pdf)
5. T. Parr, The Definitive ANTLR 4 Reference, The Pragmatic Bookshelf, 2013. (amazon)
6. T. D. Pauw, „Swirly - A marble diagram generator.“ 2022. [Online]. Available: https://github.com/timdp/swirly. [Data uzyskania dostępu: 3 11 2025]. (link)
7. A. Staltz, „RxJS Marbles“ https://github.com/staltz/rxmarbles, [Online]. Available: https://rxmarbles.com/. [Data uzyskania dostępu: 4 11 2025]. (link)
8. „Conan.io - the Open Source C and C++ Package Manager for Developers“ JFrog, [Online]. Available: https://conan.io/. [Data uzyskania dostępu: 9 11 2025].
9. D. W. Gunness, „Creating digital signal processing (DSP) filters to improve loudspeaker transient response“. US Patent US8081766B2, 20 12 2011. (link)
10. M. Widera, „RetractorDB - separator serii czasowych“ Programista, tom 92, nr 5/2020, pp. 14-20, 6/7 2020. (ebookpoint)
11. J. Shallit, „A Generating Function Technique for Beatty Sequences and Other Step Sequences“ Journal of Number Theory, tom 64, nr 2, pp. 273-298, 1997.
12. L. Schaeffer, J. Shallit i S. Zorcic, „Beatty Sequences for a Quadratic Irrational: Decidability and Applications“ arXiv:2402.08331, 2024. (pdf)
13. M. A. Berger, A. Felzenbaum i A. S. Fraenkel, „Disjoint covering systems of rational Beatty sequences“ Journal of Combinatorial Theory, Series A, tom 42, nr 1, pp. 150-153, 1986.
14. D. Eppstein i in., „Aperiodic pinwheel scheduling using Beatty sequences“ – omówienie problemu szeregowania okresowego w oparciu o komplementarne sekwencje Beatty’ego, 2023. (link)
15. H. Fujiwara, K. Miyagi i K. Ouchi, „Pinwheel Scheduling with Real Periods“ arXiv:2510.24068, 2025 – dowody oparte na podziale Rayleigha/Beatty’ego z tożsamościami na funkcjach podłogi i sufitu. (html)
16. S. Samadi, M. O. Ahmad i M. N. S. Swamy, „Characterization of nonuniform perfect-reconstruction filterbanks using unit-step signal“ IEEE Transactions on Signal Processing, tom 52, nr 9, pp. 2490-2499, 2004. (link)
17. G. Margolis i Y. C. Eldar, „Nonuniform Sampling of Periodic Bandlimited Signals“ IEEE Transactions on Signal Processing, tom 56, nr 7, pp. 2728-2745, 2008. (pdf)
18. J. Kovačević i M. Vetterli, „Perfect Reconstruction Filter Banks with Rational Sampling Factors“ IEEE Transactions on Signal Processing, tom 41, nr 6, pp. 2047-2066, 1993.
19. S. Kalra i N. K. Shukla, „Ramanujan sums in signal recovery and uncertainty principle inequalities“ arXiv:2512.16190, 2025. (pdf)
20. A. Arasu, S. Babu i J. Widom, „The CQL continuous query language: semantic foundations and query execution“ The VLDB Journal, tom 15, nr 2, pp. 121-142, 2006. (pdf)
21. J. Krämer i B. Seeger, „Semantics and implementation of continuous sliding window queries over data streams“ ACM Transactions on Database Systems, tom 34, nr 1, pp. 1-49, 2009 (system PIPES).
22. S. K. Jensen, T. B. Pedersen i C. Thomsen, „Time Series Management Systems: A Survey“ IEEE Transactions on Knowledge and Data Engineering, tom 29, nr 11, pp. 2581-2600, 2017. (pdf)
23. K. O’Bryant, „Fraenkel’s partition and Brown’s decomposition“ Integers: Electronic Journal of Combinatorial Number Theory, tom 3, A11, 2003.
24. G. E. Pfander, S. Revay i D. Walnut, „Exponential bases for partitions of intervals“ Applied and Computational Harmonic Analysis, tom 68, art. 101607, 2024.
25. M. Widera, J. Jezewski, R. Winiarczyk, J. Wrobel, K. Horoba i A. Gacek, „Data stream processing in fetal monitoring system: I. Algebra and query language“ Journal of Medical Informatics & Technologies, tom 5, pp. 83-90, 2003.
26. E. A. Lee i D. G. Messerschmitt, „Static Scheduling of Synchronous Data Flow Programs for Digital Signal Processing“ IEEE Transactions on Computers, tom C-36, nr 1, pp. 24-35, 1987. (doi)
27. G. Bilsen, M. Engels, R. Lauwereins i J. A. Peperstraete, „Cyclo-Static Dataflow“ IEEE Transactions on Signal Processing, tom 44, nr 2, pp. 397-408, 1996.
28. A. Cohen, M. Duranton, C. Eisenbeis, C. Pagetti, F. Plateau i M. Pouzet, „N-Synchronous Kahn Networks: A Relaxed Model of Synchrony for Real-Time Systems“ w Proceedings of the 33rd ACM SIGPLAN-SIGACT Symposium on Principles of Programming Languages (POPL), pp. 180-193, 2006. (doi)
29. F. McSherry, A. Lattuada, M. Schwarzkopf i T. Roscoe, „Shared Arrangements: Practical Inter-Query Sharing for Streaming Dataflows“ Proceedings of the VLDB Endowment, tom 13, nr 10, pp. 1793-1806, 2020. (doi)
30. A. Chaudhary, J. Karimov, S. Zeuch i V. Markl, „Incremental Stream Query Merging“ w Proceedings of the 26th International Conference on Extending Database Technology (EDBT), pp. 604-617, 2023. (doi)